2 minGratis
Cómo utilizar la IA a mitad de camino: un tutorial paso a paso
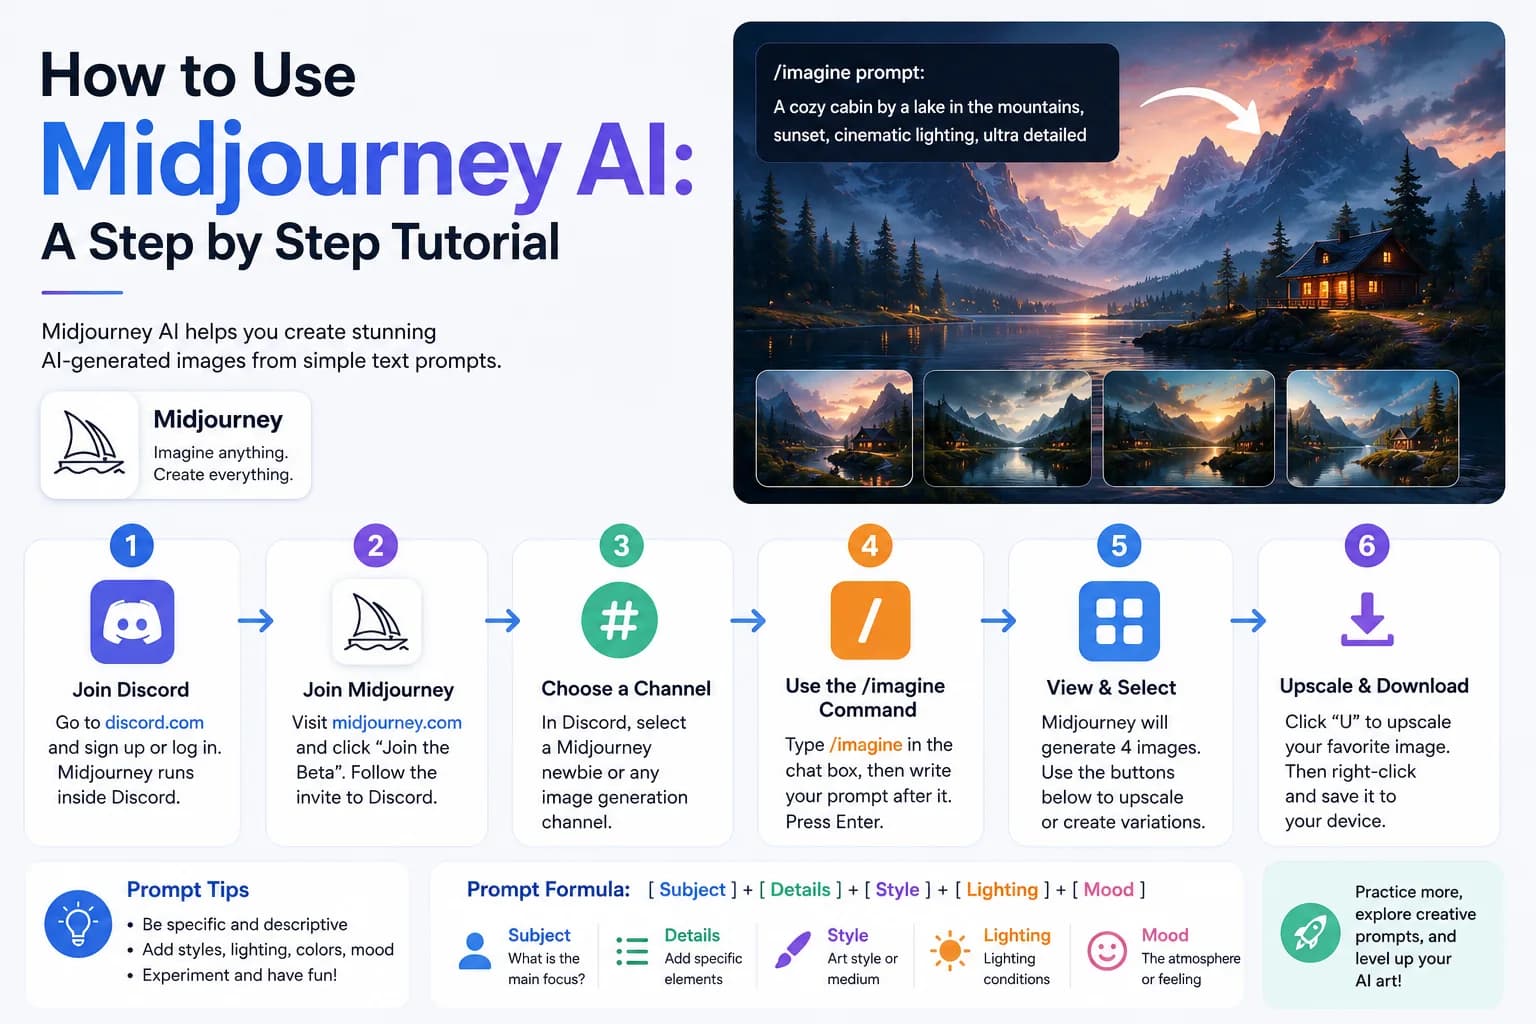
Midjourney opera a través de Discord. Vaya a midjourney.com y haga clic en "Unirse a la Beta" para acceder al servidor de Discord.
TecnologíaGuías de plataformaAITechnology
Explora tutoriales y editoriales con soporte SEO multilingüe.
57 Artículos
Midjourney opera a través de Discord. Vaya a midjourney.com y haga clic en "Unirse a la Beta" para acceder al servidor de Discord.
Analizador de protocolos de red que le permite ver cada paquete que fluye a través de su red. Esencial para comprender el tráfico de la red y detectar anomalías.
Sigue siendo el rey de los editores de código. Las extensiones, la integración de Git e IntelliSense lo convierten en la opción predeterminada para el desarrollo web, Python y la mayoría de los lenguajes.
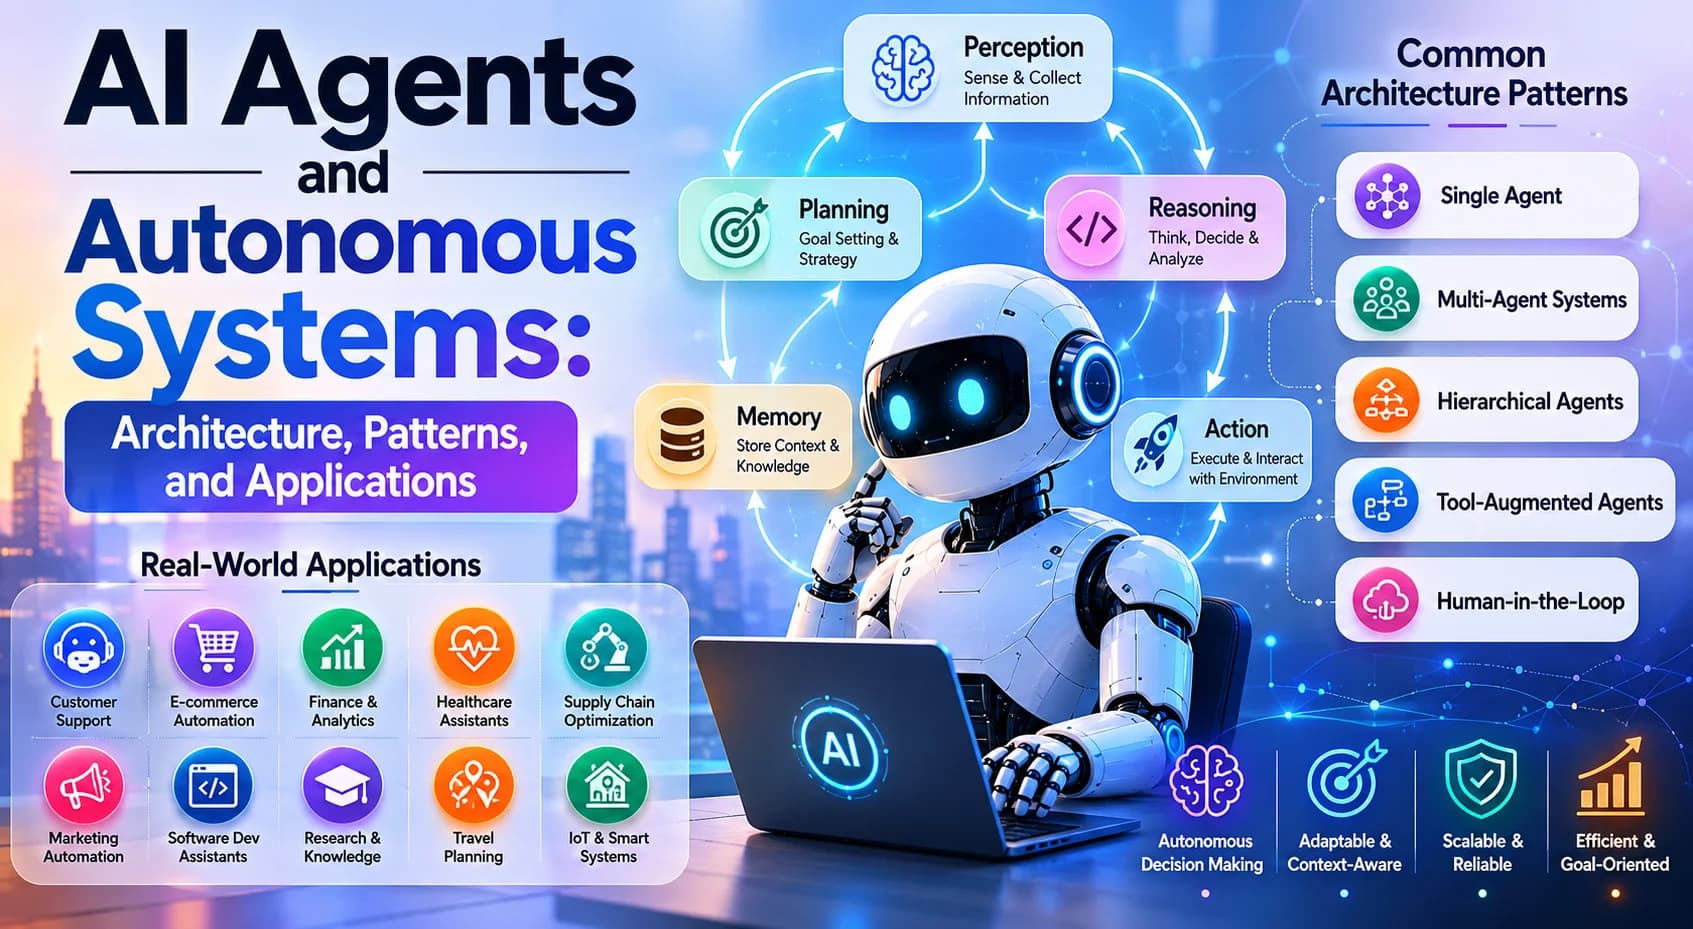
Los agentes de IA son sistemas de software autónomos que perciben su entorno, razonan sobre objetivos, toman acciones y aprenden de los resultados. A diferencia de las aplicaciones LLM tradicionales que responden a un único mensaje, los agentes operan en bucles (observando, pensando, actuando y observando nuevamente) hasta que se logra un objetivo.
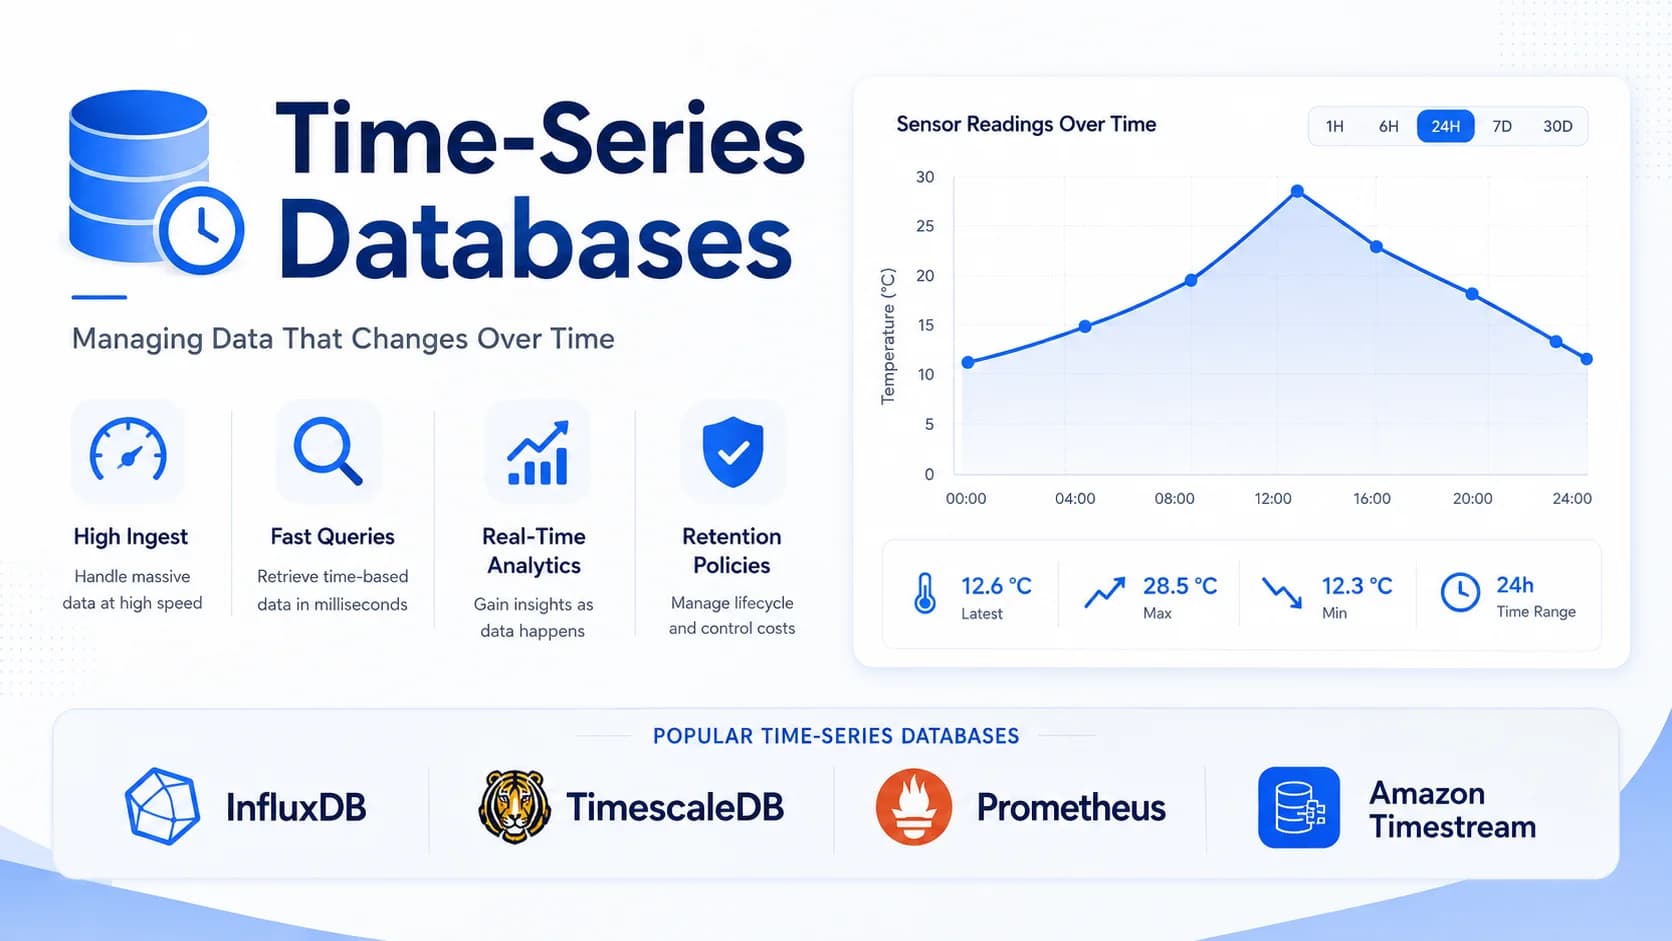
Una base de datos de series de tiempo (TSDB) está especializada en almacenar y consultar puntos de datos indexados por tiempo: lecturas de sensores, métricas de servidores, registros de aplicaciones, datos financieros y telemetría de IoT. Los datos de series de tiempo tienen características únicas que hacen que las bases de datos tradicionales no sean óptimas:
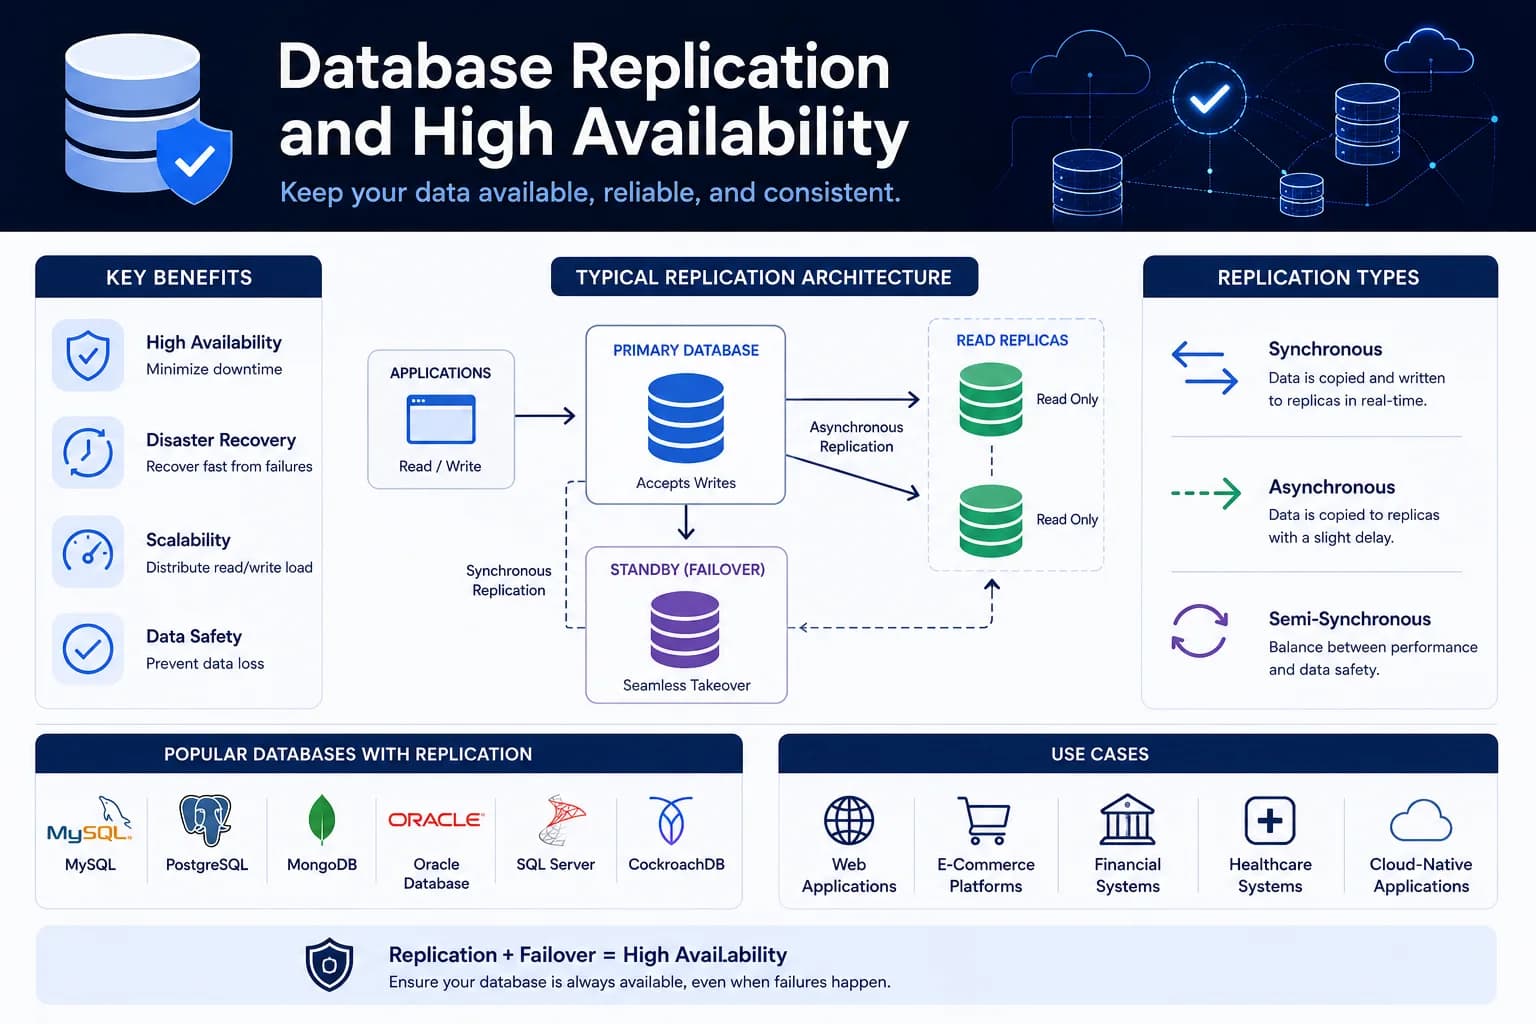
La replicación de bases de datos es el proceso de copiar y mantener datos de bases de datos en múltiples servidores. Es la base de la alta disponibilidad (HA), la recuperación ante desastres (DR), el escalado de lectura y la distribución geográfica.
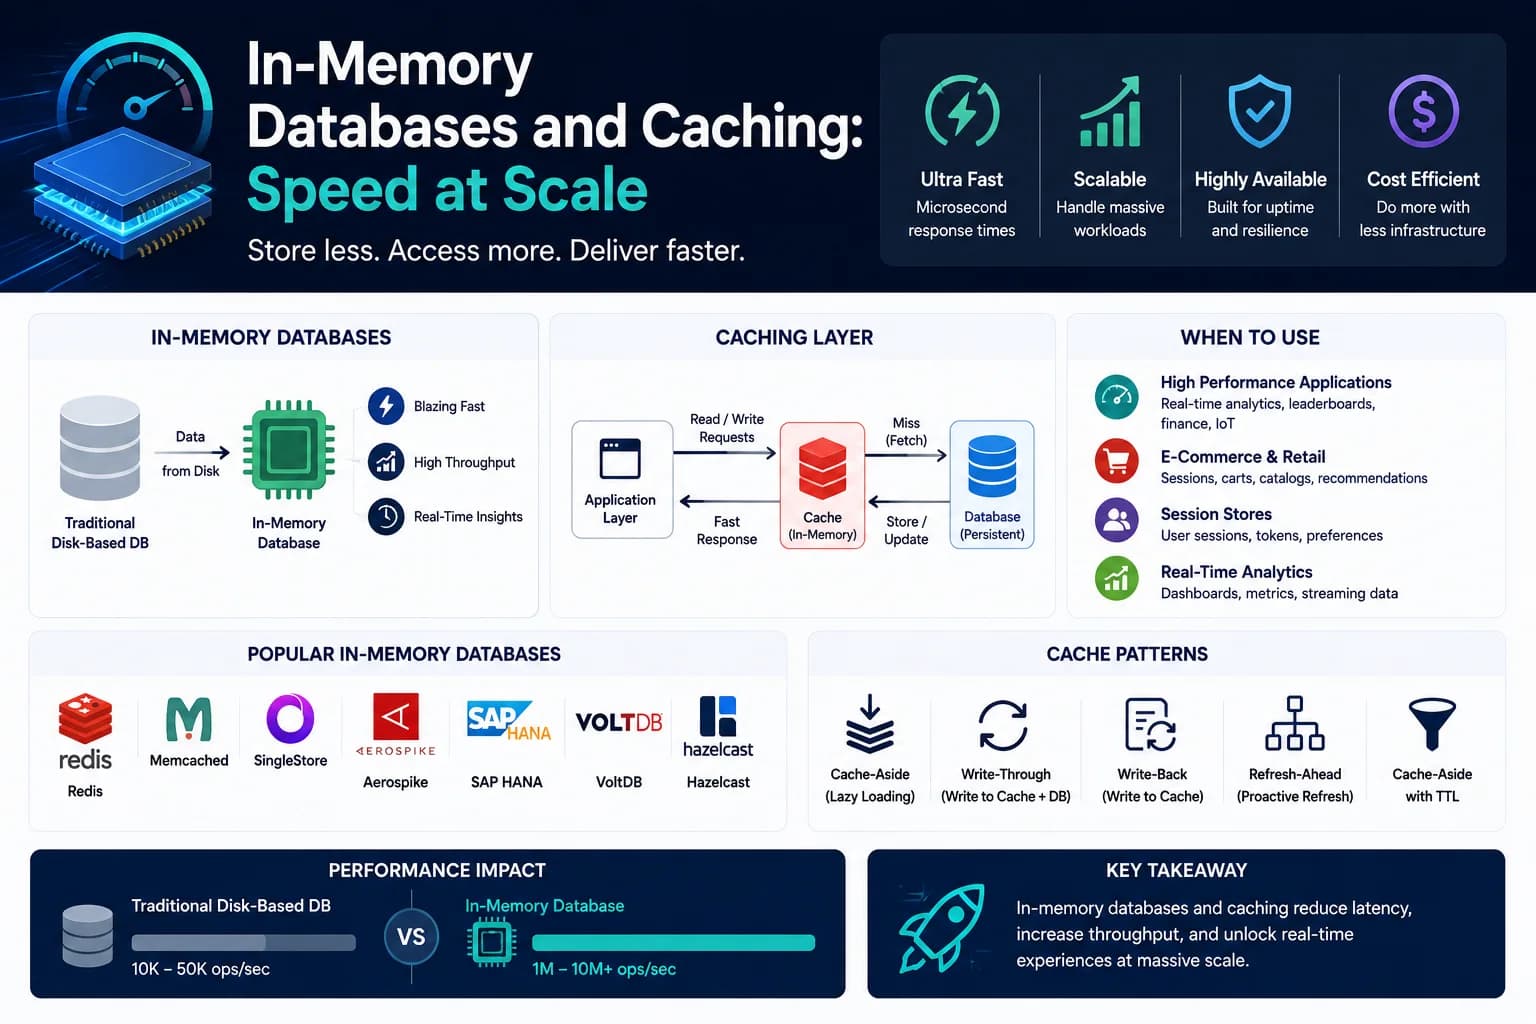
Las bases de datos en memoria almacenan datos principalmente en la RAM y no en el disco. Esto elimina la latencia de E/S del disco, proporcionando tiempos de respuesta de microsegundos, órdenes de magnitud más rápidos que las bases de datos tradicionales basadas en disco.

Las incorporaciones son la tecnología fundamental detrás de los sistemas modernos de búsqueda, recomendación y recuperación basados en IA. Una incrustación es un vector numérico denso que representa el significado semántico de los datos: texto, imágenes, audio o cualquier otra modalidad. Los elementos con significado similar tienen vectores que están muy juntos en el espacio de incrustación.
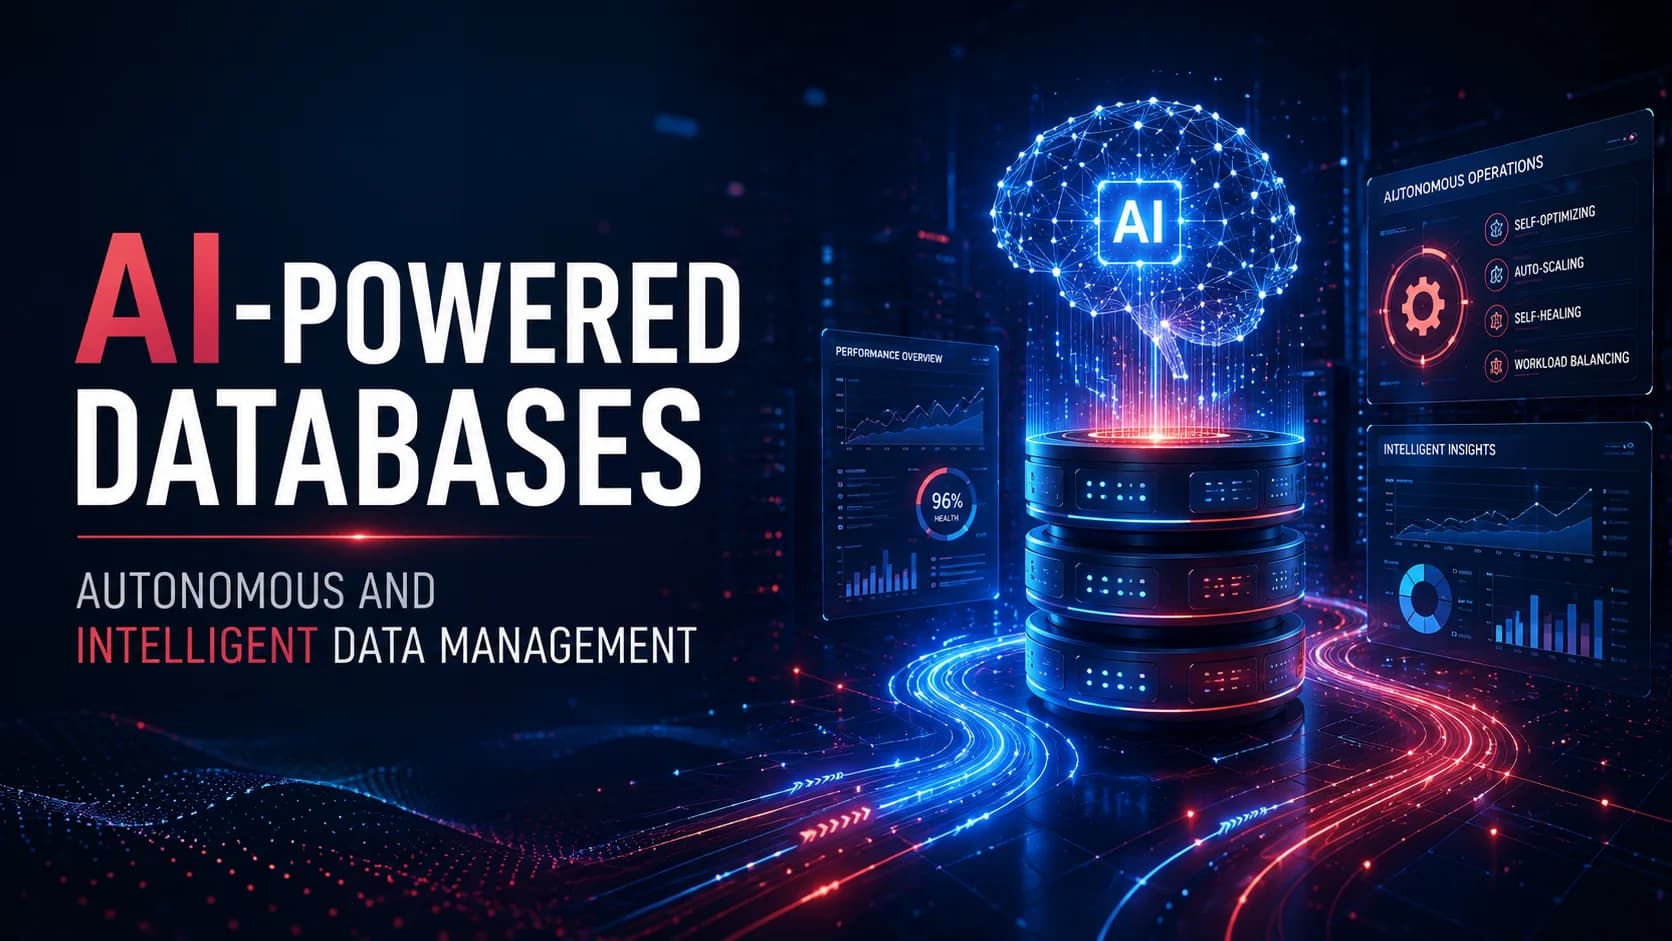
Las bases de datos están experimentando una transformación fundamental impulsada por la inteligencia artificial. Así como la IA está remodelando el desarrollo de software, también está revolucionando la forma en que se diseñan, operan y consultan las bases de datos. Esto abarca tres áreas principales:
Durante décadas, el mundo de las bases de datos estuvo dividido en dos bandos: **bases de datos relacionales** (PostgreSQL, MySQL) con una fuerte consistencia pero escalabilidad limitada, y **bases de datos NoSQL** (MongoDB, Cassandra) con escalabilidad horizontal pero una consistencia más débil y capacidades de consulta limitadas.
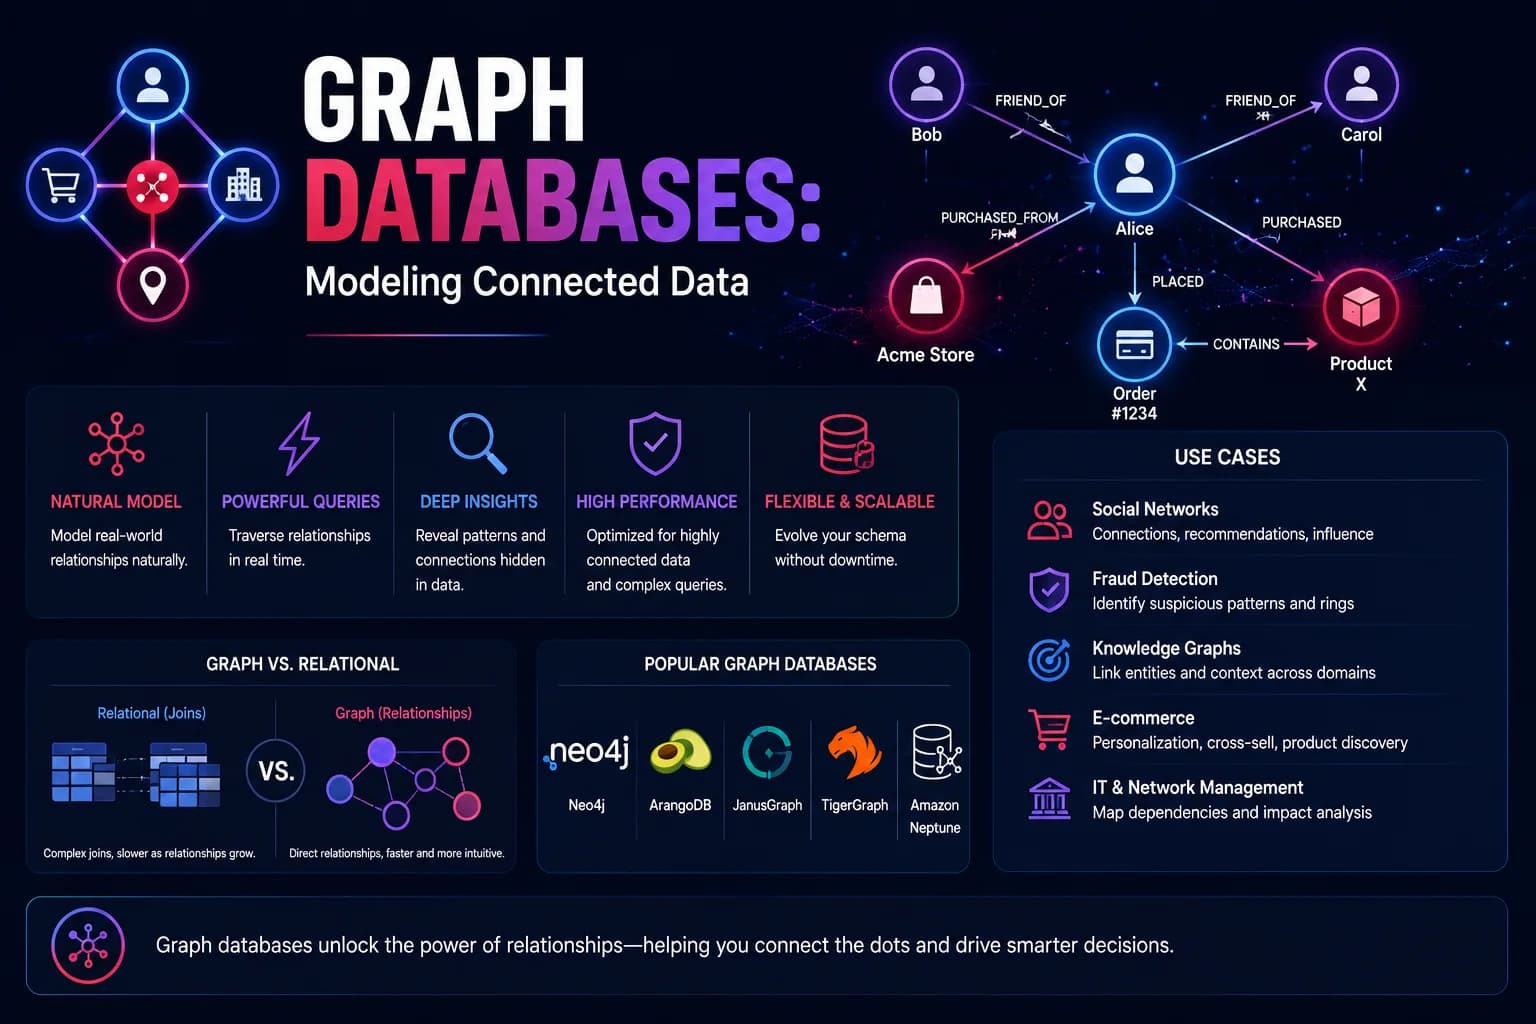
Las bases de datos de gráficos están diseñadas específicamente para almacenar y consultar datos altamente conectados. Mientras que las bases de datos relacionales destacan en datos tabulares con relaciones conocidas, las bases de datos gráficas destacan cuando las relaciones son tan importantes como los datos mismos: redes sociales, motores de recomendación, detección de fraude, gráficos de conocimiento y cadenas de suministro.

Recuperación-Generación Aumentada (RAG) es una arquitectura de IA que combina la recuperación de información con grandes modelos de lenguaje (LLM). En lugar de depender únicamente de los datos de capacitación del LLM para obtener respuestas, RAG recupera información relevante de una base de conocimientos y la proporciona como contexto para el LLM.