Agentes de IA y sistemas autónomos: arquitectura, patrones y aplicaciones
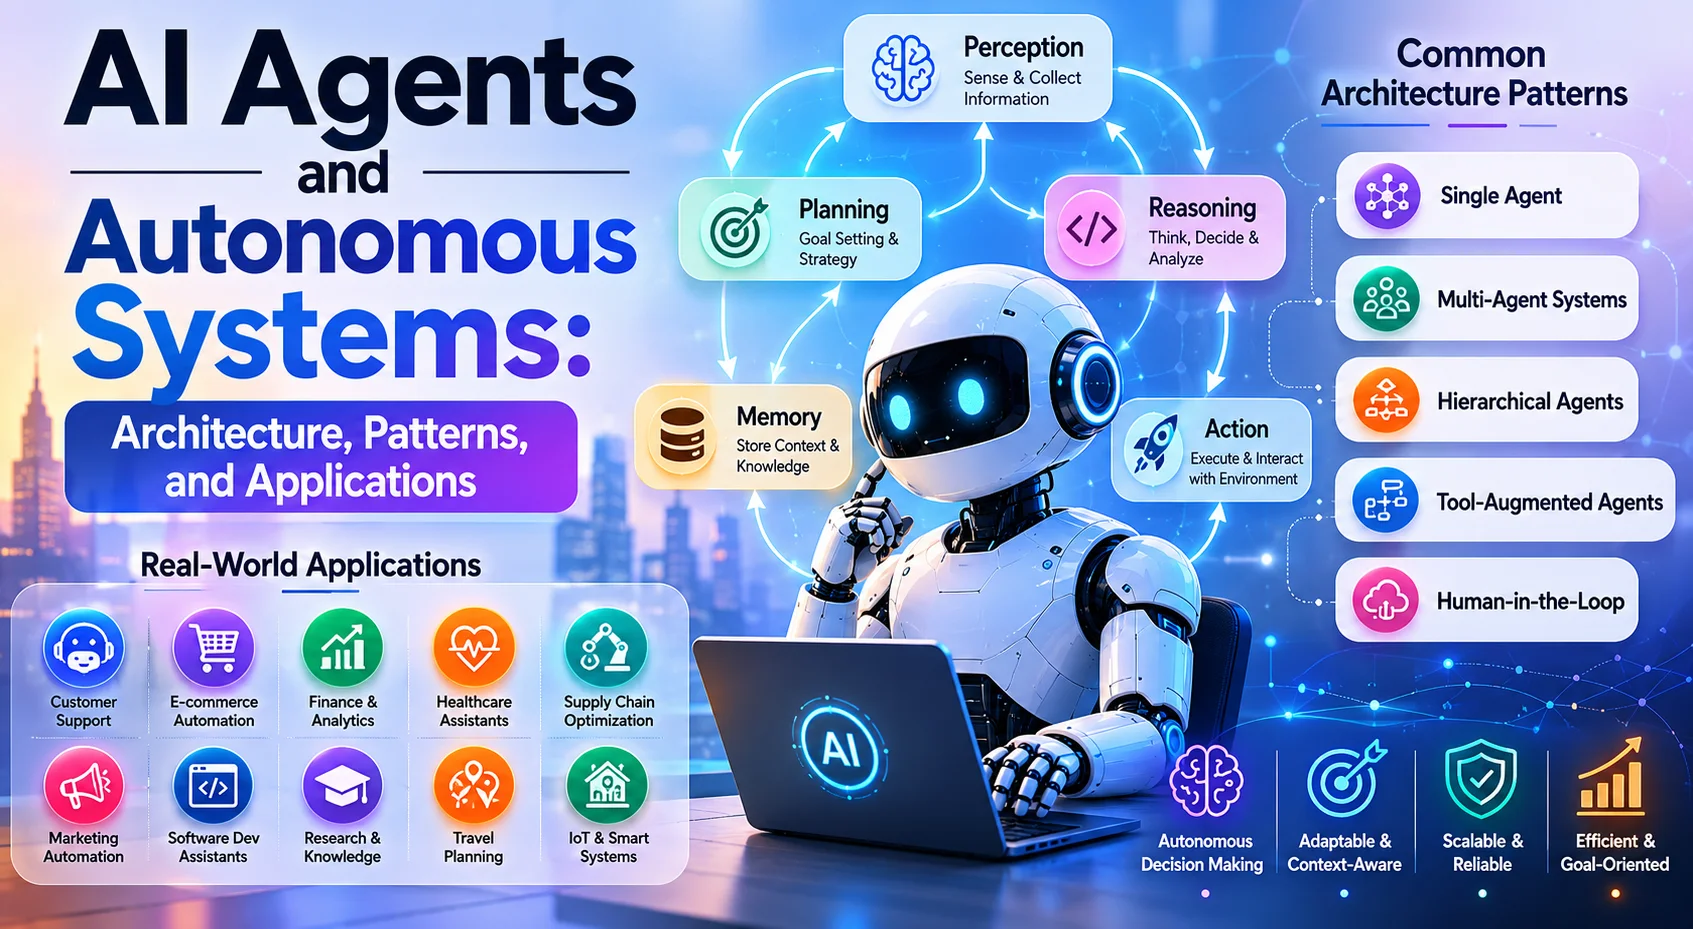
Los agentes de IA son sistemas de software autónomos que perciben su entorno, razonan sobre objetivos, toman acciones y aprenden de los resultados. A diferencia de las aplicaciones LLM tradicionales que responden a un único mensaje, los agentes operan en bucles (observando, pensando, actuando y observando nuevamente) hasta que se logra un objetivo.
Introducción
Los agentes de IA son sistemas de software autónomos que perciben su entorno, razonan sobre objetivos, toman acciones y aprenden de los resultados. A diferencia de las aplicaciones LLM tradicionales que responden a un único mensaje, los agentes operan en bucles (observando, pensando, actuando y observando nuevamente) hasta que se logra un objetivo.
En 2026, los agentes de IA representarán la frontera de la IA aplicada. Automatizan flujos de trabajo complejos de varios pasos, interactúan con herramientas y API externas, colaboran con otros agentes y toman decisiones en entornos dinámicos.
¿Qué caracteriza a un agente de IA?
Componentes principales
                   ┌──────────────────┐
                   │   Environment    │
                   │ (APIs, files,    │
                   │  databases, web) │
                   └────────┬─────────┘
                            │
Perception (observe)        │        Action (effect)
    ┌───────────────────────┼───────────────────────┐
    │                       │                       │
    ▼                       │                       ▼
┌─────────────────┐         │              ┌─────────────────┐
│   Sensors       │         │              │   Tools         │
│ (read input)    │         │              │ (call APIs,     │
│                 │         │              │  write files)   │
└────────┬────────┘         │              └────────▲────────┘
         │                 │                        │
         │          ┌──────▼──────────────────────┐ │
         └─────────►│       Reasoner (LLM)        ├─┘
                    │   (plan, decide, reflect)   │
                    └─────────────────────────────┘
                              │
                              ▼
                    ┌──────────────────┐
                    │   Memory         │
                    │ (history, state, │
                    │  learnings)      │
                    └──────────────────┘
| Componente | Descripción | Ejemplo |
|---|---|---|
| Medio ambiente | El mundo externo con el que interactúa el agente. | Web, sistema de archivos, API, base de datos |
| Sensores | Cómo el agente percibe el entorno. | Leer archivo, respuesta HTTP, entrada del usuario |
| Razonador | El LLM que planifica y decide | GPT-4, Claude, modelo de código abierto |
| Herramientas | Acciones que el agente puede realizar | Búsqueda, calculadora, ejecución de código. |
| Memoria | Corto plazo (conversación) + largo plazo (vector DB) | Historial de chat, hechos aprendidos |
| Planificación | Dividir los objetivos en pasos | Reaccionar, planificar y resolver, árbol del pensamiento |
Arquitecturas de agentes
1. ReAct (Razonamiento + Actuación)
El patrón de agente más popular: entrelaza rastros de razonamiento con acciones:
User: "Book a flight to Paris next Tuesday for under $500"

Thought: I need to search for flights to Paris next Tuesday.
Action: search_flights(destination="Paris", date="2026-05-26")
Observation: Found flights: $450 (direct), $380 (1 stop), $520 (direct)

Thought: The $450 direct flight is under budget. I need to check if
         the user has preferences for time.
Action: ask_user("Would you like the 7:00 AM direct for $450 or
                  the 11:00 AM direct for $520?")
Observation: User prefers morning.

Thought: Booking the 7:00 AM direct flight.
Action: book_flight(flight_id="AF1234", user_id="user_42")
Observation: Booking confirmed. Reference: BK-98765.

Thought: The task is complete. Let me summarize.
Response: I booked flight AF1234 to Paris on May 26 at 7:00 AM.
          Total: $450. Booking reference: BK-98765.
class ReActAgent:
    def __init__(self, llm, tools: list[Tool]):
        self.llm = llm
        self.tools = {t.name: t for t in tools}
        self.max_steps = 20

    def run(self, task: str) -> str:
        messages = [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": task},
        ]

        for step in range(self.max_steps):
            # Reasoning step
            response = self.llm.invoke(messages)
            thought = response.content

            # Check if final answer
            if "FINAL ANSWER:" in thought:
                return thought.split("FINAL ANSWER:")[-1].strip()

            # Parse action
            action = self._parse_action(thought)
            if not action:
                continue

            # Execute action
            tool = self.tools.get(action['name'])
            if not tool:
                observation = f"Error: Unknown tool '{action['name']}'"
            else:
                try:
                    observation = tool.execute(**action['args'])
                except Exception as e:
                    observation = f"Error: {str(e)}"

            # Add to conversation
            messages.append({
                "role": "assistant",
                "content": thought
            })
            messages.append({
                "role": "user",
                "content": f"Observation: {observation}"
            })

        return "Max steps reached without completing task."
2. Planificar y resolver (descomposición)
User: "Create a monthly sales report with charts"

Plan:
1. Query database for last month's sales data
2. Clean and aggregate data by product category
3. Create bar chart of sales by category
4. Create line chart of daily sales trend
5. Generate PDF report with charts and summary

Step 1: query_database("SELECT ... WHERE month = '2026-04'")
✓ Done: 15,243 records returned

Step 2: aggregate_by_category(data)
✓ Done: 8 categories aggregated

...
3. Sistemas multiagente
Agentes especializados colaboran en tareas complejas:
                    ┌─────────────────────────┐
                    │   Orchestrator Agent     │
                    │ (decomposes tasks,       │
                    │  coordinates agents)     │
                    └────┬──────┬──────┬───────┘
                         │      │      │
              ┌──────────┤      │      ├──────────┐
              │          │      │      │          │
         ┌────▼────┐ ┌──▼──┐ ┌─▼───┐ ┌▼────────┐
         │Research │ │Code │ │Test │ │Document │
         │ Agent   │ │Agent│ │Agent│ │ Agent   │
         │(search, │ │(code│ │(test│ │(docs,   │
         │ analyze)│ │ gen)│ │ gen)│ │ reports)│
         └─────────┘ └─────┘ └─────┘ └─────────┘
Ejemplo: Desarrollo de software con múltiples agentes:
# Agent roles
agents = {
    'product_manager': Agent(
        role="Defines requirements and acceptance criteria",
        tools=[search_knowledge_base, ask_user]
    ),
    'architect': Agent(
        role="Designs system architecture and data flow",
        tools=[draw_diagram, search_documentation]
    ),
    'developer': Agent(
        role="Writes and reviews code",
        tools=[write_file, read_file, execute_code]
    ),
    'qa_engineer': Agent(
        role="Writes tests and validates functionality",
        tools=[run_tests, check_coverage, report_bugs]
    ),
}

# Orchestrator coordinates the workflow
orchestrator = Orchestrator(agents)
result = orchestrator.execute(
    "Build a REST API for user authentication"
)
Herramientas y llamadas de funciones
Definición de herramientas
from pydantic import BaseModel, Field

class SearchTool(Tool):
    name = "web_search"
    description = "Search the web for current information"

    class Parameters(BaseModel):
        query: str = Field(description="The search query")

    def execute(self, query: str) -> str:
        response = requests.get(
            "https://api.search.example.com",
            params={"q": query}
        )
        return response.text

class CalculatorTool(Tool):
    name = "calculator"
    description = "Perform mathematical calculations"

    class Parameters(BaseModel):
        expression: str = Field(
            description="Mathematical expression to evaluate"
        )

    def execute(self, expression: str) -> str:
        try:
            # Safe evaluation
            result = self._safe_eval(expression)
            return str(result)
        except Exception as e:
            return f"Error: {e}"

class DatabaseQueryTool(Tool):
    name = "query_database"
    description = "Query the sales database"

    class Parameters(BaseModel):
        sql: str = Field(description="SQL query to execute")

    def execute(self, sql: str) -> str:
        # Validate SQL (read-only queries only)
        if not sql.strip().upper().startswith("SELECT"):
            return "Error: Only SELECT queries are allowed"
        result = db.execute(sql)
        return json.dumps(result, default=str)
Registro de herramientas
class Agent:
    def __init__(self, llm, tools: list[Tool]):
        self.llm = llm
        self.tool_registry = {
            t.name: t for t in tools
        }

        # Create function descriptions for LLM
        self.functions = [
            {
                "type": "function",
                "function": {
                    "name": t.name,
                    "description": t.description,
                    "parameters": t.Parameters.model_json_schema()
                }
            }
            for t in tools
        ]

    def think_and_act(self, prompt: str) -> str:
        response = self.llm.invoke(
            messages=[{"role": "user", "content": prompt}],
            tools=self.functions
        )

        # If LLM wants to call a tool
        if response.tool_calls:
            for call in response.tool_calls:
                tool = self.tool_registry[call.function.name]
                args = json.loads(call.function.arguments)
                result = tool.execute(**args)
                # Feed result back to LLM...
Sistemas de memoria
Memoria a corto plazo (contexto de conversación)
class ConversationMemory:
    def __init__(self, max_tokens: int = 4000):
        self.messages = []
        self.max_tokens = max_tokens

    def add(self, role: str, content: str):
        self.messages.append({"role": role, "content": content})
        self._trim()

    def _trim(self):
        total = sum(len(m['content']) for m in self.messages)
        while total > self.max_tokens and len(self.messages) > 2:
            self.messages.pop(1)  # Keep system prompt
            total = sum(len(m['content']) for m in self.messages)
Memoria a largo plazo (tienda de vectores)
class LongTermMemory:
    def __init__(self, vector_store):
        self.store = vector_store

    def remember(self, fact: str, metadata: dict = None):
        """Store important facts for future reference"""
        embedding = embed_text(fact)
        self.store.insert(embedding, payload={
            'fact': fact,
            **metadata,
            'timestamp': datetime.now().isoformat()
        })

    def recall(self, query: str, k: int = 5) -> list[str]:
        """Retrieve relevant past facts"""
        query_vector = embed_text(query)
        results = self.store.search(query_vector, k=k)
        return [r.payload['fact'] for r in results]

    def consolidate(self):
        """Summarize and compress old memories"""
        old_memories = self.store.get_older_than(days=30)
        summary = summarize_texts([m.payload['fact'] for m in old_memories])
        self.remember(f"Summary of past activities: {summary}",
                       metadata={'type': 'summary'})
        self.store.delete(old_memories)
Estrategias de planificación de agentes
árbol de pensamientos
Explore múltiples caminos de razonamiento simultáneamente:
Question: "What is the best cloud provider for our startup?"

Branch 1: Cost comparison
  ├─ AWS: $X/month
  └─ GCP: $Y/month (cheaper, but fewer services)

Branch 2: Required services
  ├─ Need managed Kubernetes → all support
  └─ Need specific AI/ML → GCP has TPUs

Branch 3: Team expertise
  ├─ Team knows AWS → faster ramp-up
  └─ learning GCP → 2-3 month delay

Evaluation:
  Path AWS: high team skill, moderate cost → score 8/10
  Path GCP: lower cost, TPUs, but learning curve → score 7/10
Autorreflexión y mejora
class ReflectiveAgent(Agent):
    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.mistakes = []

    def reflect_on_failure(self, task: str, action: str, error: str):
        """Learn from mistakes"""
        reflection = self.llm.invoke(f"""
        Task: {task}
        Action taken: {action}
        Error: {error}

        Why did this fail? What should I do differently next time?
        """)
        self.mistakes.append(reflection.content)

    def plan(self, task: str) -> str:
        # Consider past mistakes when planning
        if self.mistakes:
            lessons = "\n".join([f"- {m}" for m in self.mistakes[-5:]])
            return self.llm.invoke(f"""
            Task: {task}
            Lessons from past mistakes:
            {lessons}
            Plan your approach carefully.
            """)
        return super().plan(task)
Casos de uso
1. Atención al cliente automatizada
Customer: "My order hasn't arrived and it's been 2 weeks"

Agent tasks:
1. Query order database for status
2. Check tracking API for shipment location
3. If delayed: contact shipping carrier
4. If lost: initiate refund process
5. If delivered: verify with customer

Tools needed: order_lookup, tracking_api, email_send, refund_system
2. Generación y depuración de código
Developer: "Fix the login bug — users get 401 errors after password reset"

Agent workflow:
1. Search codebase for password reset implementation
2. Identify token validation logic
3. Write a unit test reproducing the bug
4. Fix the issue
5. Run existing tests to verify no regression
6. Create PR with description
3. Asistente de investigación
class ResearchAgent:
    async def research(self, topic: str) -> Report:
        # Parallel exploration
        subtopics = self.decompose(topic)
        tasks = [self.explore_subtopic(st) for st in subtopics]
        findings = await asyncio.gather(*tasks)

        # Synthesize
        report = self.synthesize(findings)
        return report

    async def explore_subtopic(self, subtopic: str) -> Finding:
        search_results = await web_search(subtopic)
        summaries = await asyncio.gather(*[
            summarize_page(url) for url in search_results[:5]
        ])
        return Finding(subtopic=subtopic, summaries=summaries)
Desafíos y riesgos
1. Alucinaciones en acciones
El agente puede tomar con confianza acciones incorrectas:
Thought: The user asked to delete expired records.
Action: DELETE FROM users  -- (Oops, no WHERE clause!)
Mitigación:
- Verifique siempre las acciones destructivas.
- Requerir confirmación para operaciones irreversibles.
- Utilice el modo "ejecución en seco" para realizar pruebas.
2. Detección de bucle
Los agentes pueden quedarse atrapados en bucles infinitos:
class LoopDetector:
    def __init__(self, max_repeated_actions: int = 3):
        self.action_history = []
        self.max_repeated = max_repeated_actions

    def check(self, action: str, observation: str) -> bool:
        self.action_history.append({
            'action': action,
            'observation': observation
        })

        # Check for repeated patterns
        recent = self.action_history[-5:]
        if len(recent) >= 3:
            patterns = [a['action'] for a in recent]
            if len(set(patterns)) <= 2:
                print("Loop detected!")
                return True
        return False
3. Gestión de costos
Cada paso del agente cuesta dinero (llamadas LLM + llamadas API):
agent_cost_estimation:
  per_step:
    llm_call:  "$0.01"    # GPT-4o
    tool_call: "$0.001"   # Average API call
    search:    "$0.00"    # Web search

  typical_session:
    steps: 10-30
    total: "$0.10 - $0.50"

  complex_research:
    steps: 50-200
    total: "$0.50 - $5.00"
Marcos de agentes
| Marco | Idioma | Características |
|---|---|---|
| LangChain | pitón | Ecosistema de herramientas amplio y más popular |
| Generación automática | pitón | Conversaciones multiagente, Microsoft |
| TripulaciónAI | pitón | Equipos de agentes basados en roles |
| Núcleo semántico | C#/Python | Orquestación de IA de Microsoft |
| SDK de IA de Vercel | mecanografiado | RSC, streaming, herramientas para aplicaciones web |
| LlamaIndex | pitón | Agente RAG +, centrado en datos |
| API de asistentes OpenAI | API | Gestionado, intérprete de código, búsqueda de archivos. |
Conclusión
Los agentes de IA representan la próxima evolución de las aplicaciones LLM: desde preguntas y respuestas en un solo turno hasta la realización de tareas autónomas en varios pasos.
| Nivel | Tipo | Ejemplo |
|---|---|---|
| Nivel 1 | chatbot sencillo | Preguntas y respuestas con RAG |
| Nivel 2 | Agente que utiliza herramientas | Atención al cliente con creación de tickets |
| Nivel 3 | Varios pasos con planificación | Asistente de investigación, generación de código. |
| Nivel 4 | Sistemas multiagente | Equipo de agentes de desarrollo de software. |
| Nivel 5 | Aprendizaje autónomo | Superación personal, adaptación con el tiempo |
Conclusiones clave:
- Comience con ReAct simple: la mayoría de los problemas no necesitan arquitecturas complejas.
- Diseñe las herramientas con cuidado: la calidad de las herramientas determina la calidad del agente.
- Implementar barreras de seguridad: detección de bucles, límites de costos, puertas de confirmación.
- Supervise y registre todo: el comportamiento del agente es más difícil de depurar que el código tradicional.
- Human-in-the-loop: para decisiones críticas, haga que el agente solicite confirmación.
Los sistemas de agentes más eficaces en 2026 equilibran la autonomía con la seguridad, dando al agente espacio para actuar mientras se mantiene la supervisión humana de las decisiones importantes.
Artículos destacados

6 patrones de programación que aprendí de ingenieros senior

Crea un asistente privado de notas con IA
Convierte notas Markdown en un asistente consultable sin exponer borradores privados.

Automatiza la extracción de datos de facturas con OCR
Crea un flujo que lee facturas, extrae campos y marca valores dudosos para revisión.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.