Recuperación-Generación Aumentada (RAG): Arquitectura, Patrones y Producción
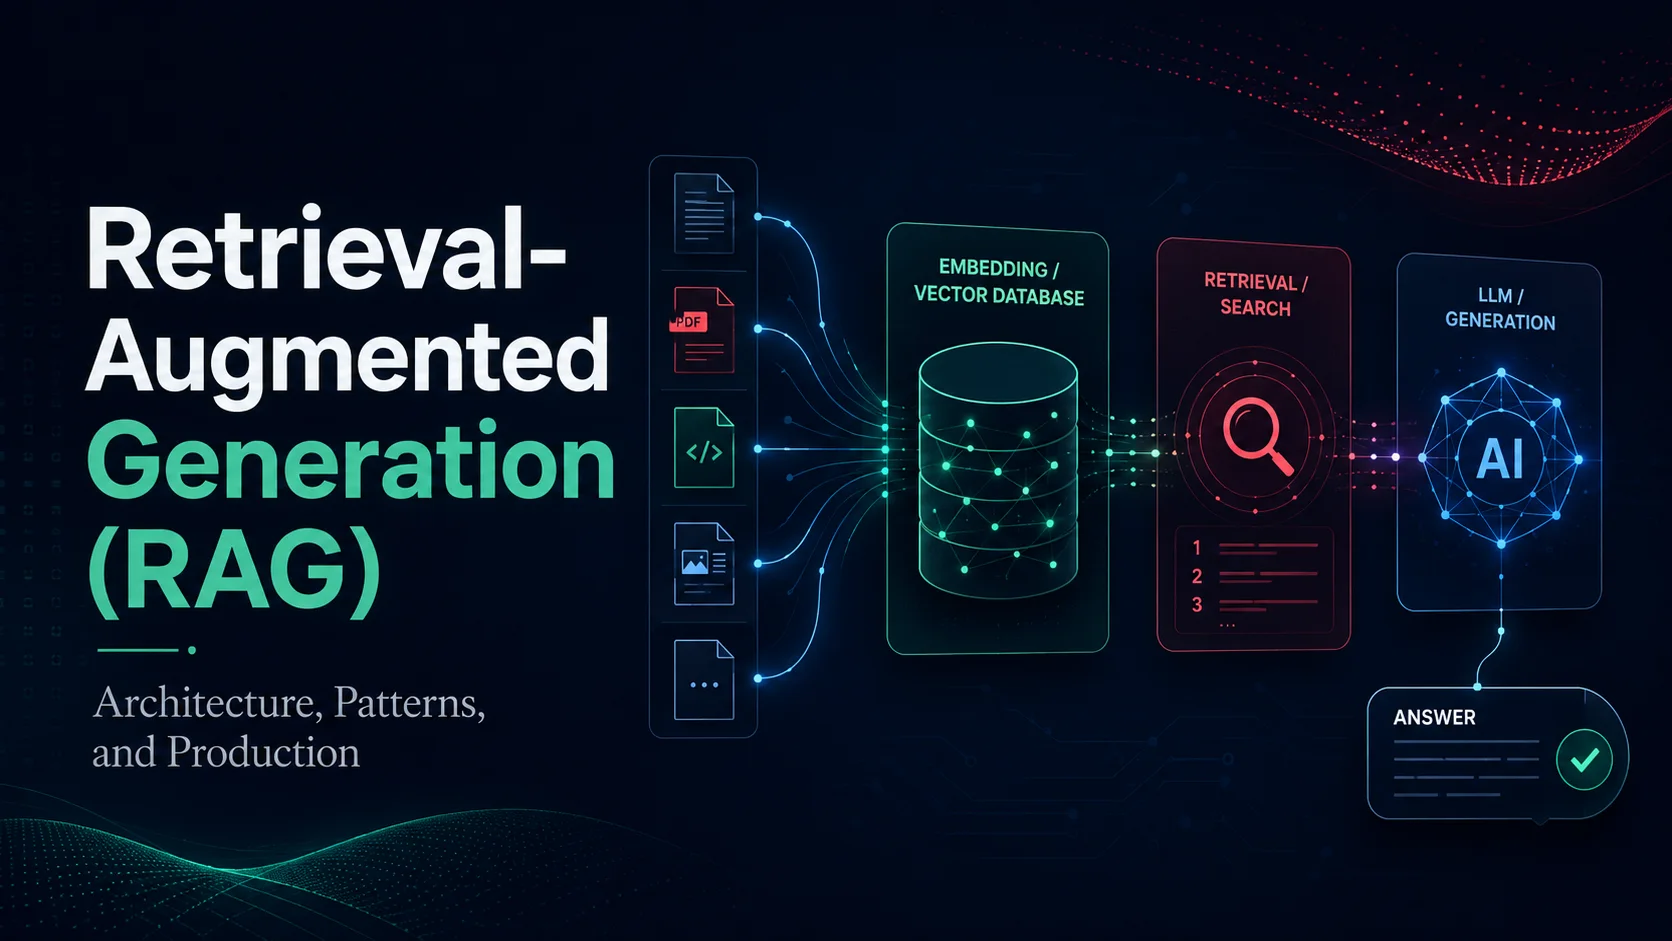
Recuperación-Generación Aumentada (RAG) es una arquitectura de IA que combina la recuperación de información con grandes modelos de lenguaje (LLM). En lugar de depender únicamente de los datos de capacitación del LLM para obtener respuestas, RAG recupera información relevante de una base de conocimientos y la proporciona como contexto para el LLM.
Introducción
Recuperación-Generación Aumentada (RAG) es una arquitectura de IA que combina la recuperación de información con grandes modelos de lenguaje (LLM). En lugar de depender únicamente de los datos de capacitación del LLM para obtener respuestas, RAG recupera información relevante de una base de conocimientos y la proporciona como contexto para el LLM.
Este enfoque resuelve tres limitaciones críticas de LLM: conocimiento desactualizado (corte de datos de entrenamiento), alucinaciones (inventar hechos) y falta de acceso a datos privados (desconocimiento de sus documentos internos).
¿Por qué RAG?
Limitaciones de LLM y soluciones RAG
| problema | LLM sin RAG | LLM con RAG |
|---|---|---|
| Límite de conocimiento | Sólo conoce datos hasta la fecha de entrenamiento. | Recupera información nueva de la base de conocimientos. |
| Alucinación | Puede inventar hechos cuando no está seguro. | Fundamentos de las respuestas en el contexto recuperado |
| Datos privados | No ha visto sus documentos internos | Busca en la base de conocimientos empresariales |
| Atribución de fuente | No puedo citar fuentes | Devuelve fragmentos exactos con citas |
| Costo | El ajuste fino es caro | No se necesita formación: solo indexar documentos |
RAG versus ajuste fino
| Aspecto | trapo | Ajuste fino |
|---|---|---|
| Actualizaciones de conocimientos | Instantáneo (actualización de base de datos vectorial) | Semanas (modelo de reentrenamiento) |
| Costo de formación | Ninguno | $100-$10,000+ |
| Nuevos conceptos | Sí, agregar a la base de conocimientos | No, requiere reentrenamiento |
| Prevención de alucinaciones | Bueno (conexión a tierra del contexto) | Limitado (memorización) |
| Atribución de fuente | si | No (caja negra) |
| Latencia | Superior (recuperación + generación) | Inferior (solo generación) |
| Cuando usar | Necesita información actualizada, citas, datos privados. | Necesidad de cambiar el comportamiento, el tono y el formato de salida del modelo. |
Arquitectura RAG
Flujo de alto nivel
                      ┌───────────────────────┐
                      │   Document Processing  │ (Ingestion Pipeline)
                      │   (Chunking → Embed)   │
                      └──────────┬────────────┘
                                 │
                                 ▼
                      ┌───────────────────────┐
                      │   Vector Database     │
                      │   (Knowledge Base)    │
                      └──────────┬────────────┘
                                 │
                      ┌──────────▼────────────┐
User Query ──────────►│   Retrieval Pipeline   │
                      │  (embed → search →     │
                      │   fetch chunks)        │
                      └──────────┬────────────┘
                                 │ (relevant chunks)
                                 ▼
                      ┌───────────────────────┐
                      │   Generation          │
                      │  (LLM + Context)      │
                      └──────────┬────────────┘
                                 │ (answer with citations)
                                 ▼
                           Final Answer
El canal de ingestión
1. Carga de documentos
from langchain_community.document_loaders import (
    PDFLoader, TextLoader, CSVLoader,
    UnstructuredHTMLLoader, ConfluenceLoader
)

# Load various document types
loaders = {
    '.pdf': PDFLoader("policy.pdf"),
    '.txt': TextLoader("readme.txt"),
    '.html': UnstructuredHTMLLoader("page.html"),
    '.csv': CSVLoader("data.csv"),
}

documents = []
for ext, loader in loaders.items():
    documents.extend(loader.load())
2. Estrategia de fragmentación
La fragmentación es fundamental: demasiado pequeño pierde contexto, demasiado grande incluye ruido:
from langchain.text_splitter import (
    RecursiveCharacterTextSplitter,
    TokenTextSplitter,
    SemanticChunker
)

# Recursive character splitting (most common)
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    separators=["\n\n", "\n", " ", ""],
    length_function=len,
)

# Semantic chunking (AI-aware — splits at topic boundaries)
semantic_splitter = SemanticChunker(
    embeddings=openai_embeddings,
    breakpoint_threshold_type="percentile",
)

chunks = text_splitter.split_documents(documents)
Compensaciones fragmentadas
| Estrategia | Tamaño del fragmento | recordar | Precisión | Mejor para |
|---|---|---|---|---|
| trozos pequeños | 200-500 fichas | Alto | Bajo (fragmentado) | Preguntas frecuentes, definiciones |
| Trozos medianos | 500-1500 fichas | Medio | Medio | trapo general |
| trozos grandes | 1500-3000 fichas | Bajo | Alto | Resumen |
| fragmentos semánticos | variable | Alto | Alto | Documentos complejos |
3. Incrustación
from langchain_openai import OpenAIEmbeddings
from langchain_qdrant import QdrantVectorStore

embeddings = OpenAIEmbeddings(
    model="text-embedding-3-small",
    dimensions=1536,
)

vector_store = QdrantVectorStore.from_documents(
    documents=chunks,
    embedding=embeddings,
    url="http://localhost:6333",
    collection_name="knowledge_base",
)
El canal de recuperación
1. Consulta de comprensión
from langchain.llms import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

def rewrite_query(original_query: str) -> str:
    """Rewrite user query for better retrieval"""
    prompt = ChatPromptTemplate.from_messages([
        ("system", "You are a query rewriting assistant. "
         "Rewrite the user's question to be more specific "
         "and searchable in a knowledge base."),
        ("user", original_query),
    ])
    llm = ChatOpenAI(model="gpt-4o-mini")
    return llm.invoke(prompt).content

# Example:
# Original: "What about vacation?"
# Rewritten: "What is the company policy on paid vacation days,
#             including accrual rate and carry-over limits?"
2. Estrategias de recuperación
Búsqueda de similitud simple:
results = vector_store.similarity_search_with_score(
    query=rewritten_query,
    k=5,
    score_threshold=0.75,
)
Búsqueda híbrida (vector + palabra clave):
# BM25 keyword scores combined with vector similarity
from langchain.retrievers import BM25Retriever, EnsembleRetriever

bm25_retriever = BM25Retriever.from_documents(chunks, k=5)
vector_retriever = vector_store.as_retriever(search_kwargs={"k": 5})

# Weighted ensemble
ensemble_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, bm25_retriever],
    weights=[0.7, 0.3],
)
Recuperación de consultas múltiples:
def generate_sub_queries(query: str, n: int = 3) -> list[str]:
    """Generate multiple perspectives on the same query"""
    prompt = f"Generate {n} different versions of this query for search: {query}"
    response = llm.invoke(prompt)
    return response.content.split('\n')

sub_queries = generate_sub_queries("remote work policy")
# Returns:
# - "How many days per week can employees work from home?"
# - "Remote work eligibility and approval process"
# - "Company work-from-home policy and guidelines"

all_results = []
for q in sub_queries:
    all_results.extend(vector_store.similarity_search(q, k=3))
3. Reclasificación
Mejore la calidad de la recuperación reclasificando los resultados con un codificador cruzado:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

pairs = [(query, result.page_content) for result in initial_results]
scores = reranker.predict(pairs)

reranked_results = [
    result for _, result in
    sorted(zip(scores, initial_results), key=lambda x: x[0], reverse=True)
]

# Take top 3 after reranking
final_context = reranked_results[:3]
El oleoducto de generación
Ingeniería de avisos del sistema
rag_prompt = """You are a helpful assistant that answers questions based
on the provided context. Follow these rules:

1. Answer ONLY using information from the provided context.
2. If the context does not contain the answer, say
   "I don't have enough information to answer this question."
3. Do NOT make up or infer information not in the context.
4. Include citations in [Source: filename.pdf] format.
5. Be concise but thorough.
6. Format lists and tables using markdown when appropriate.

Context:
{context}

Question: {question}
Answer (with citations):"""
Generación con citas
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

qa_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    chain_type="stuff",  # "stuff" = put all context in one prompt
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    chain_type_kwargs={
        "prompt": PromptTemplate.from_template(rag_prompt),
        "verbose": True,
    },
    return_source_documents=True,
)

result = qa_chain.invoke({"query": "What is the vacation policy?"})

print(result['result'])
# "Employees accrue 15 days of paid vacation per year (accrued monthly
# at 1.25 days/month). Unused days may carry over up to 5 days to the
# next calendar year. [Source: HR_Handbook_2026.pdf]"

print(result['source_documents'])
# [Document(page_content="...", metadata={"source": "HR_Handbook_2026.pdf", ...})]
Patrones RAG avanzados
1. TRAPO de saltos múltiples
Para preguntas que requieren información de varios documentos:
Q: "Which products are affected by the new regulation and who needs training?"

Step 1: Retrieve regulation document → identifies affected product categories
Step 2: Use product list to query training documents
Step 3: Compose answer from both sources
2. RAG agente
Utilice un agente de LLM para planificar la recuperación, decidir qué herramientas utilizar e iterar:
from langchain.agents import AgentExecutor, create_openai_functions_agent
from langchain.tools import Tool

retrieval_tool = Tool(
    name="search_knowledge_base",
    func=lambda q: vector_store.similarity_search(q, k=3),
    description="Search company knowledge base for policies and procedures"
)

calculator_tool = Tool(
    name="calculator",
    func=lambda expr: eval(expr),
    description="Perform mathematical calculations"
)

agent = create_openai_functions_agent(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    tools=[retrieval_tool, calculator_tool],
    prompt=agent_prompt,
)
agent_executor = AgentExecutor(agent=agent, tools=[retrieval_tool, calculator_tool])
3. RAG autorreflectante (Self-RAG)
El modelo comprueba su propia calidad de recuperación y generación:
def self_rag(query: str) -> str:
    # 1. Retrieve
    docs = retrieve(query, k=5)

    # 2. Check: is retrieved info relevant?
    relevance_score = check_relevance(query, docs)

    if relevance_score < 0.7:
        return "I cannot find relevant information to answer this question."

    # 3. Generate answer
    answer = generate(query, docs)

    # 4. Check: does answer match retrieved info?
    faithfulness_score = check_faithfulness(answer, docs)

    if faithfulness_score < 0.8:
        return generate_with_constraints(query, docs)  # Regenerate

    # 5. Check: is answer useful?
    usefulness_score = check_usefulness(query, answer)

    return answer
4. RAG Correctivo (CRAG)
Recupera, evalúa y corrige antes de generar:
def corrective_rag(query):
    # Initial retrieval
    docs = retrieve(query)

    # Evaluate retrieval quality
    quality = evaluate_retrieval(query, docs)

    if quality == "excellent":
        # Direct generation
        return generate(query, docs)

    elif quality == "partial":
        # Re-rank and try again
        docs = rerank_and_retry(query, docs)
        return generate(query, docs)

    else:  # poor
        # Try web search or generate without context
        if web_search_available:
            docs = web_search(query)
            return generate(query, docs)
        else:
            return generate_without_context(query)
Consideraciones de producción RAG
Métricas de evaluación
| Métrica | Qué mide | Objetivo |
|---|---|---|
| Recuperación de recuperación | ¿Encontramos todos los fragmentos relevantes? | > 0,90 |
| Precisión de contexto | ¿Son realmente relevantes los fragmentos recuperados? | > 0,85 |
| Fidelidad | ¿La respuesta se mantiene fiel al contexto? | > 0,95 |
| Relevancia de la respuesta | ¿La respuesta aborda la consulta? | > 0,90 |
| Tasa de alucinaciones | Porcentaje de hechos inventados | < 1% |
Monitoreo
class RAGMonitor:
    def __init__(self):
        self.metrics = {
            'retrieval_latency': [],
            'generation_latency': [],
            'context_token_count': [],
            'completion_token_count': [],
        }

    def log_query(self, query: str, retrieval_time: float,
                  gen_time: float, context: str, response: str):
        self.metrics['retrieval_latency'].append(retrieval_time)
        self.metrics['generation_latency'].append(gen_time)
        # Track context size — too large = expensive, too small = poor quality
        self.metrics['context_token_count'].append(count_tokens(context))
        # Log for later analysis
        log_to_db(query, response, context)

    def alert_if_degraded(self):
        avg_latency = mean(self.metrics['generation_latency'][-100:])
        if avg_latency > 5.0:  # seconds
            alert_pagerduty("RAG generation latency degraded")
Presupuesto de latencia
Total RAG latency: 1.5-4 seconds
├── Query embedding:      100-300ms
├── Vector search:         50-200ms
├── Reranking:            100-300ms
├── Context formatting:    10-50ms
└── LLM generation:      1000-3000ms (depends on output length)
Mejores prácticas de fragmentación e indexación
| Practica | ¿Por qué? | Implementación |
|---|---|---|
| Almacenamiento de metadatos | Filtrado, procedencia, citas. | Nombre del archivo de la tienda, número de página, título de la sección, fecha |
| Gragación entre padres e hijos | Recuperar pequeños fragmentos, devolver un gran contexto | Almacene pequeños fragmentos para búsqueda, enlace al padre para generación |
| Resumen del documento | Contexto global para preguntas amplias | Almacene un resumen por documento, utilícelo para el filtrado inicial |
| Deduplicación de contenido | Evite el contexto redundante | Trozos de hash, eliminar casi duplicados |
| Versionamiento | Seguimiento de actualizaciones de documentos | Agregar campo de versión a los metadatos, admitir reversión |
Conclusión
RAG es la forma más práctica de implementar LLM con conocimientos precisos, actualizados y atribuibles. Conclusiones clave:
- RAG > ajuste fino para la mayoría de los casos de uso: más económico, más flexible y actualizable.
- La calidad de la fragmentación determina la calidad de RAG: invierta tiempo en encontrar la estrategia adecuada.
- La búsqueda híbrida supera al vector puro: combínela con una palabra clave para recordar mejor.
- Vale la pena dar un paso adicional para cambiar la clasificación: mejora significativamente la calidad de los resultados.
- Monitorear la degradación: la calidad de la recuperación cambia a medida que se agregan documentos.
- Comience de manera simple, agregue complejidad según sea necesario: el RAG básico funciona bien; Los patrones avanzados resuelven problemas específicos.
RAG está evolucionando rápidamente, con variantes agentes, autorreflexivas y correctivas que traspasan los límites de lo que pueden lograr los sistemas de recuperación aumentada.
Artículos destacados

6 patrones de programación que aprendí de ingenieros senior

Crea un asistente privado de notas con IA
Convierte notas Markdown en un asistente consultable sin exponer borradores privados.

Automatiza la extracción de datos de facturas con OCR
Crea un flujo que lee facturas, extrae campos y marca valores dudosos para revisión.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.