Bases de datos de series temporales: gestión de datos que cambian con el tiempo
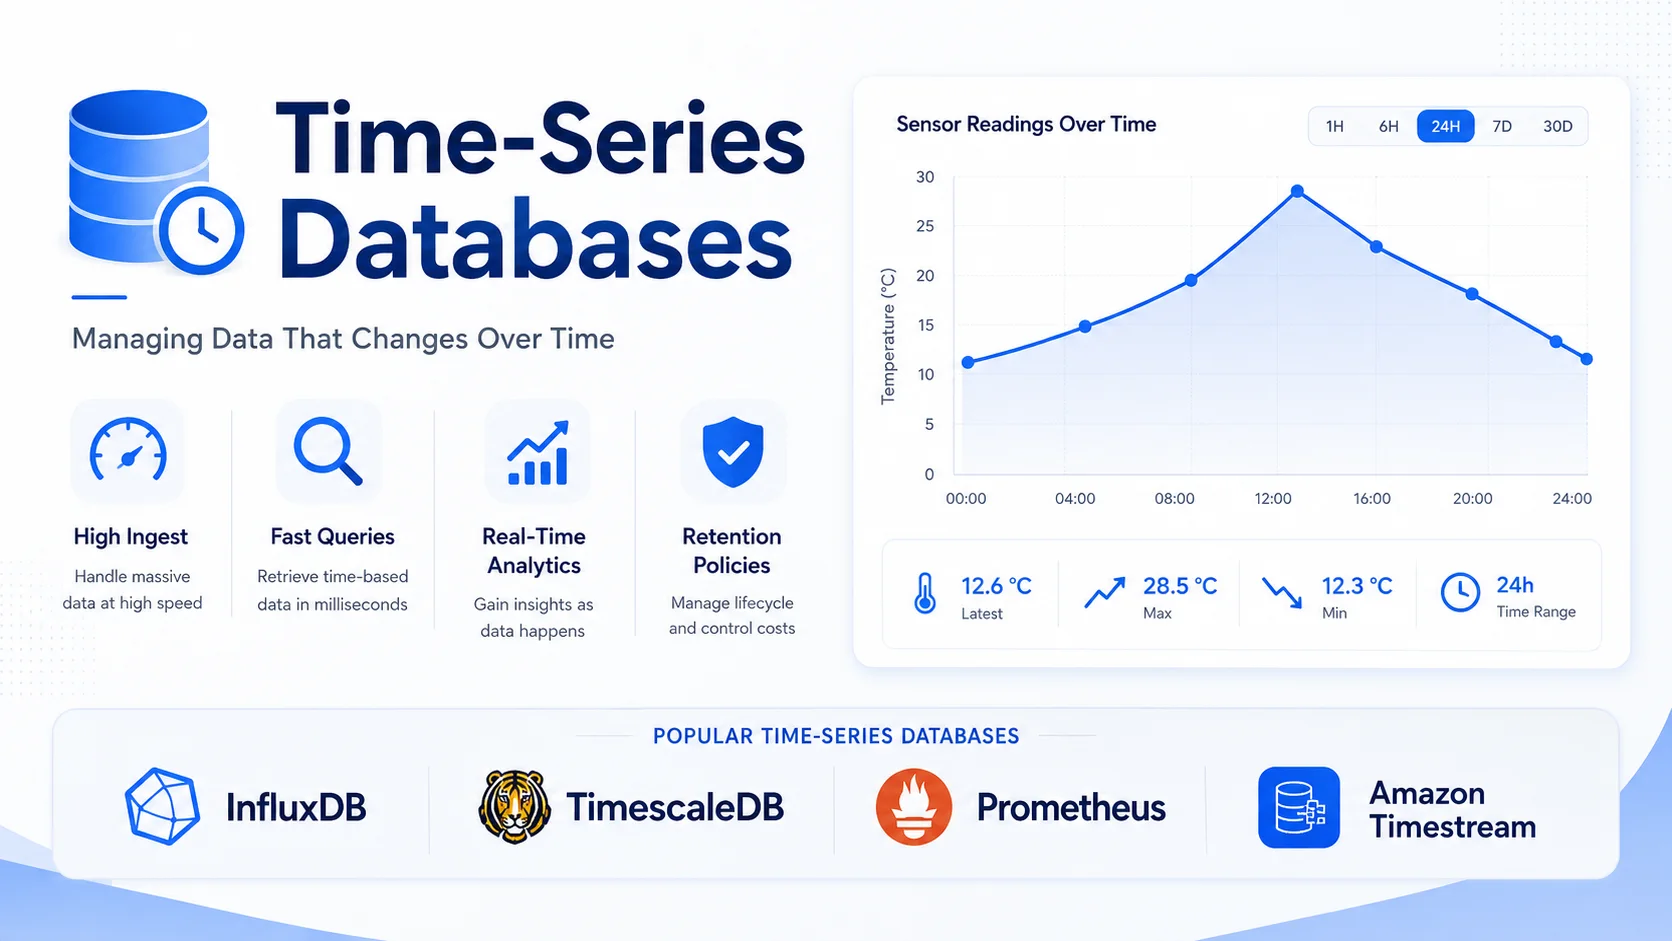
Una base de datos de series de tiempo (TSDB) está especializada en almacenar y consultar puntos de datos indexados por tiempo: lecturas de sensores, métricas de servidores, registros de aplicaciones, datos financieros y telemetría de IoT. Los datos de series de tiempo tienen características únicas que hacen que las bases de datos tradicionales no sean óptimas:
Introducción
Una base de datos de series de tiempo (TSDB) está especializada en almacenar y consultar puntos de datos indexados por tiempo: lecturas de sensores, métricas de servidores, registros de aplicaciones, datos financieros y telemetría de IoT. Los datos de series de tiempo tienen características únicas que hacen que las bases de datos tradicionales no sean óptimas:
- Con mucha escritura: de millones a miles de millones de puntos de datos por día.
- Solo agregar: los datos rara vez se actualizan y casi siempre se agregan.
- Ordenado por tiempo: las consultas siempre implican un rango de tiempo.
- Basado en retención: los datos antiguos eventualmente se resumen o eliminan.
- Reducido la resolución: los datos más antiguos se almacenan con una resolución más baja.
Características de los datos de series temporales
El modelo de datos
Cada punto de datos de la serie temporal tiene:
| Componente | Ejemplo | Descripción |
|---|---|---|
| Marca de tiempo | 2026-05-24T14:30:00Z | Cuando se tomó la medida |
| Valor | 42.5 | El valor medido |
| Métrico | uso_cpu | ¿Qué se está midiendo? |
| Etiquetas/etiquetas | host=web01, región=ee.uu.-este | Metadatos para filtrar |
Metric: cpu_usage{host="web01", region="us-east"}
┌─────────────────────┬───────┐
│ Timestamp           │ Value │
├─────────────────────┼───────┤
│ 2026-05-24T14:30:00 │ 42.5  │
│ 2026-05-24T14:30:01 │ 43.2  │
│ 2026-05-24T14:30:02 │ 41.8  │
│ ...                 │ ...   │
└─────────────────────┴───────┘
Series de tiempo frente a bases de datos tradicionales
| Operación | PostgreSQL | Escala de tiempoDB (PostgreSQL + TS) | InflujoDB (TSDB) |
|---|---|---|---|
| Rendimiento de escritura | 10.000 filas/seg. | 100.000-1 millón de filas/seg. | Más de 1 millón de filas/s |
| Consulta: 1 hora promedio por 5 min | Minutos (escaneo completo) | Segundos (agregado continuo) | Segundos |
| Almacenamiento | Orientado a filas | Fila/columna híbrida | Orientado a columnas |
| Compresión | Ninguno por defecto | 90%+ (compresión nativa) | 90%+ |
| Políticas de retención | Gestión manual de particiones | Automático | Automático |
| Reducción de resolución de datos | Consultas manuales | Agregados continuos | Consultas de reducción de resolución |
| Soporte SQL | completo | Completo (SQL) | Limitado (Flujo/SQL) |
Comparación de bases de datos de series temporales
| Característica | Escala de tiempoDB | InflujoDB | Prometeo | VictoriaMétricas | QuestDB |
|---|---|---|---|---|---|
| Motor | Extensión PostgreSQL | Motor TS personalizado | Basado en extracción personalizado | Motor TS personalizado | columnar |
| Idioma de consulta | SQL | SQL/flujo | PromQL | Compatible con PromQL | SQL + afluencia |
| Tasa de ingestión | 1M+/seg. | 1M+/seg. | 500K/seg | 1M+/seg. | 2M+/seg. |
| Compresión | 90-97% | 90+% | Ninguno | 90+% | 90+% |
| Agrupación | Multinodo (timescaledb) | Empresa | fragmentación nativa | Nativo | Ninguno |
| Retención | Automático con políticas | Automático | Configurable | Configurable | manuales |
| Agregados continuos | Sí (nativo) | No (tarea separada) | Reglas de grabación | Reglas de grabación | No |
| Mejor para | Usuarios de SQL, datos operativos. | IoT, DevOps | Kubernetes, nativo de la nube | Métricas de alta escala | Financiero, de alta velocidad. |
InfluxDB: la TSDB dedicada
Modelo de datos
# InfluxDB v3 — data model
from influxdb_client import InfluxDBClient, Point
from influxdb_client.client.write_api import SYNCHRONOUS

client = InfluxDBClient(url="http://localhost:8086", token="my-token")
write_api = client.write_api(write_options=SYNCHRONOUS)

# A point = measurement + tags + fields + timestamp
point = (
    Point("temperature")
    .tag("sensor", "sensor-001")
    .tag("location", "warehouse-a")
    .field("value", 23.5)
    .field("humidity", 65.2)
    .time(datetime.utcnow())
)

write_api.write(bucket="sensors", record=point)
Consultando
-- InfluxDB SQL (v3)
SELECT time, value
FROM temperature
WHERE sensor = 'sensor-001'
  AND time >= NOW() - INTERVAL '1 hour'
ORDER BY time DESC;

-- Aggregation with downsampling
SELECT time_bucket(INTERVAL '5 minutes', time) as bucket,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp
FROM temperature
WHERE location = 'warehouse-a'
  AND time >= NOW() - INTERVAL '24 hours'
GROUP BY bucket
ORDER BY bucket;
Políticas de retención
-- InfluxDB: automatic data lifecycle
CREATE RETENTION POLICY "one_hour"
ON "sensors"
DURATION 1h
REPLICATION 1
DEFAULT;

CREATE RETENTION POLICY "one_week"
ON "sensors"
DURATION 168h
REPLICATION 1;

-- Create downsample task
CREATE TASK "downsample_1h" ON "sensors"
  EVERY 1 HOUR
  BEGIN
    -- Aggregate 1-minute data to 1-hour averages
    SELECT time_bucket(INTERVAL '1 hour', time) as time,
           AVG(value) as value
    INTO "one_week"."temperature_hourly"
    FROM "one_hour"."temperature"
    WHERE time >= NOW() - INTERVAL '2 hours'
    GROUP BY 1, sensor, location;
  END;
Prometheus: monitoreo nativo de la nube
Arquitectura (modelo pull)
┌─────────────────────────────────────────────────┐
│              Prometheus Server                   │
│  ┌──────────┐  ┌──────────┐  ┌───────────────┐  │
│  │ Retrieval│  │ TSDB     │  │ Alertmanager  │  │
│  │ (pull)   │──│ (storage)│──│ (alerts)      │  │
│  └─────┬────┘  └──────────┘  └───────────────┘  │
│        │                                          │
└────────┼──────────────────────────────────────────┘
         │
    ┌────┼────────────┬──────────────┐
    ▼    ▼            ▼              ▼
  App  App   Node Exporter   Custom Exporter
PromQL (lenguaje de consulta Prometheus)
# Basic queries
cpu_usage{host="web01"}
http_requests_total[5m]

# Rate (per-second average)
rate(http_requests_total[5m])

# Aggregation
avg by (host) (cpu_usage)

# Histogram quantile
histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))

# Predict linear regression
predict_linear(node_disk_free_bytes[1h], 3600) < 0

# Recording rule (pre-computed)
- record: job:http_requests:rate5m
  expr: rate(http_requests_total[5m])
Descubrimiento de servicios y objetivos
# prometheus.yml
scrape_configs:
  - job_name: 'kubernetes-nodes'
    kubernetes_sd_configs:
      - role: node
    relabel_configs:
      - source_labels: [__meta_kubernetes_node_label_kubernetes_io_role]
        regex: control-plane
        action: drop

  - job_name: 'custom-app'
    static_configs:
      - targets: ['app01:8080', 'app02:8080', 'app03:8080']
TimescaleDB: PostgreSQL para series temporales
TimescaleDB es una extensión de PostgreSQL que agrega capacidades de series de tiempo manteniendo total compatibilidad con SQL.
hipertablas
-- Create a hypertable (automatically partitions by time)
CREATE TABLE temperature (
    time TIMESTAMPTZ NOT NULL,
    sensor_id INTEGER,
    location TEXT,
    value DOUBLE PRECISION,
    humidity DOUBLE PRECISION
);

-- Convert to hypertable (partitions by 1 day chunks)
SELECT create_hypertable('temperature', 'time',
    chunk_time_interval => INTERVAL '1 day');

-- Add partitioning by location (optional, for multi-node)
SELECT add_dimension('temperature', 'location', number_partitions => 4);
Compresión
-- Enable compression on hypertable
ALTER TABLE temperature SET (
    timescaledb.compress,
    timescaledb.compress_segmentby = 'sensor_id',
    timescaledb.compress_orderby = 'time DESC'
);

-- Compression policy: compress data older than 7 days
SELECT add_compression_policy('temperature', INTERVAL '7 days');

-- Compression ratio: 90-97%
-- 100GB of raw data → 3-10GB compressed
Agregados Continuos (Vistas Materializadas)
-- Create 5-minute aggregates (refreshed every minute)
CREATE MATERIALIZED VIEW temperature_hourly
WITH (timescaledb.continuous) AS
SELECT time_bucket('5 minutes', time) as bucket,
       sensor_id,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp,
       stddev(value) as temp_stddev
FROM temperature
GROUP BY bucket, sensor_id;

-- Refresh policy
SELECT add_continuous_aggregate_policy('temperature_hourly',
    start_offset => INTERVAL '3 days',
    end_offset => INTERVAL '1 hour',
    schedule_interval => INTERVAL '1 minute');
Retención de datos
-- Automatic data removal
SELECT add_retention_policy('temperature_raw', INTERVAL '30 days');
SELECT add_retention_policy('temperature_hourly', INTERVAL '1 year');
SELECT add_retention_policy('temperature_daily', INTERVAL '5 years');
Patrones de consulta
Reducción de resolución
-- Raw data: 1m intervals, kept 30 days
-- 5m average: kept 1 year
-- 1h average: kept 5 years

SELECT time_bucket('1 hour', time) as hour,
       AVG(value) as avg_temperature,
       PERCENTILE_CONT(0.95) WITHIN GROUP (ORDER BY value) as p95
FROM temperature
WHERE time >= NOW() - INTERVAL '7 days'
GROUP BY hour
ORDER BY hour;
Interpolación (llenar huecos)
-- Fill missing data with linear interpolation
SELECT time_bucket('5 minutes', time) as bucket,
       INTERPOLATE(AVG(value)) as temperature
FROM temperature
WHERE sensor_id = 1
  AND time >= NOW() - INTERVAL '1 hour'
GROUP BY bucket
ORDER BY bucket;

-- Or use LAST observation carried forward (LOCF)
SELECT time_bucket('5 minutes', time) as bucket,
       LOCF(AVG(value)) as temperature
FROM temperature
GROUP BY bucket
ORDER BY bucket;
Detección de anomalías
-- Detect values outside 3 standard deviations
WITH stats AS (
    SELECT AVG(value) as mean,
           stddev(value) as sigma
    FROM temperature
    WHERE time >= NOW() - INTERVAL '24 hours'
)
SELECT time, value,
       (value - mean) / sigma as z_score
FROM temperature, stats
WHERE time >= NOW() - INTERVAL '1 hour'
  AND ABS((value - mean) / sigma) > 3
ORDER BY time;
Almacenamiento y compresión
Cómo los TSDB logran una alta compresión
Raw data layout (row-oriented):
time, sensor_id, location, value
14:30:00, 1, "room_a", 23.5
14:30:01, 1, "room_a", 23.6
14:30:02, 1, "room_a", 23.4
14:30:03, 1, "room_a", 23.7

Column-oriented + Delta encoding:
time:    14:30:00, +1s, +1s, +1s  → 1 value + 3 deltas
sensor_id: 1, 1, 1, 1 → run-length encoding: "1 × 4"
location: "room_a" × 4 → run-length encoding: "room_a × 4"
value: 23.5, +0.1, -0.2, +0.3 → delta encoding

Result: ~95% compression vs. raw text
Relaciones de compresión
| Base de datos | crudo | comprimido | proporción |
|---|---|---|---|
| Escala de tiempoDB | 100GB | 3-10 GB | 90-97% |
| InflujoDB | 100GB | 5-15GB | 85-95% |
| Prometeo | 100GB | 20-25GB | 75-80% |
| VictoriaMétricas | 100GB | 3-8 GB | 92-97% |
Casos de uso
1. Monitoreo de infraestructura
# Node exporter metrics collected every 15 seconds
metrics:
  - cpu_usage{host="web01", cpu="0"}
  - memory_used{host="web01", type="RAM"}
  - disk_io{host="web01", device="sda", type="read_bytes"}
  - network_bytes{host="web01", interface="eth0", direction="in"}
  - load_average{host="web01", duration="1m"}

storage:
  raw: 15s intervals, 7 days
  aggregated: 5m intervals, 30 days
  daily: 1h intervals, 1 year
2. Datos de sensores de IoT
# Millions of devices sending data every minute
from timescaledb import hypertable

sensors = hypertable('sensor_data', 'time',
    chunk_time='1 day',
    compression='7 days',
    retention='90 days'
)

# Query: average temperature per device per hour
query = """
    SELECT time_bucket('1 hour', time) as hour,
           device_id,
           AVG(temperature) as avg_temp,
           COUNT(*) as samples
    FROM sensor_data
    WHERE time >= NOW() - INTERVAL '24 hours'
    GROUP BY hour, device_id
"""
3. Datos financieros
-- Stock price ticks: 10M+ per day per instrument
CREATE TABLE ticks (
    time TIMESTAMPTZ NOT NULL,
    symbol TEXT NOT NULL,
    price DOUBLE PRECISION,
    volume BIGINT,
    bid DOUBLE PRECISION,
    ask DOUBLE PRECISION
);

SELECT create_hypertable('ticks', 'time',
    chunk_time_interval => INTERVAL '1 hour');

-- OHLC (Open-High-Low-Close) candlestick query
SELECT time_bucket('5 minutes', time) as bucket,
       symbol,
       FIRST(price, time) as open,
       MAX(price) as high,
       MIN(price) as low,
       LAST(price, time) as close,
       SUM(volume) as volume
FROM ticks
WHERE symbol = 'AAPL'
  AND time >= NOW() - INTERVAL '1 day'
GROUP BY bucket, symbol;
Mejores prácticas
Diseño de esquemas
-- Good schema: separate metrics by table
CREATE TABLE cpu_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);
CREATE TABLE memory_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);

-- Avoid: single wide table with all metrics as columns
-- (leads to sparse data, poor compression)
Ajuste del tamaño del fragmento
-- Too small: too many partitions, slow queries
-- Too large: poor memory management, slow ingestion
-- Rule of thumb: each chunk should be 1-10GB compressed

-- For 1000 writes/sec, 1KB each = 86GB/day
-- 1 day chunks = 86GB (too large)
-- 6 hour chunks = 21GB (good)
SELECT set_chunk_time_interval('temperature', INTERVAL '6 hours');
Conclusión
Las bases de datos de series temporales están diseñadas específicamente para los datos que los sistemas modernos producen en su mayoría: mediciones con marca de tiempo de aplicaciones, infraestructura, dispositivos IoT y mercados financieros.
| Caso de uso | Base de datos recomendada |
|---|---|
| Monitoreo de infraestructura (Kubernetes) | Prometheus + VictoriaMétricas |
| Datos de sensores de IoT con consultas SQL | Escala de tiempoDB |
| Análisis en tiempo real, DevOps | InflujoDB |
| Datos financieros de alta frecuencia | QuestDB |
| Métricas nativas de la nube basadas en pull | Prometeo |
Conclusiones clave:
- Las TSDB están optimizadas para escritura: manejan más de 1 millón de puntos de datos por segundo en un solo nodo.
- Alta compresión (90%+): almacene más datos por menos costo.
- Ciclo de vida de datos automático: las políticas de retención y la reducción de resolución reducen los costos de almacenamiento.
- Compatibilidad con SQL siempre que sea posible: TimescaleDB proporciona compatibilidad total con SQL.
- Diferentes herramientas para diferentes necesidades: Prometheus para usuarios nativos de la nube, InfluxDB para DevOps, TimescaleDB para usuarios avanzados de SQL.
La arquitectura de series de tiempo adecuada ingiere datos de manera eficiente, los envejece con elegancia y los consulta al instante, convirtiendo números sin procesar con marca de tiempo en información procesable.
Artículos destacados

6 patrones de programación que aprendí de ingenieros senior

Crea un asistente privado de notas con IA
Convierte notas Markdown en un asistente consultable sin exponer borradores privados.

Automatiza la extracción de datos de facturas con OCR
Crea un flujo que lee facturas, extrae campos y marca valores dudosos para revisión.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.