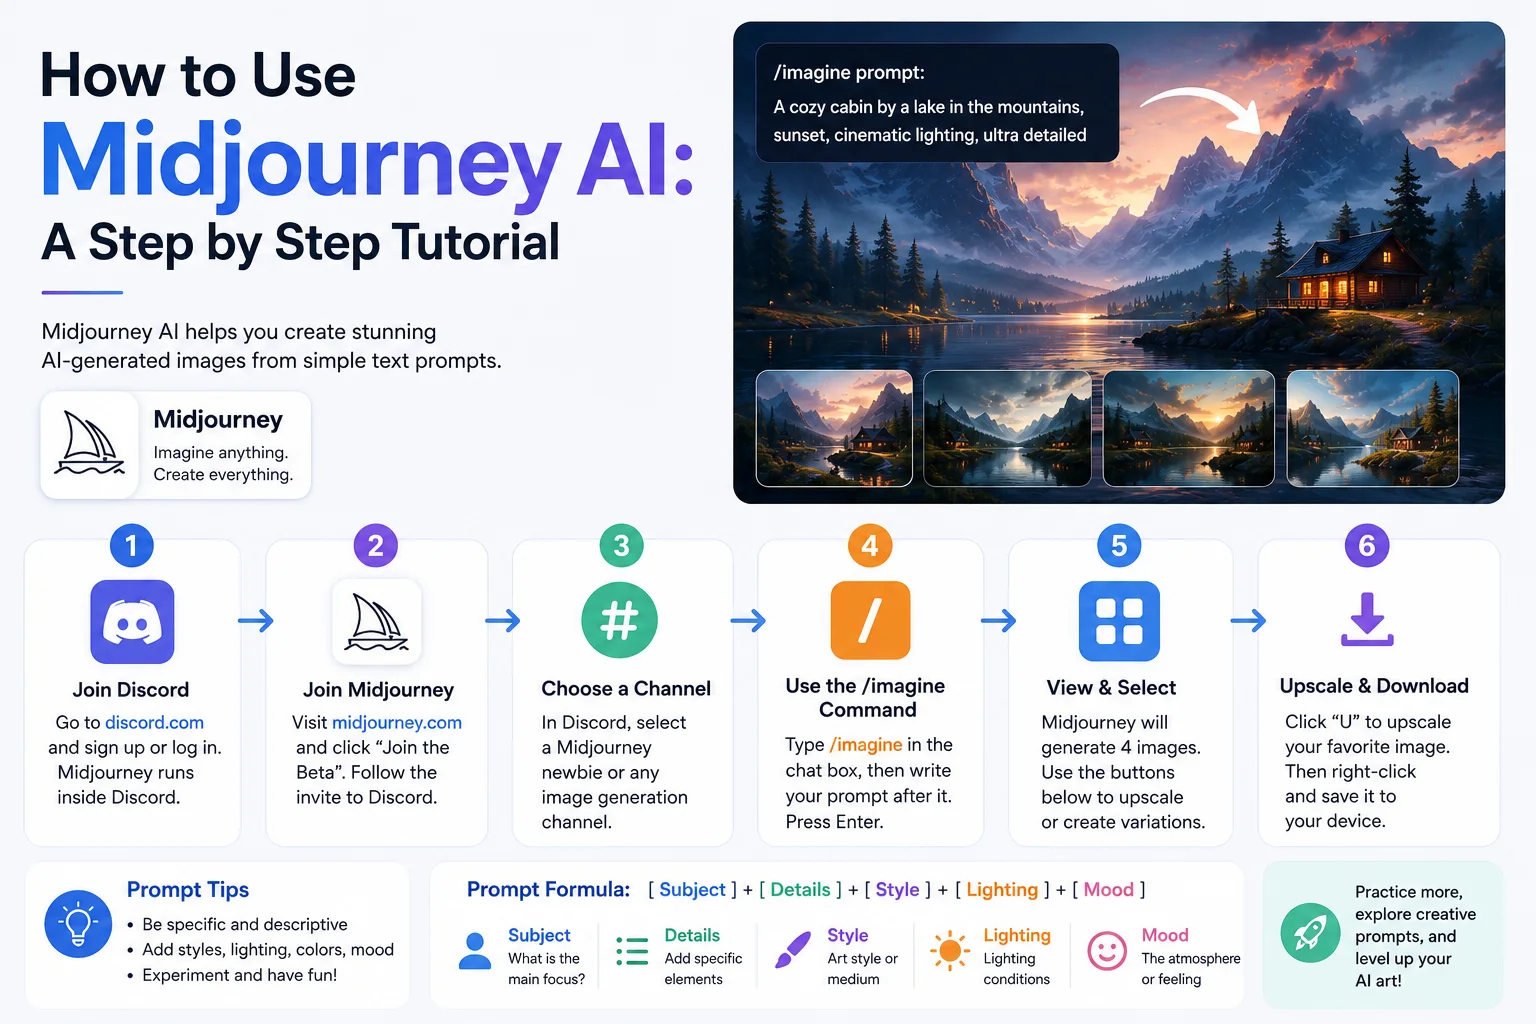
So verwenden Sie Midjourney AI: Eine Schritt-für-Schritt-Anleitung
Midjourney arbeitet über Discord. Gehen Sie zu midjourney.com und klicken Sie auf „Der Beta beitreten“, um auf den Discord-Server zuzugreifen.
Entdecke Tutorials und Editorials mit mehrsprachiger SEO-Unterstützung.
165 Artikel

Midjourney arbeitet über Discord. Gehen Sie zu midjourney.com und klicken Sie auf „Der Beta beitreten“, um auf den Discord-Server zuzugreifen.

Netzwerkprotokollanalysator, mit dem Sie jedes durch Ihr Netzwerk fließende Paket sehen können. Unverzichtbar für das Verständnis des Netzwerkverkehrs und das Erkennen von Anomalien.

Immer noch der König der Code-Editoren. Erweiterungen, Git-Integration und IntelliSense machen es zur Standardwahl für Webentwicklung, Python und die meisten Sprachen.

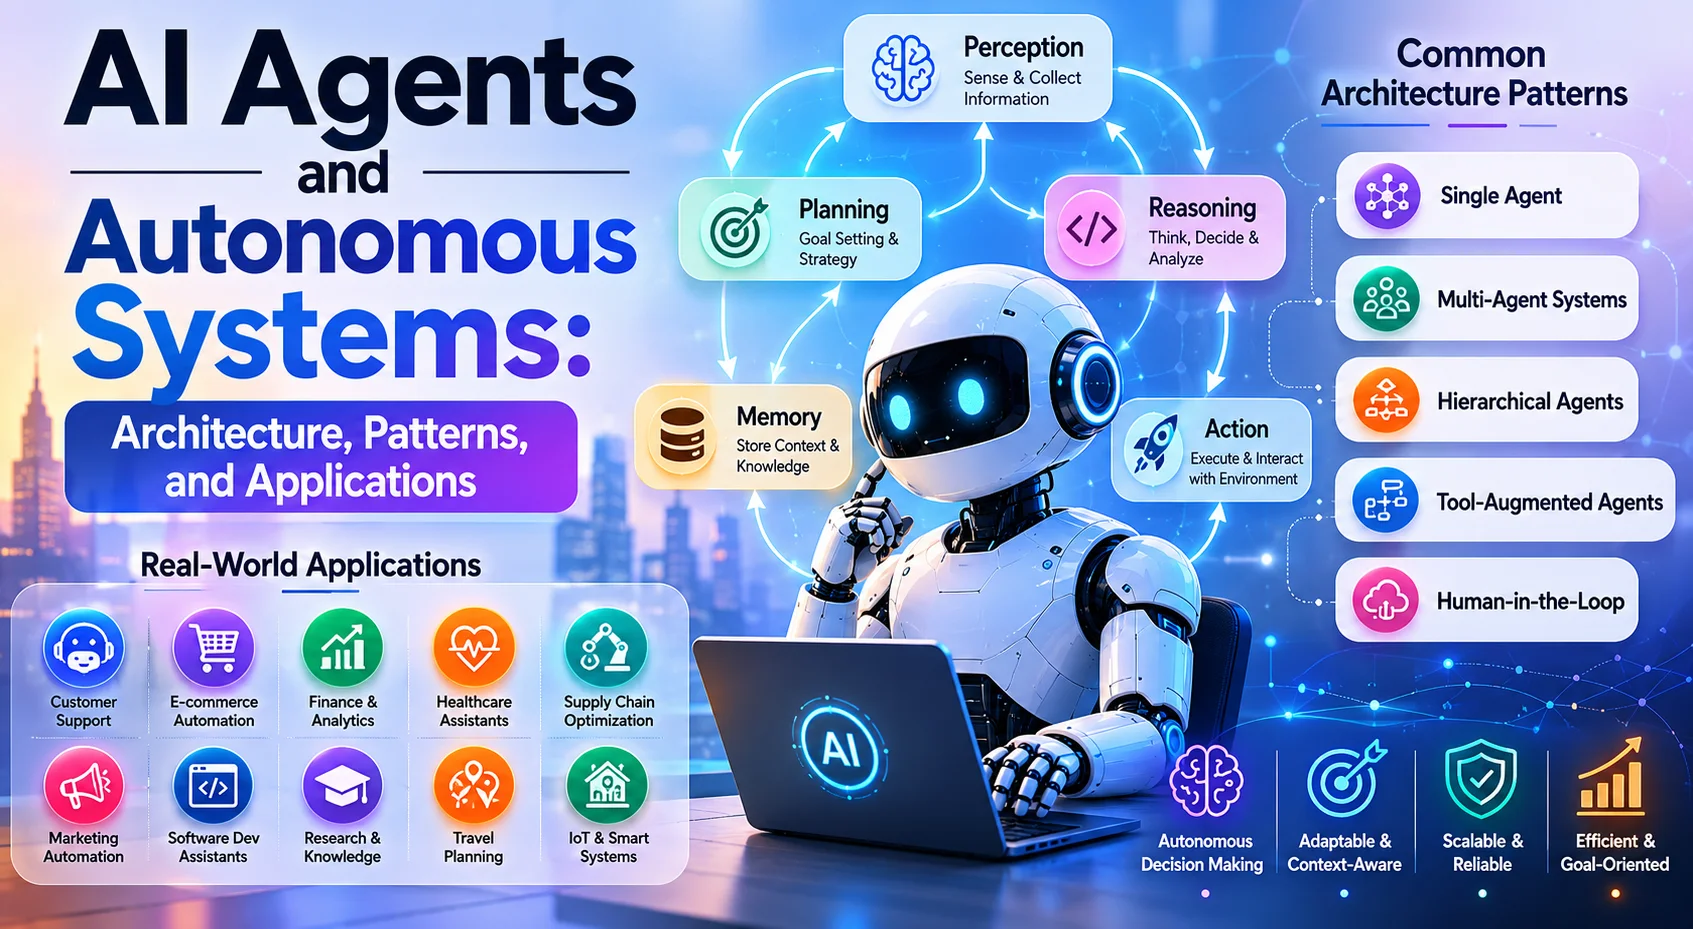
KI-Agenten sind autonome Softwaresysteme, die ihre Umgebung wahrnehmen, über Ziele nachdenken, Maßnahmen ergreifen und aus Ergebnissen lernen. Im Gegensatz zu herkömmlichen LLM-Anwendungen, die auf eine einzige Eingabeaufforderung reagieren, arbeiten Agenten in Schleifen – sie beobachten, denken, handeln und beobachten erneut –, bis ein Ziel erreicht ist.

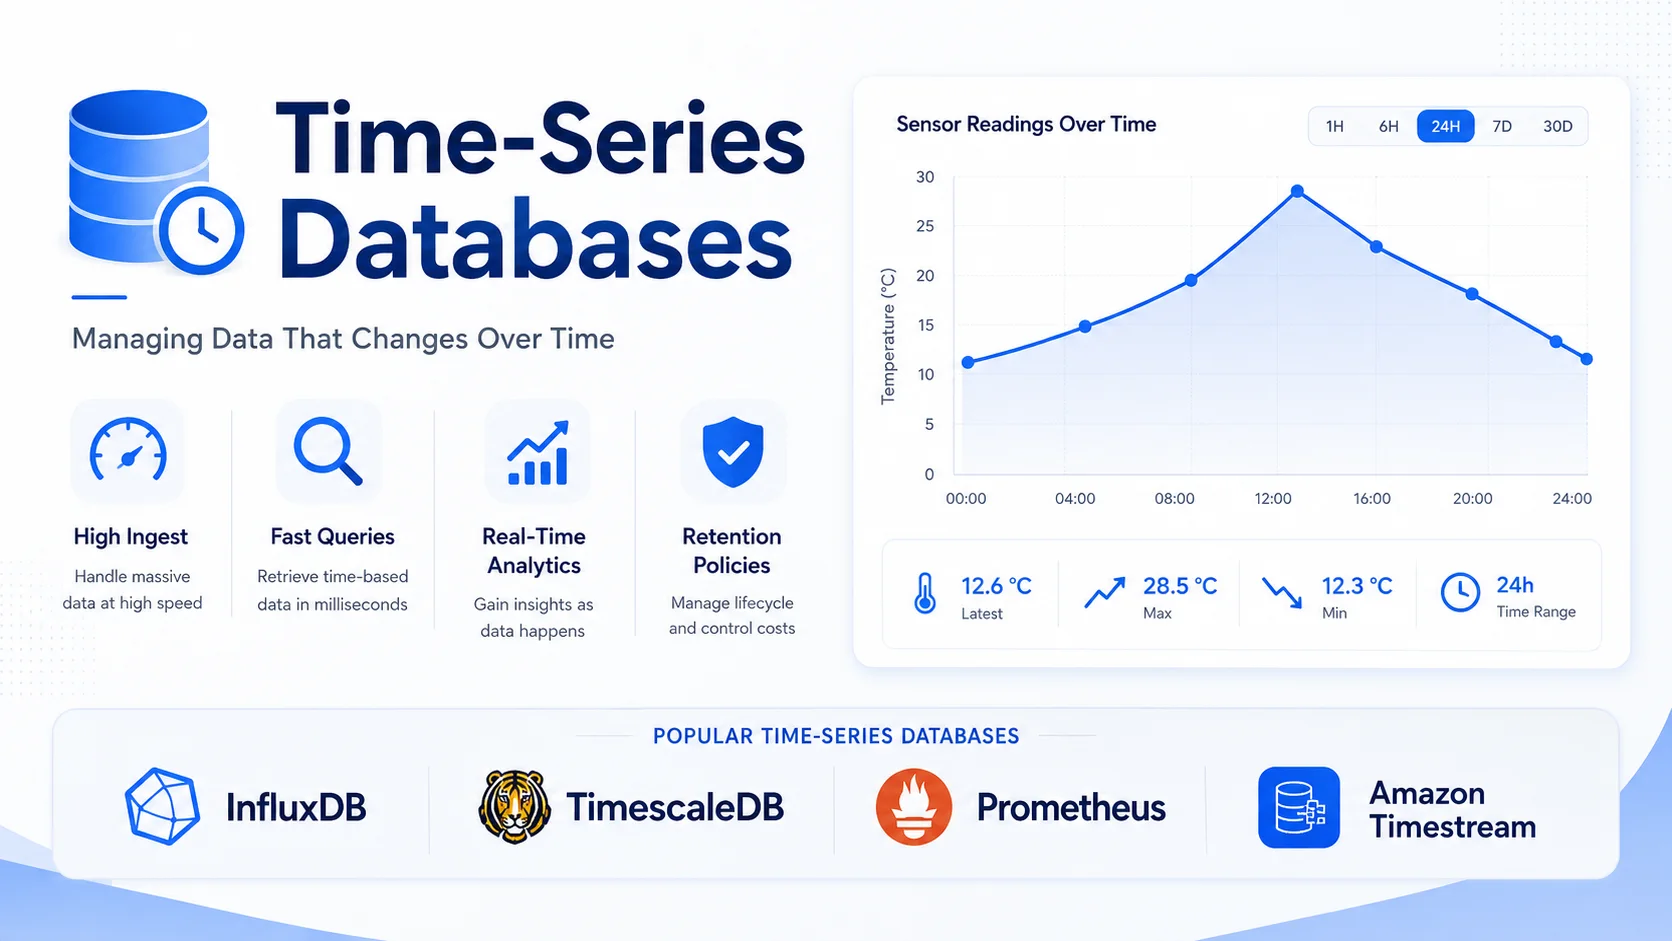
Eine Zeitreihendatenbank (TSDB) ist auf die Speicherung und Abfrage von zeitindizierten Datenpunkten spezialisiert – Sensormesswerte, Servermetriken, Anwendungsprotokolle, Finanz-Tick-Daten und IoT-Telemetrie. Zeitreihendaten weisen einzigartige Eigenschaften auf, die herkömmliche Datenbanken suboptimal machen:

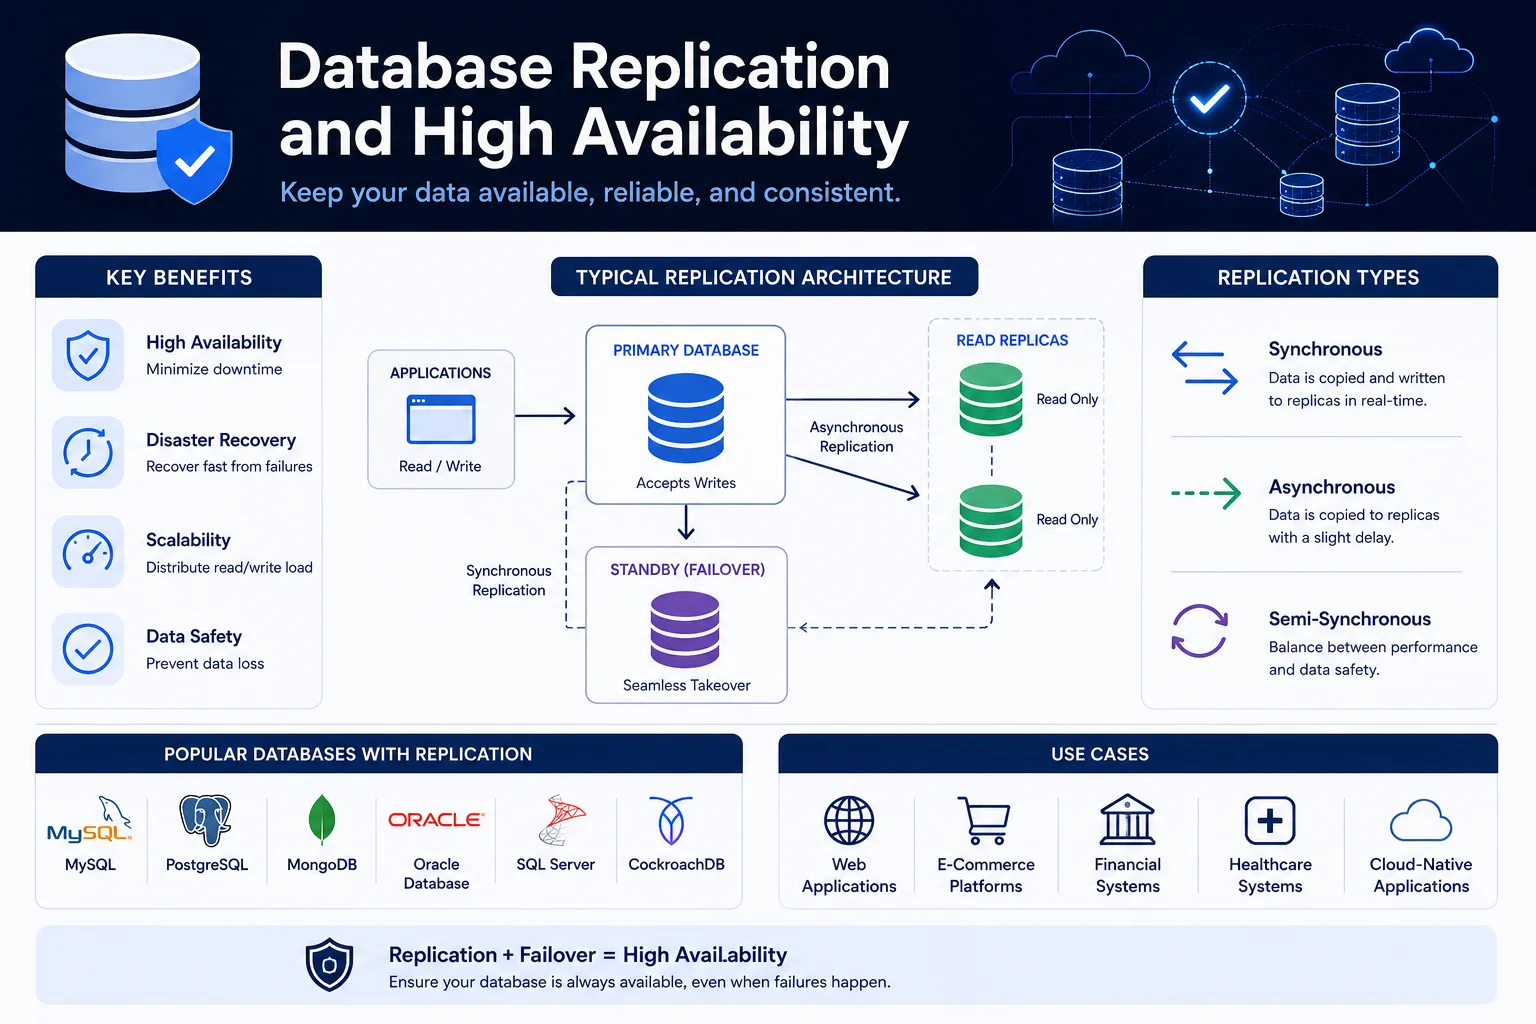
Bei der Datenbankreplikation handelt es sich um den Prozess des Kopierens und Verwaltens von Datenbankdaten auf mehreren Servern. Es ist die Grundlage für Hochverfügbarkeit (HA), Disaster Recovery (DR), Leseskalierung und geografische Verteilung.

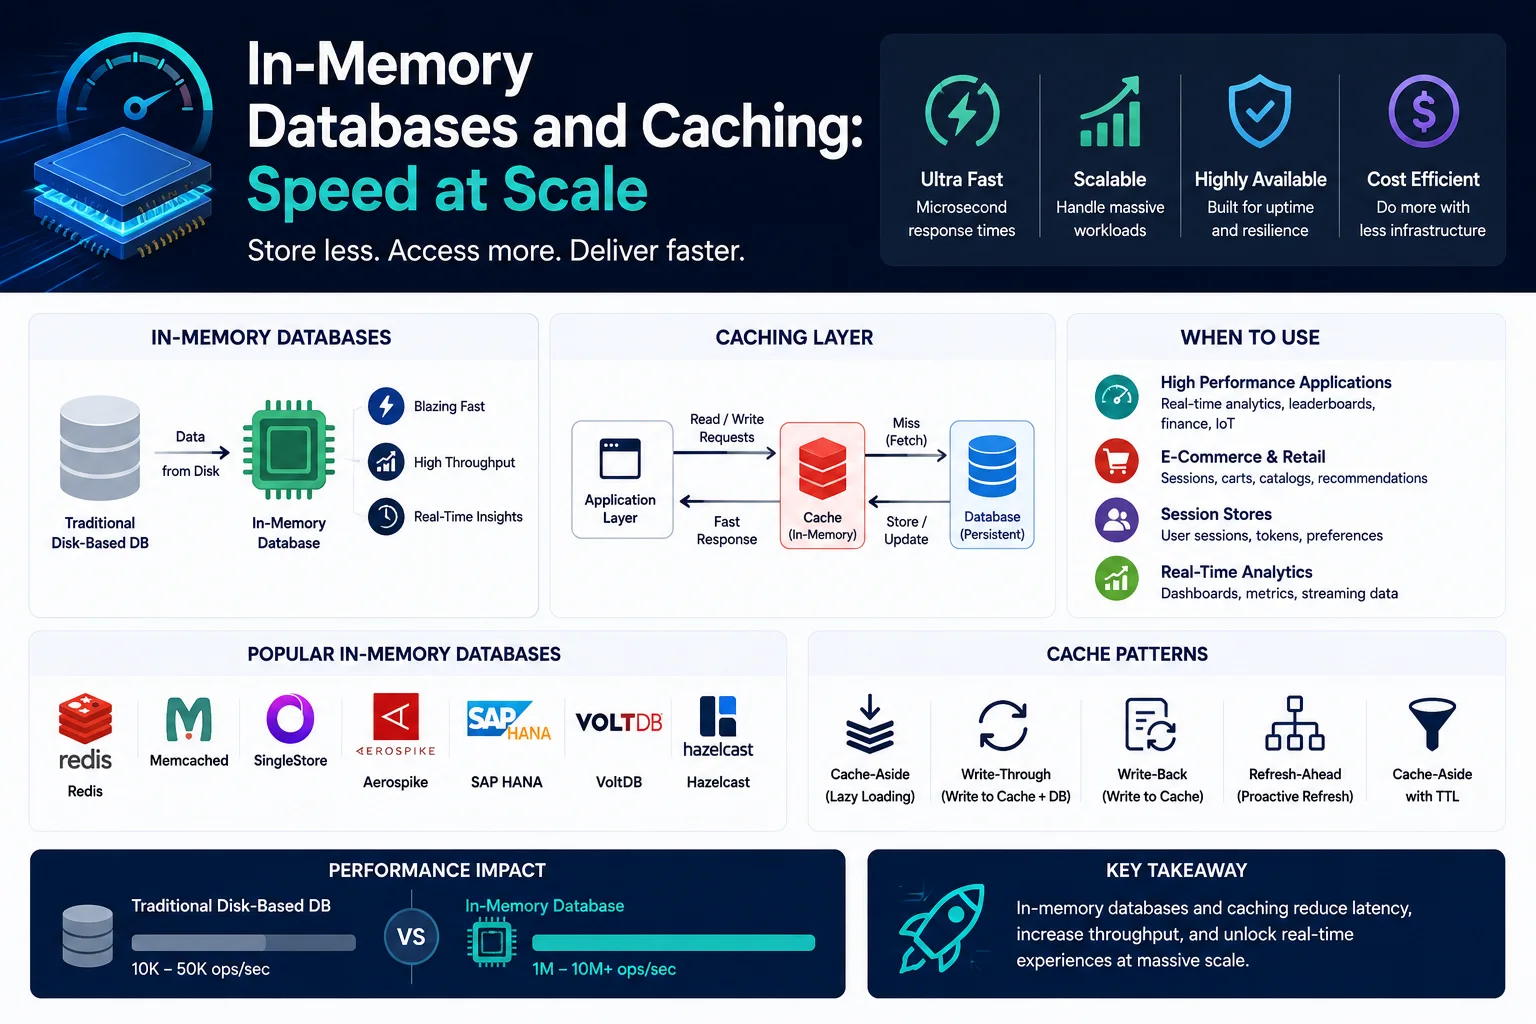
In-Memory-Datenbanken speichern Daten hauptsächlich im RAM und nicht auf der Festplatte. Dadurch entfällt die I/O-Latenz der Festplatte und es werden Reaktionszeiten im Mikrosekundenbereich erreicht – um Größenordnungen schneller als bei herkömmlichen festplattenbasierten Datenbanken.

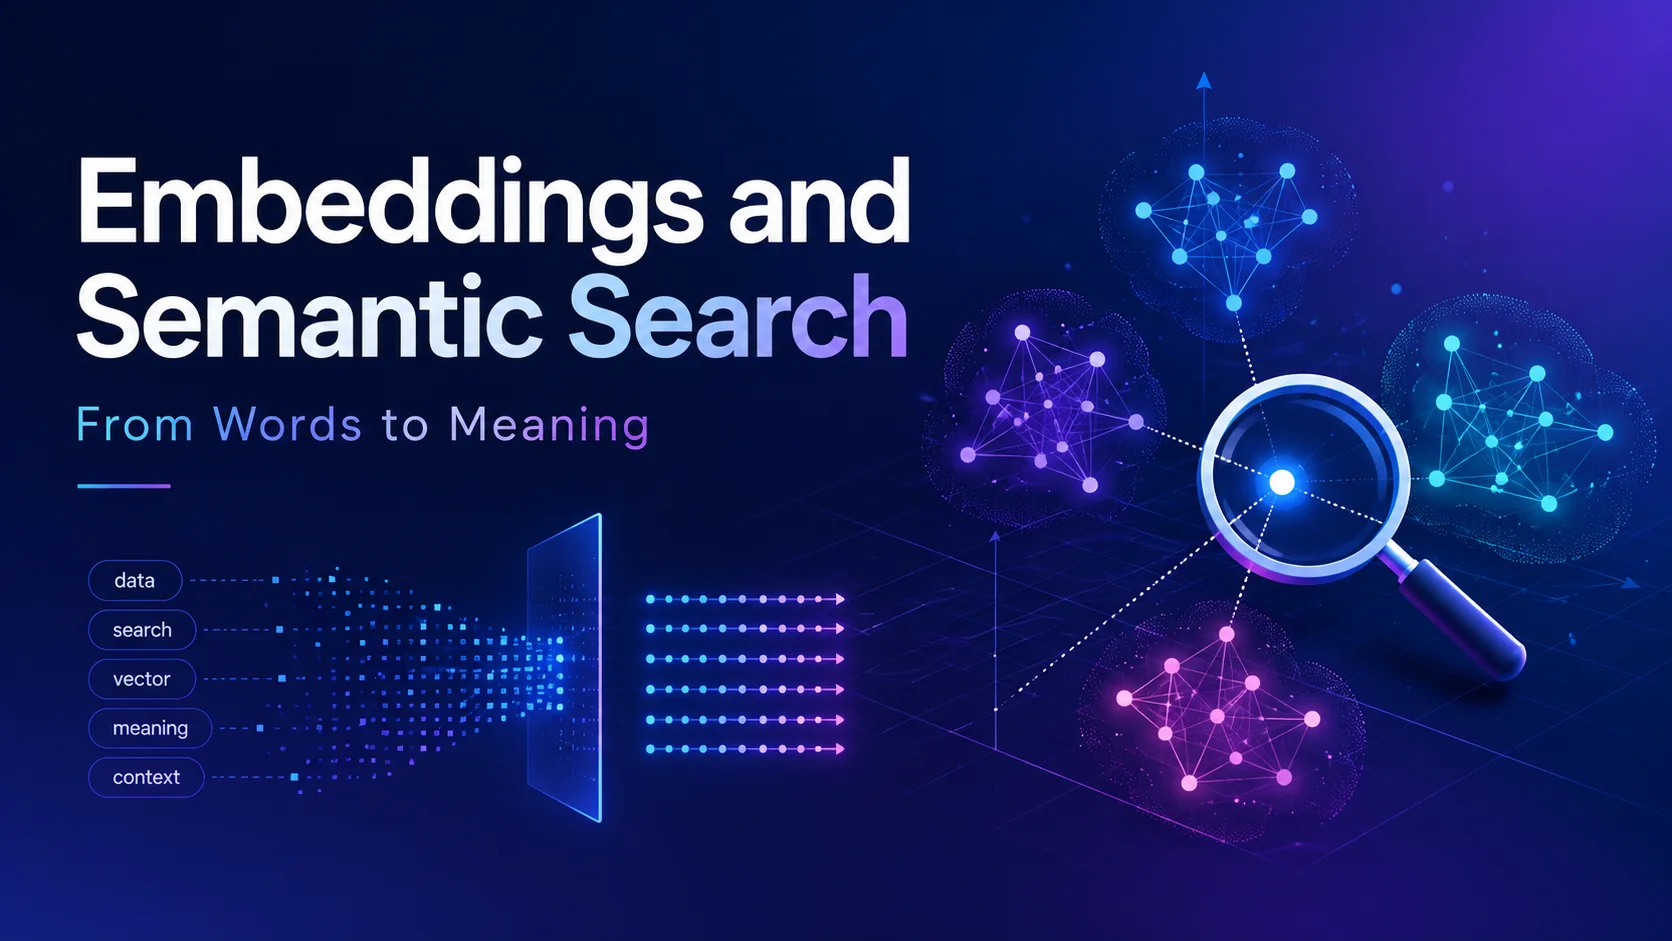
Einbettungen sind die grundlegende Technologie hinter modernen KI-gestützten Such-, Empfehlungs- und Abrufsystemen. Eine Einbettung ist ein dichter numerischer Vektor, der die semantische Bedeutung von Daten darstellt – Text, Bilder, Audio oder jede andere Modalität. Elemente mit ähnlicher Bedeutung haben Vektoren, die im Einbettungsraum nahe beieinander liegen.

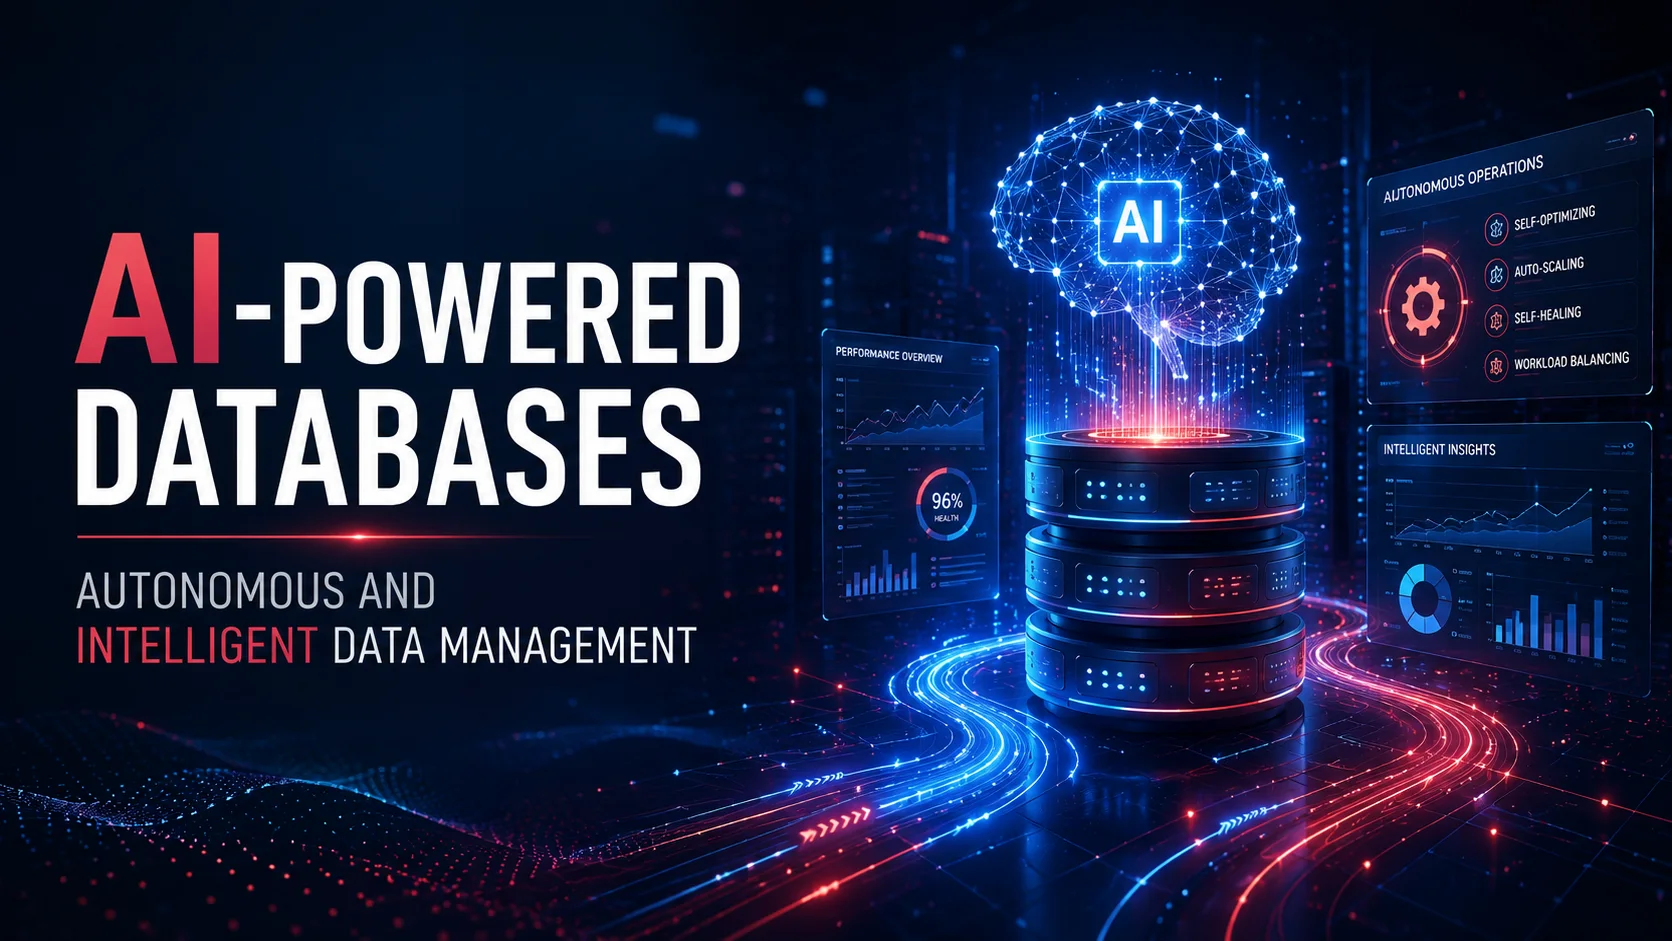
Datenbanken unterliegen einem grundlegenden Wandel, der durch künstliche Intelligenz vorangetrieben wird. So wie KI die Softwareentwicklung neu gestaltet, revolutioniert sie auch die Art und Weise, wie Datenbanken entworfen, betrieben und abgefragt werden. Dies umfasst drei große Bereiche:

Jahrzehntelang war die Datenbankwelt in zwei Lager gespalten: **relationale Datenbanken** (PostgreSQL, MySQL) mit starker Konsistenz, aber begrenzter Skalierbarkeit und **NoSQL-Datenbanken** (MongoDB, Cassandra) mit horizontaler Skalierbarkeit, aber schwächerer Konsistenz und eingeschränkten Abfragemöglichkeiten.

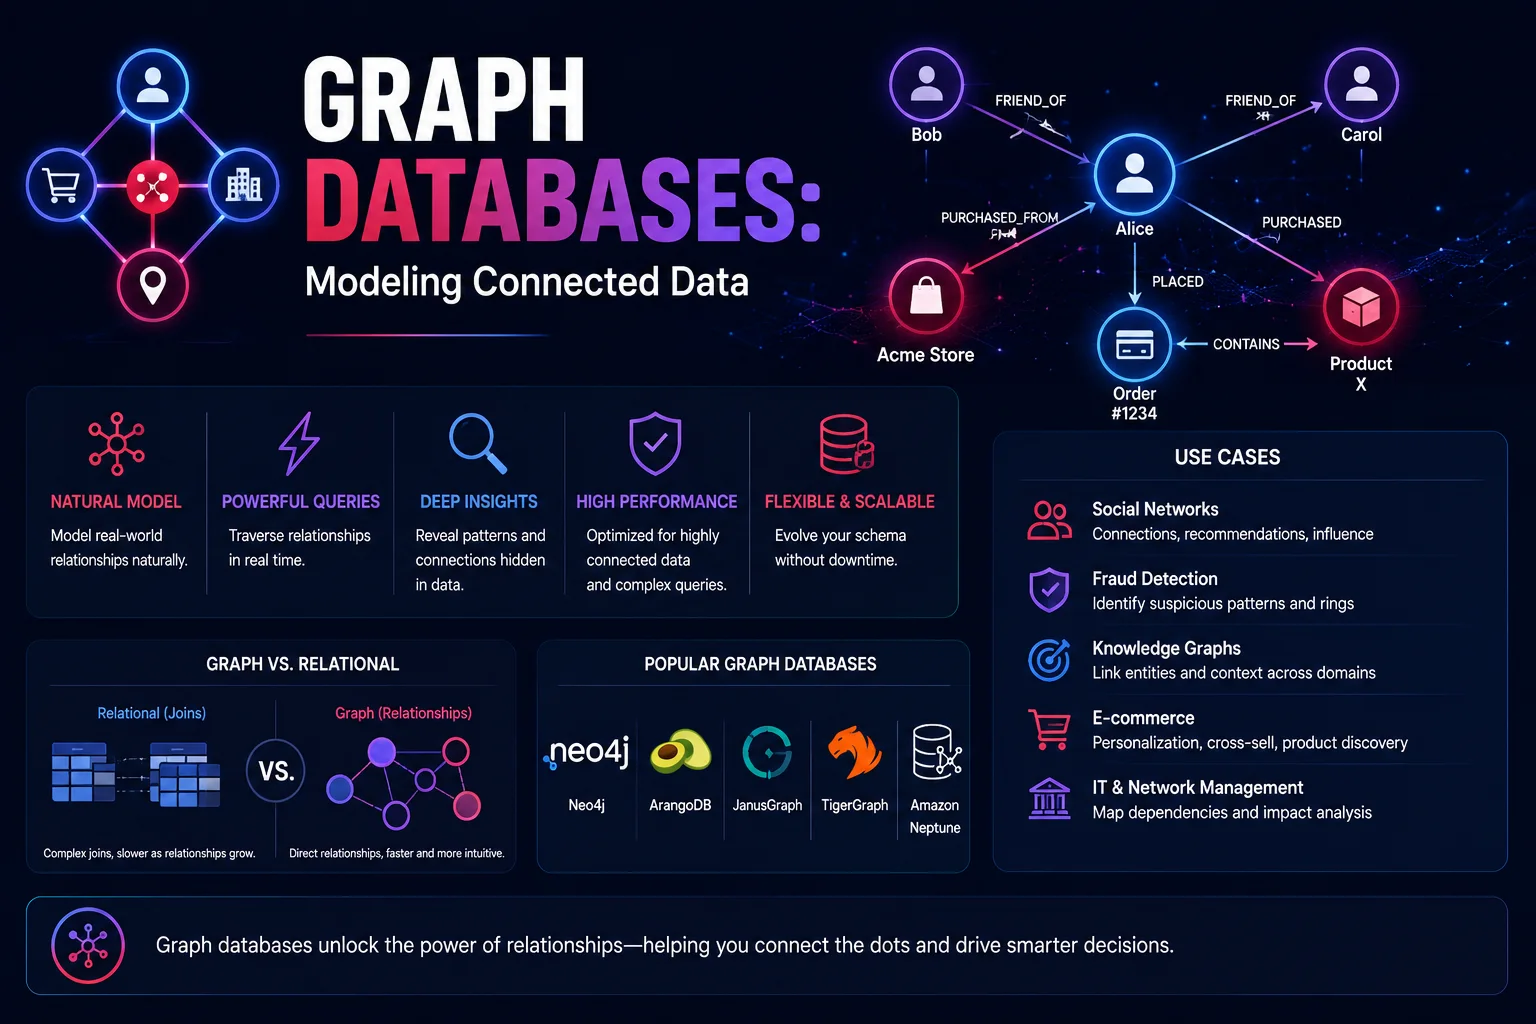
Graphdatenbanken sind speziell für die Speicherung und Abfrage stark vernetzter Daten konzipiert. Während sich relationale Datenbanken bei tabellarischen Daten mit bekannten Beziehungen auszeichnen, zeichnen sich Diagrammdatenbanken aus, wenn Beziehungen genauso wichtig sind wie die Daten selbst – soziale Netzwerke, Empfehlungsmaschinen, Betrugserkennung, Wissensgraphen und Lieferketten.

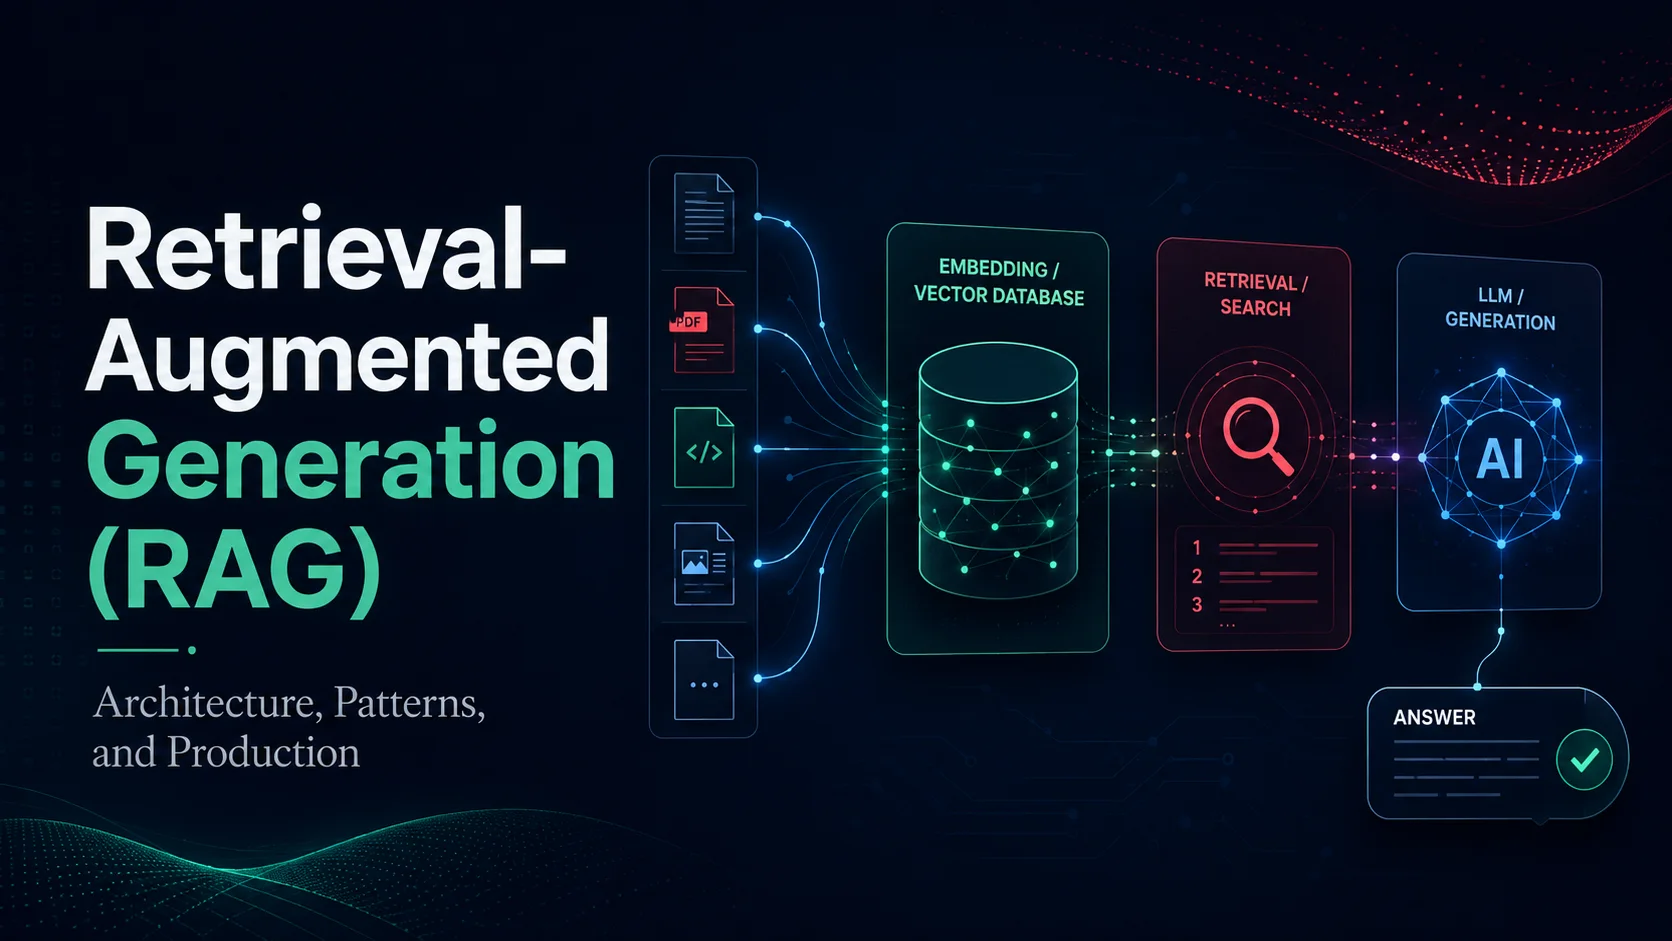
Retrieval-Augmented Generation (RAG) ist eine KI-Architektur, die den Informationsabruf mit großen Sprachmodellen (LLMs) kombiniert. Anstatt sich für Antworten ausschließlich auf die Trainingsdaten des LLM zu verlassen, ruft RAG relevante Informationen aus einer Wissensdatenbank ab und stellt sie dem LLM als Kontext zur Verfügung.