Retrieval-Augmented Generation (RAG): Architektur, Muster und Produktion
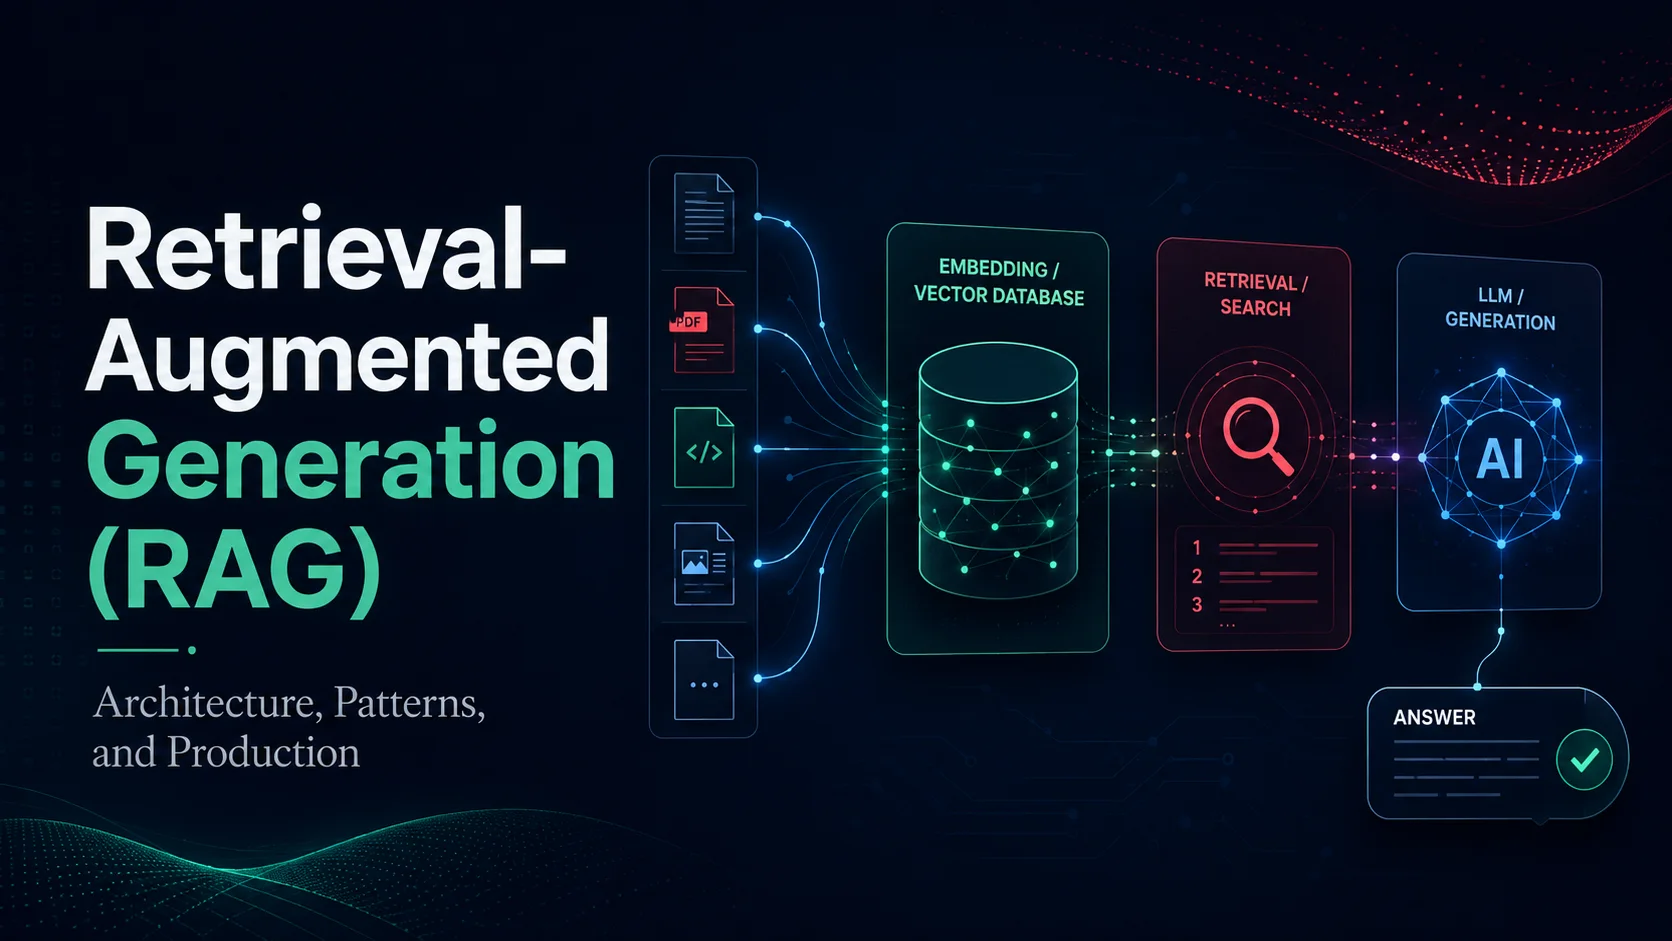
Retrieval-Augmented Generation (RAG) ist eine KI-Architektur, die den Informationsabruf mit großen Sprachmodellen (LLMs) kombiniert. Anstatt sich für Antworten ausschließlich auf die Trainingsdaten des LLM zu verlassen, ruft RAG relevante Informationen aus einer Wissensdatenbank ab und stellt sie dem LLM als Kontext zur Verfügung.
Einführung
Retrieval-Augmented Generation (RAG) ist eine KI-Architektur, die den Informationsabruf mit großen Sprachmodellen (LLMs) kombiniert. Anstatt sich für Antworten ausschließlich auf die Trainingsdaten des LLM zu verlassen, ruft RAG relevante Informationen aus einer Wissensdatenbank ab und stellt sie dem LLM als Kontext zur Verfügung.
Dieser Ansatz löst drei kritische LLM-Einschränkungen: veraltetes Wissen (Trainingsdatensperre), Halluzination (Fakten erfinden) und fehlender Zugriff auf private Daten (keine Kenntnis Ihrer internen Dokumente).
Warum RAG?
LLM-Einschränkungen und RAG-Lösungen
| Problem | LLM ohne RAG | LLM mit RAG |
|---|---|---|
| Wissensgrenze | Kennt nur Daten bis zum Trainingsdatum | Ruft aktuelle Informationen aus der Wissensdatenbank ab |
| Halluzination | Kann Fakten erfinden, wenn er unsicher ist | Begründet Antworten im abgerufenen Kontext |
| Private Daten | Hat Ihre internen Dokumente nicht gesehen | Durchsucht die Wissensdatenbank des Unternehmens |
| Quellenangabe | Quellenangabe ist nicht möglich | Gibt genaue Abschnitte mit Zitaten zurück |
| Kosten | Feinabstimmung ist teuer | Keine Schulung erforderlich – einfach Dokumente indizieren |
RAG vs. Feinabstimmung
| Aspekt | RAG | Feinabstimmung |
|---|---|---|
| Wissensaktualisierungen | Sofort (Vektor-DB aktualisieren) | Wochen (Umschulungsmodell) |
| Schulungskosten | Keine | 100–10.000 $+ |
| Neue Konzepte | Ja – zur Wissensdatenbank hinzufügen | Nein – erfordert eine Umschulung |
| Halluzinationsprävention | Gut (Kontexterdung) | Begrenzt (Auswendiglernen) |
| Quellenangabe | Ja | Nein (Blackbox) |
| Latenz | Höher (Abruf + Generierung) | Niedriger (nur Generation) |
| Wann zu verwenden | Benötigen Sie aktuelle Informationen, Zitate und private Daten | Verhalten, Ton und Ausgabeformat des Modells müssen geändert werden |
RAG-Architektur
High-Level-Flow
                      ┌───────────────────────┐
                      │   Document Processing  │ (Ingestion Pipeline)
                      │   (Chunking → Embed)   │
                      └──────────┬────────────┘
                                 │
                                 ▼
                      ┌───────────────────────┐
                      │   Vector Database     │
                      │   (Knowledge Base)    │
                      └──────────┬────────────┘
                                 │
                      ┌──────────▼────────────┐
User Query ──────────►│   Retrieval Pipeline   │
                      │  (embed → search →     │
                      │   fetch chunks)        │
                      └──────────┬────────────┘
                                 │ (relevant chunks)
                                 ▼
                      ┌───────────────────────┐
                      │   Generation          │
                      │  (LLM + Context)      │
                      └──────────┬────────────┘
                                 │ (answer with citations)
                                 ▼
                           Final Answer
Die Ingestion-Pipeline
1. Laden des Dokuments
from langchain_community.document_loaders import (
    PDFLoader, TextLoader, CSVLoader,
    UnstructuredHTMLLoader, ConfluenceLoader
)

# Load various document types
loaders = {
    '.pdf': PDFLoader("policy.pdf"),
    '.txt': TextLoader("readme.txt"),
    '.html': UnstructuredHTMLLoader("page.html"),
    '.csv': CSVLoader("data.csv"),
}

documents = []
for ext, loader in loaders.items():
    documents.extend(loader.load())
2. Chunking-Strategie
Chunking ist von entscheidender Bedeutung – zu klein geht der Kontext verloren, zu groß enthält Rauschen:
from langchain.text_splitter import (
    RecursiveCharacterTextSplitter,
    TokenTextSplitter,
    SemanticChunker
)

# Recursive character splitting (most common)
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    separators=["\n\n", "\n", " ", ""],
    length_function=len,
)

# Semantic chunking (AI-aware — splits at topic boundaries)
semantic_splitter = SemanticChunker(
    embeddings=openai_embeddings,
    breakpoint_threshold_type="percentile",
)

chunks = text_splitter.split_documents(documents)
Chunking-Kompromisse
| Strategie | Stückgröße | Rückruf | Präzision | Am besten für |
|---|---|---|---|---|
| Kleine Stücke | 200-500 Token | Hoch | Niedrig (fragmentiert) | FAQ, Definitionen |
| Mittlere Stücke | 500-1500 Token | Mittel | Mittel | Allgemeines RAG |
| Große Stücke | 1500-3000 Token | Niedrig | Hoch | Zusammenfassung |
| Semantische Blöcke | Variabel | Hoch | Hoch | Komplexe Dokumente |
3. Einbettung
from langchain_openai import OpenAIEmbeddings
from langchain_qdrant import QdrantVectorStore

embeddings = OpenAIEmbeddings(
    model="text-embedding-3-small",
    dimensions=1536,
)

vector_store = QdrantVectorStore.from_documents(
    documents=chunks,
    embedding=embeddings,
    url="http://localhost:6333",
    collection_name="knowledge_base",
)
Die Retrieval-Pipeline
1. Abfrageverständnis
from langchain.llms import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

def rewrite_query(original_query: str) -> str:
    """Rewrite user query for better retrieval"""
    prompt = ChatPromptTemplate.from_messages([
        ("system", "You are a query rewriting assistant. "
         "Rewrite the user's question to be more specific "
         "and searchable in a knowledge base."),
        ("user", original_query),
    ])
    llm = ChatOpenAI(model="gpt-4o-mini")
    return llm.invoke(prompt).content

# Example:
# Original: "What about vacation?"
# Rewritten: "What is the company policy on paid vacation days,
#             including accrual rate and carry-over limits?"
2. Retrieval-Strategien
Einfache Ähnlichkeitssuche:
results = vector_store.similarity_search_with_score(
    query=rewritten_query,
    k=5,
    score_threshold=0.75,
)
Hybridsuche (Vektor + Schlüsselwort):
# BM25 keyword scores combined with vector similarity
from langchain.retrievers import BM25Retriever, EnsembleRetriever

bm25_retriever = BM25Retriever.from_documents(chunks, k=5)
vector_retriever = vector_store.as_retriever(search_kwargs={"k": 5})

# Weighted ensemble
ensemble_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, bm25_retriever],
    weights=[0.7, 0.3],
)
Abruf mit mehreren Abfragen:
def generate_sub_queries(query: str, n: int = 3) -> list[str]:
    """Generate multiple perspectives on the same query"""
    prompt = f"Generate {n} different versions of this query for search: {query}"
    response = llm.invoke(prompt)
    return response.content.split('\n')

sub_queries = generate_sub_queries("remote work policy")
# Returns:
# - "How many days per week can employees work from home?"
# - "Remote work eligibility and approval process"
# - "Company work-from-home policy and guidelines"

all_results = []
for q in sub_queries:
    all_results.extend(vector_store.similarity_search(q, k=3))
3. Neubewertung
Verbessern Sie die Abrufqualität, indem Sie die Ergebnisse mit einem Cross-Encoder neu einordnen:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

pairs = [(query, result.page_content) for result in initial_results]
scores = reranker.predict(pairs)

reranked_results = [
    result for _, result in
    sorted(zip(scores, initial_results), key=lambda x: x[0], reverse=True)
]

# Take top 3 after reranking
final_context = reranked_results[:3]
Die Generationspipeline
System-Prompt-Engineering
rag_prompt = """You are a helpful assistant that answers questions based
on the provided context. Follow these rules:

1. Answer ONLY using information from the provided context.
2. If the context does not contain the answer, say
   "I don't have enough information to answer this question."
3. Do NOT make up or infer information not in the context.
4. Include citations in [Source: filename.pdf] format.
5. Be concise but thorough.
6. Format lists and tables using markdown when appropriate.

Context:
{context}

Question: {question}
Answer (with citations):"""
Generierung mit Zitaten
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

qa_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    chain_type="stuff",  # "stuff" = put all context in one prompt
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    chain_type_kwargs={
        "prompt": PromptTemplate.from_template(rag_prompt),
        "verbose": True,
    },
    return_source_documents=True,
)

result = qa_chain.invoke({"query": "What is the vacation policy?"})

print(result['result'])
# "Employees accrue 15 days of paid vacation per year (accrued monthly
# at 1.25 days/month). Unused days may carry over up to 5 days to the
# next calendar year. [Source: HR_Handbook_2026.pdf]"

print(result['source_documents'])
# [Document(page_content="...", metadata={"source": "HR_Handbook_2026.pdf", ...})]
Erweiterte RAG-Muster
1. Multi-Hop-RAG
Bei Fragen, die Informationen aus mehreren Dokumenten erfordern:
Q: "Which products are affected by the new regulation and who needs training?"

Step 1: Retrieve regulation document → identifies affected product categories
Step 2: Use product list to query training documents
Step 3: Compose answer from both sources
2. Agentisches RAG
Verwenden Sie einen LLM-Agenten, um den Abruf zu planen, zu entscheiden, welche Tools verwendet werden sollen, und zu iterieren:
from langchain.agents import AgentExecutor, create_openai_functions_agent
from langchain.tools import Tool

retrieval_tool = Tool(
    name="search_knowledge_base",
    func=lambda q: vector_store.similarity_search(q, k=3),
    description="Search company knowledge base for policies and procedures"
)

calculator_tool = Tool(
    name="calculator",
    func=lambda expr: eval(expr),
    description="Perform mathematical calculations"
)

agent = create_openai_functions_agent(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    tools=[retrieval_tool, calculator_tool],
    prompt=agent_prompt,
)
agent_executor = AgentExecutor(agent=agent, tools=[retrieval_tool, calculator_tool])
3. Selbstreflexives RAG (Selbst-RAG)
Das Modell überprüft seine eigene Abruf- und Generierungsqualität:
def self_rag(query: str) -> str:
    # 1. Retrieve
    docs = retrieve(query, k=5)

    # 2. Check: is retrieved info relevant?
    relevance_score = check_relevance(query, docs)

    if relevance_score < 0.7:
        return "I cannot find relevant information to answer this question."

    # 3. Generate answer
    answer = generate(query, docs)

    # 4. Check: does answer match retrieved info?
    faithfulness_score = check_faithfulness(answer, docs)

    if faithfulness_score < 0.8:
        return generate_with_constraints(query, docs)  # Regenerate

    # 5. Check: is answer useful?
    usefulness_score = check_usefulness(query, answer)

    return answer
4. Korrektur-RAG (CRAG)
Ruft ab, bewertet und korrigiert vor der Generierung:
def corrective_rag(query):
    # Initial retrieval
    docs = retrieve(query)

    # Evaluate retrieval quality
    quality = evaluate_retrieval(query, docs)

    if quality == "excellent":
        # Direct generation
        return generate(query, docs)

    elif quality == "partial":
        # Re-rank and try again
        docs = rerank_and_retry(query, docs)
        return generate(query, docs)

    else:  # poor
        # Try web search or generate without context
        if web_search_available:
            docs = web_search(query)
            return generate(query, docs)
        else:
            return generate_without_context(query)
Überlegungen zu Produktions-RAGs
Bewertungsmetriken
| Metrisch | Was es misst | Ziel |
|---|---|---|
| Abrufrückruf | Haben wir alle relevanten Brocken gefunden? | > 0,90 |
| Kontextpräzision | Sind abgerufene Chunks tatsächlich relevant? | > 0,85 |
| Treue | Bleibt die Antwort dem Kontext treu? | > 0,95 |
| Antwortrelevanz | Beantwortet die Antwort die Frage? | > 0,90 |
| Halluzinationsrate | Prozentsatz erfundener Fakten | < 1 % |
Überwachung
class RAGMonitor:
    def __init__(self):
        self.metrics = {
            'retrieval_latency': [],
            'generation_latency': [],
            'context_token_count': [],
            'completion_token_count': [],
        }

    def log_query(self, query: str, retrieval_time: float,
                  gen_time: float, context: str, response: str):
        self.metrics['retrieval_latency'].append(retrieval_time)
        self.metrics['generation_latency'].append(gen_time)
        # Track context size — too large = expensive, too small = poor quality
        self.metrics['context_token_count'].append(count_tokens(context))
        # Log for later analysis
        log_to_db(query, response, context)

    def alert_if_degraded(self):
        avg_latency = mean(self.metrics['generation_latency'][-100:])
        if avg_latency > 5.0:  # seconds
            alert_pagerduty("RAG generation latency degraded")
Latenzbudget
Total RAG latency: 1.5-4 seconds
├── Query embedding:      100-300ms
├── Vector search:         50-200ms
├── Reranking:            100-300ms
├── Context formatting:    10-50ms
└── LLM generation:      1000-3000ms (depends on output length)
Best Practices für Chunking und Indexierung
| Üben | Warum | Umsetzung |
|---|---|---|
| Metadatenspeicher | Filterung, Herkunft, Zitate | Speichern Sie Dateinamen, Seitenzahl, Abschnittstitel und Datum |
| Eltern-Kind-Chunking | Kleine Teile abrufen, großen Kontext zurückgeben | Speichern Sie kleine Blöcke für die Suche und verknüpfen Sie sie mit dem übergeordneten Element für die Generierung |
| Zusammenfassung des Dokuments | Globaler Kontext für umfassende Fragen | Speichern Sie eine Zusammenfassung pro Dokument und verwenden Sie diese für die anfängliche Filterung |
| Inhaltsdeduplizierung | Vermeiden Sie redundanten Kontext | Hash-Blöcke, Beinahe-Duplikate entfernen |
| Versionierung | Verfolgen Sie Dokumentaktualisierungen | Versionsfeld zu Metadaten hinzufügen, Rollback unterstützen |
Fazit
RAG ist die praktischste Möglichkeit, LLMs mit präzisem, aktuellem und nachvollziehbarem Wissen bereitzustellen. Wichtige Erkenntnisse:
- RAG > Feinabstimmung für die meisten Anwendungsfälle – günstiger, flexibler, aktualisierbar.
- Die Chunking-Qualität bestimmt die RAG-Qualität – investieren Sie Zeit in die Suche nach der richtigen Strategie.
- Hybridsuche schlägt reine Vektorsuche – kombinieren Sie sie mit einem Schlüsselwort für eine bessere Erinnerung.
- Eine Neubewertung ist den zusätzlichen Schritt wert – verbessert die Ergebnisqualität erheblich.
- Überwachen Sie auf Verschlechterungen – Abweichungen bei der Abrufqualität, wenn Dokumente hinzugefügt werden.
- Einfach beginnen, Komplexität nach Bedarf hinzufügen – einfaches RAG funktioniert gut; Fortgeschrittene Muster lösen spezifische Probleme.
RAG entwickelt sich rasant weiter – mit Agenten-, Selbstreflexions- und Korrekturvarianten, die die Grenzen dessen verschieben, was abrufgestützte Systeme leisten können.
Empfohlene Artikel

6 Coding-Patterns, die ich von Senior Engineers gelernt habe

Einen privaten KI-Assistenten für Notizen bauen
Mache aus Markdown-Notizen einen durchsuchbaren Assistenten, ohne private Entwürfe offenzulegen.

Rechnungsdaten mit OCR automatisiert auslesen
Baue eine Pipeline, die Rechnungen liest, Felder extrahiert und unsichere Werte markiert.
Kommentare
0 KommentareNoch keine freigegebenen Kommentare sichtbar. Neue Antworten können moderiert werden.