Arquitectura sin servidor
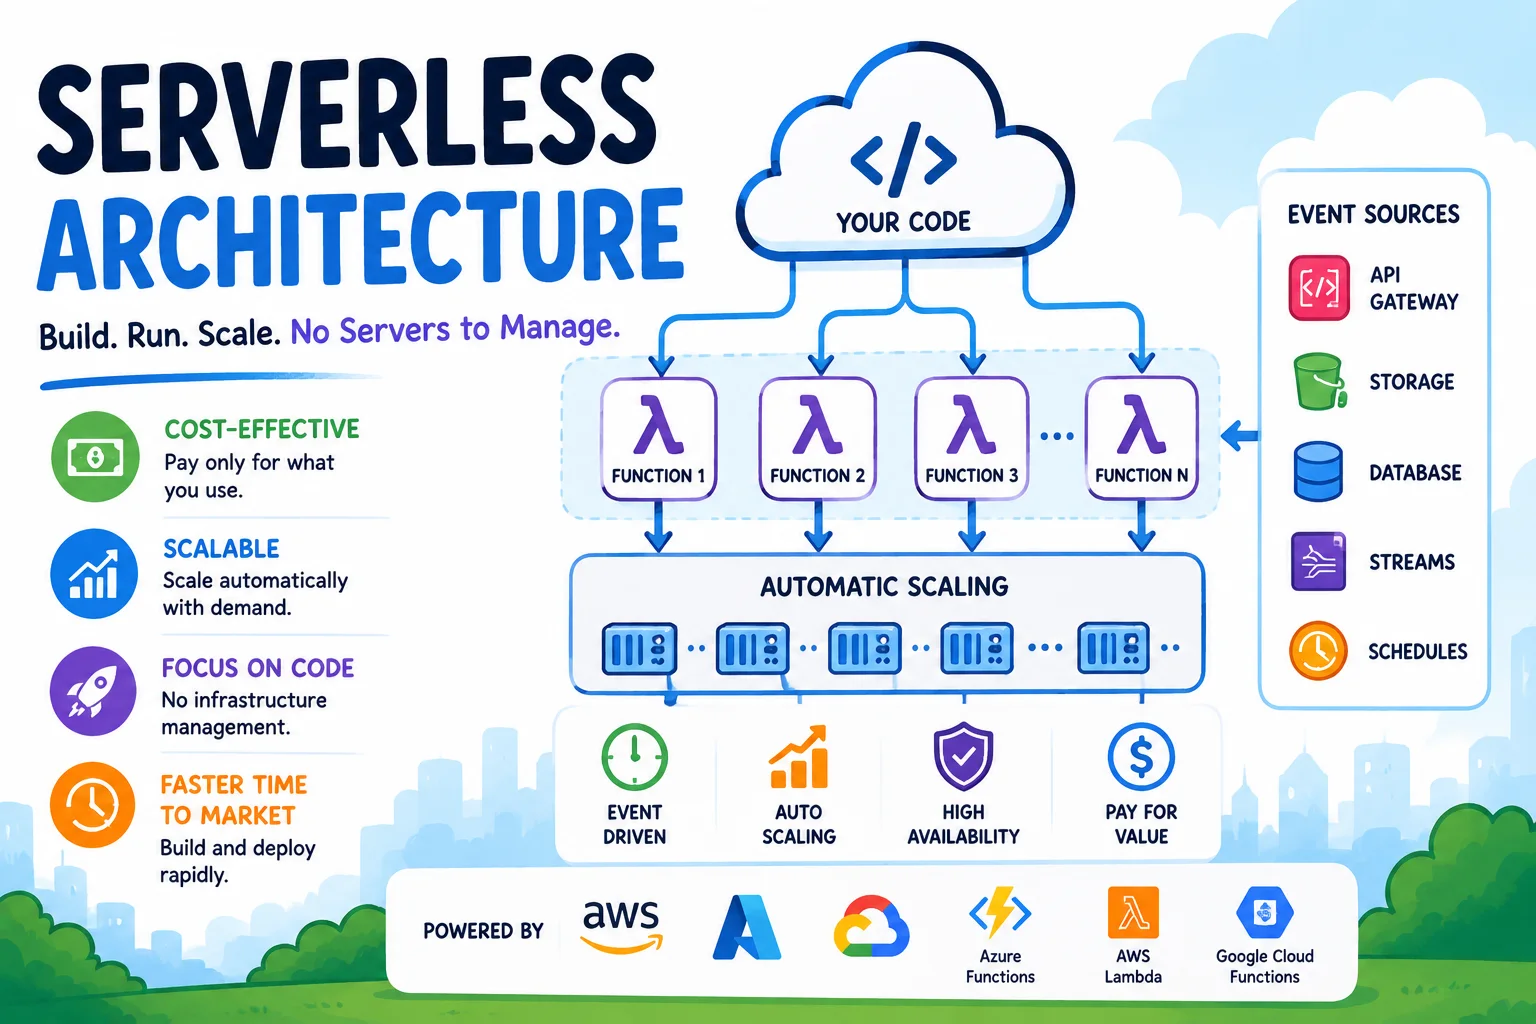
La informática sin servidor permite a los desarrolladores crear y ejecutar aplicaciones sin administrar servidores. El proveedor de la nube maneja toda la infraestructura: aprovisionamiento, escalamiento, parches y mantenimiento. Los desarrolladores escriben funciones, configuran activadores y la plataforma se encarga del resto.
Introducción
La informática sin servidor permite a los desarrolladores crear y ejecutar aplicaciones sin administrar servidores. El proveedor de la nube maneja toda la infraestructura: aprovisionamiento, escalamiento, parches y mantenimiento. Los desarrolladores escriben funciones, configuran activadores y la plataforma se encarga del resto.
El nombre "sin servidor" es engañoso: los servidores todavía están involucrados. Pero el desarrollador nunca piensa en ellos. Este cambio de la gestión de infraestructura a la lógica pura de las aplicaciones está transformando la forma en que se crean e implementan las aplicaciones.
Cómo funciona la tecnología sin servidor
El modelo de ejecución
                     ┌─────────────────────┐
                     │   Event Source      │
                     │ (HTTP, Queue, Timer,│
                     │  Storage, etc.)     │
                     └──────────┬──────────┘
                                │ Trigger
                                ▼
┌──────────────────────────────────────────────────┐
│              Serverless Function                 │
│  ┌────────────────────────────────────────────┐  │
│  │   1. Cold Start (if needed)               │  │
│  │      - Provision sandbox                  │  │
│  │      - Initialize runtime (Node, Python)  │  │
│  │      - Load dependencies                  │  │
│  ├────────────────────────────────────────────┤  │
│  │   2. Execute handler function              │  │
│  │   3. Return response                       │  │
│  └────────────────────────────────────────────┘  │
│              Auto-scales horizontally             │
│              from 0 to N concurrent executions    │
└──────────────────────────────────────────────────┘
Función sencilla sin servidor
// AWS Lambda handler
exports.handler = async (event) => {
  const { name } = JSON.parse(event.body);

  const response = {
    statusCode: 200,
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({
      message: `Hello, ${name}!`,
      timestamp: new Date().toISOString()
    })
  };

  return response;
};
Arquitectura sin servidor versus arquitectura tradicional
| Aspecto | Tradicional (servidores) | Sin servidor |
|---|---|---|
| Gestión de servidores | Requerido (parches, actualizaciones) | Ninguno |
| Escalado | Grupos de escalado manual o automático | Automático, de 0 a 1000s |
| Facturación | Por hora/instancia (costo inactivo) | Por ejecución + por memoria (sin costo de inactividad) |
| Arranques en frío | N/A (siempre activado) | 100 ms-1 s para la invocación inicial |
| Ejecución máxima | Ilimitado | Tiempo de espera (15 min Lambda, 10 min Funciones de nube) |
| Estado | Persistente (estado en memoria) | Apátrida por diseño |
| Implementación | Servidor o contenedor completo | Función única |
| Granularidad | Monolito o servicio | Función única |
Orígenes de eventos sin servidor
Desencadenantes comunes
| Fuente del evento | Proveedor | Caso de uso |
|---|---|---|
| HTTP (Puerta de enlace API) | AWS, Azure, GCP | API REST, webhooks |
| Cambio de base de datos (CDC) | Flujos de DynamoDB, fuente de cambios de CosmosDB, Firestore | Sincronizar datos, activar flujos de trabajo |
| Carga de archivos | S3, almacenamiento de blobs, almacenamiento en la nube | Procesamiento de imágenes, validación de archivos. |
| Cola de mensajes | SQS, almacenamiento en cola, Pub/Sub | Procesamiento asíncrono desacoplado |
| Transmitir | Kinesis, centros de eventos, pub/sub | Procesamiento de datos en tiempo real |
| Horario | Eventos de CloudWatch, temporizador, programador | Trabajos cron, procesamiento por lotes |
| Correo electrónico | SES, SendGrid | Procesamiento de correo electrónico |
| IoT | Núcleo de IoT, Event Grid | Procesamiento de telemetría del dispositivo |
Función de eventos múltiples
# AWS SAM template — Function triggered by multiple events
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31

Resources:
  OrderProcessor:
    Type: AWS::Serverless::Function
    Properties:
      CodeUri: src/
      Handler: orders.handler
      Runtime: nodejs20.x
      Events:
        HttpPost:
          Type: Api
          Properties:
            Path: /orders
            Method: POST
        QueueConsumer:
          Type: SQS
          Properties:
            Queue: !GetAtt OrderQueue.Arn
            BatchSize: 10
        StreamProcessor:
          Type: DynamoDB
          Properties:
            Stream: !GetAtt OrdersTable.StreamArn
            StartingPosition: TRIM_HORIZON
Creación de una aplicación sin servidor
Ejemplo: canal de procesamiento de imágenes
                  ┌──────────┐
                  │ User     │
                  │ Uploads  │
                  └────┬─────┘
                       ▼
              ┌─────────────────┐
              │  S3 Bucket      │
              │  (upload/raw)   │
              └────────┬────────┘
                       │ trigger
                       ▼
              ┌─────────────────┐
              │  Lambda         │
              │  (process.ts)   │
              │                 │
              │   1. Read image │
              │   2. Resize     │
              │   3. Compress   │
              │   4. Extract    │
              │      metadata   │
              └────────┬────────┘
                       │
               ┌───────┴───────┐
               ▼               ▼
        ┌────────────┐  ┌──────────────┐
        │ S3 Bucket  │  │ DynamoDB    │
        │ (processed)│  │ (metadata)  │
        └────────────┘  └──────────────┘
// process.ts — Image processing Lambda
import { S3 } from '@aws-sdk/client-s3';
import { DynamoDB } from '@aws-sdk/client-dynamodb';
import sharp from 'sharp';

const s3 = new S3();
const dynamo = new DynamoDB();

const SUPPORTED_FORMATS = ['image/jpeg', 'image/png', 'image/webp'];

export const handler = async (event: S3Event) => {
  const results = await Promise.allSettled(
    event.Records.map(async (record) => {
      const bucket = record.s3.bucket.name;
      const key = decodeURIComponent(record.s3.object.key.replace(/\+/g, ' '));

      // Validate file type
      const headResult = await s3.headObject({ Bucket: bucket, Key: key });
      if (!SUPPORTED_FORMATS.includes(headResult.ContentType!)) {
        console.log(`Unsupported format: ${headResult.ContentType}`);
        return;
      }

      // Read original
      const { Body } = await s3.getObject({ Bucket: bucket, Key: key });
      const buffer = await Body!.transformToByteArray();

      // Process: resize to multiple sizes
      const sizes = [
        { suffix: 'thumbnail', width: 150, height: 150 },
        { suffix: 'medium', width: 800, height: 600 },
        { suffix: 'large', width: 1920, height: 1080 },
      ];

      for (const size of sizes) {
        const processed = await sharp(buffer)
          .resize(size.width, size.height, { fit: 'cover' })
          .webp({ quality: 80 })
          .toBuffer();

        const outputKey = key.replace('raw', `processed/${size.suffix}`);
        await s3.putObject({
          Bucket: bucket.replace('-raw', '-processed'),
          Key: outputKey,
          Body: processed,
          ContentType: 'image/webp',
        });
      }

      // Store metadata
      await dynamo.putItem({
        TableName: 'ImageMetadata',
        Item: {
          imageId: { S: key },
          originalSize: { N: buffer.byteLength.toString() },
          formats: { SS: ['thumbnail', 'medium', 'large'] },
          uploadedAt: { S: new Date().toISOString() },
        },
      });
    })
  );

  const failed = results.filter(r => r.status === 'rejected');
  if (failed.length > 0) {
    throw new Error(`${failed.length} images failed processing`);
  }

  return { processed: results.length - failed.length, failed: failed.length };
};
Arranques en frío y mitigación
¿Qué causa los arranques en frío?
Cuando una función está inactiva, la plataforma recupera sus recursos. La siguiente invocación requiere:
- Tiempo de ejecución de aprovisionamiento (~50 ms: Node.js, Python; ~500 ms: Java, C#)
- Inicializar dependencias (~50-500 ms dependiendo del tamaño del paquete)
- Ejecutar código del controlador (~10-50ms fuera del controlador)
Arranque en frío total: 100 ms a 2 s según el tiempo de ejecución y el tamaño del paquete.
Tiempos de inicio en frío por tiempo de ejecución
| Tiempo de ejecución | Arranque en frío (mediana) | Arranque en frío (p99) |
|---|---|---|
| pitón | 200 ms | 500ms |
| Nodo.js | 250 ms | 600 ms |
| ir | 100 ms | 300 ms |
| .NET | 500ms | 2s |
| Java | 800ms | 3s |
| óxido | 100 ms | 250 ms |
Estrategias de mitigación
| Estrategia | Cómo funciona | Impacto en los costos |
|---|---|---|
| Simultaneidad aprovisionada (Lambda) | Mantenga N instancias siempre calientes | Paga por instancias cálidas |
| Inicio instantáneo (Lambda) | Preinicialización y tiempo de ejecución de instantáneas | Costo adicional mínimo |
| Pings para mantener el calor | Invocaciones periódicas cada 5 minutos | insignificante |
| Tiempo de ejecución más ligero | Utilice Node.js/Python/Go en lugar de Java | Sin coste adicional |
| Minimizar dependencias | Paquetes de implementación más pequeños | Sin coste adicional |
Costos sin servidor
Modelo de precios
La mayoría de las plataformas sin servidor cobran según:
- Solicitudes: número de invocaciones de funciones.
- Duración: tiempo de ejecución (redondeado al 1 ms o 100 ms más cercano).
- Memoria: memoria configurada por invocación.
Ejemplo de comparación de costos
Scenario: API handling 1M requests/month, 200ms avg execution, 512MB memory

Traditional (t3.small, $0.0208/hr):
  $0.0208 × 730 hours = $15.18/month (always on)

Serverless (Lambda):
  Requests: 1M × $0.20/1M = $0.20
  Duration: 1M × 0.2s × 512MB/1024MB × $0.0000166667/GB-s = $1.67
  Total: $1.87/month

Savings: ~87% at low traffic

Breakeven point: At ~45M requests/month, traditional becomes cheaper
Optimización de costos
# Serverless cost optimization checklist
cost_optimization:
  - "Right-size memory: 128MB may be sufficient, but 1769MB costs 14x more"
  - "Use AWS Compute Optimizer for memory recommendations"
  - "Minimize function duration (optimize code, use async where possible)"
  - "Use reserved concurrency only when needed"
  - "Delete unused functions and resources"
  - "Use Lambda SnapStart for Java/.NET to reduce duration"
  - "Leverage Lambda@Edge or CloudFront Functions for edge processing"
Ecosistema sin servidor
calcular
| Servicio | Proveedor | Característica clave |
|---|---|---|
| AWS Lambda | AWS | Ecosistema más grande, tiempo de espera de 15 minutos |
| Funciones de Azure | microsoft | Integración profunda de Office 365/Teams |
| Funciones en la nube | Integración eventarc primero en Python | |
| Trabajadores de Cloudflare | Llamarada de nube | Basado en el borde, arranques en frío <1 ms, scripts de 30 MB |
Bases de datos
| Servicio | Tipo | Función sin servidor |
|---|---|---|
| DynamoDB | Valor-clave + Documento | Capacidad bajo demanda, escalamiento automático |
| Aurora sin servidor | Relacional (MySQL/PostgreSQL) | Capacidad informática de escalamiento automático |
| CosmosDB | Multimodelo | Modo de rendimiento sin servidor |
| Firestore | Documento | Escalado automático y sincronización en tiempo real |
| Neón | PostgreSQL sin servidor | Ramificación, suspensión automática |
Almacenamiento
| Servicio | Caso de uso |
|---|---|
| S3/Blob/Almacenamiento en la nube | Almacenamiento de archivos, desencadenadores de eventos |
| ElastiCache sin servidor | Almacenamiento en caché en memoria |
| SQS/almacenamiento en cola | Cola de mensajes |
| EventBridge/Event Grid | Autobús de eventos |
Patrones de diseño
1. Patrón de abanico
Procese varios elementos en paralelo:
SQS Queue → Lambda → SNS Topic → Lambda (email)
                                 → Lambda (SMS)
                                 → Lambda (push)
                                 → Lambda (logging)
2. Patrón Saga (Transacciones Distribuidas)
// Order saga with compensation
async function createOrder(event) {
  const { orderId, userId, items, total } = event;

  try {
    await reserveInventory(items);
    await processPayment(userId, total);
    await createShipment(orderId);
    await sendConfirmation(userId);

    return { status: 'completed', orderId };
  } catch (error) {
    // Compensating transactions (undo)
    await cancelShipment(orderId);
    await refundPayment(userId, total);
    await releaseInventory(items);

    throw error;
  }
}
3. Patrón de cola de aceleración
Maneje los picos de tráfico almacenando en búfer las solicitudes:
API Gateway → SQS (buffer) → Lambda (process)
                              ↑
                     Process at your own pace
4. Patrón de abastecimiento de eventos
// Store events, derive current state
interface OrderEvent {
  type: 'CREATED' | 'ITEM_ADDED' | 'PAID' | 'SHIPPED' | 'CANCELLED';
  orderId: string;
  timestamp: string;
  data: Record<string, any>;
}

// Function: store event
exports.recordEvent = async (event: OrderEvent) => {
  await dynamo.putItem({
    TableName: 'OrderEvents',
    Item: marshal(event)
  });
  // Don't modify order state directly
};

// Function: rebuild state from events
exports.getOrderState = async (orderId: string) => {
  const events = await queryEvents(orderId);
  return events.reduce((state, event) => applyEvent(state, event), initialState);
};
Monitoreo y observabilidad sin servidor
Registro estructurado
// Structured logging for serverless
const logger = {
  info: (message: string, context?: object) => {
    console.log(JSON.stringify({
      timestamp: new Date().toISOString(),
      level: 'INFO',
      message,
      aws_request_id: context.awsRequestId,
      function_name: context.functionName,
      ...context
    }));
  },
  error: (message: string, error?: Error) => {
    console.error(JSON.stringify({
      timestamp: new Date().toISOString(),
      level: 'ERROR',
      message,
      error_name: error?.name,
      error_message: error?.message,
      stack: error?.stack,
    }));
  }
};
Seguimiento distribuido
// X-Ray tracing
import { AWS } from '@aws-sdk/client-lambda';
import { captureAWS } from 'aws-xray-sdk-core';

const lambda = captureAWS(new AWS.Lambda());

exports.handler = async (event) => {
  const segment = new Segment('process_order');
  // ... function logic with automatic subsegment tracking
};
Paneles de control
Métricas clave a monitorear:
- Recuento de invocaciones y tasa de error.
- Duración (p50, p95, p99).
- Limitaciones (se excedieron los límites de concurrencia).
- Tasa de arranque en frío.
- Costo por función.
Cuándo NO utilizar Serverless
| Escenario | Por qué la tecnología sin servidor no es ideal | Alternativa |
|---|---|---|
| Procesos de larga duración (>15 min) | Tiempo de espera de ejecución | Contenedores, máquinas virtuales |
| Aplicaciones con estado | Apátrida por diseño | Servicios con estado (WebSocket API, Redis) |
| Alto tráfico constante (>100 solicitudes/s sostenidas) | Los costos exceden la capacidad aprovisionada | Contenedores de escalado automático |
| Requisitos de baja latencia (<10 ms) | Arranque en frío por encima | Simultaneidad aprovisionada, funciones de borde |
| Orquestación compleja | La composición de funciones es difícil | Funciones de paso, flujos de trabajo |
| Funciones específicas de la plataforma | Capacidades de tiempo de ejecución limitadas | Acceso completo al sistema operativo (contenedores) |
Conclusión
La arquitectura sin servidor es ideal para:
- Cargas de trabajo basadas en eventos: procesamiento de archivos, webhooks y notificaciones.
- Patrones de tráfico variables: API con carga impredecible.
- Creación rápida de prototipos: no es necesario configurar ninguna infraestructura.
- Procesamiento en segundo plano: colas, transmisiones, tareas programadas.
- Componentes de microservicio: aísla funcionalidades específicas.
Comience con la tecnología sin servidor para:
- Un nuevo punto final API.
- Un canal de procesamiento de imágenes.
- Un trabajo de agregación de datos programado.
- Un receptor de webhook.
Migre a contenedores cuando:
- El tráfico se vuelve constante y de gran volumen.
- La duración de la ejecución excede constantemente los límites.
- Necesita capacidades específicas a nivel del sistema operativo.
- El análisis de costos muestra que los contenedores son más baratos.
La tecnología sin servidor no es la respuesta a todo, pero para las cargas de trabajo adecuadas, reduce drásticamente la sobrecarga operativa y el tiempo de desarrollo.
Artículos destacados

6 patrones de programación que aprendí de ingenieros senior

Crea un asistente privado de notas con IA
Convierte notas Markdown en un asistente consultable sin exponer borradores privados.

Automatiza la extracción de datos de facturas con OCR
Crea un flujo que lee facturas, extrae campos y marca valores dudosos para revisión.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.