Arquitectura de microservicios
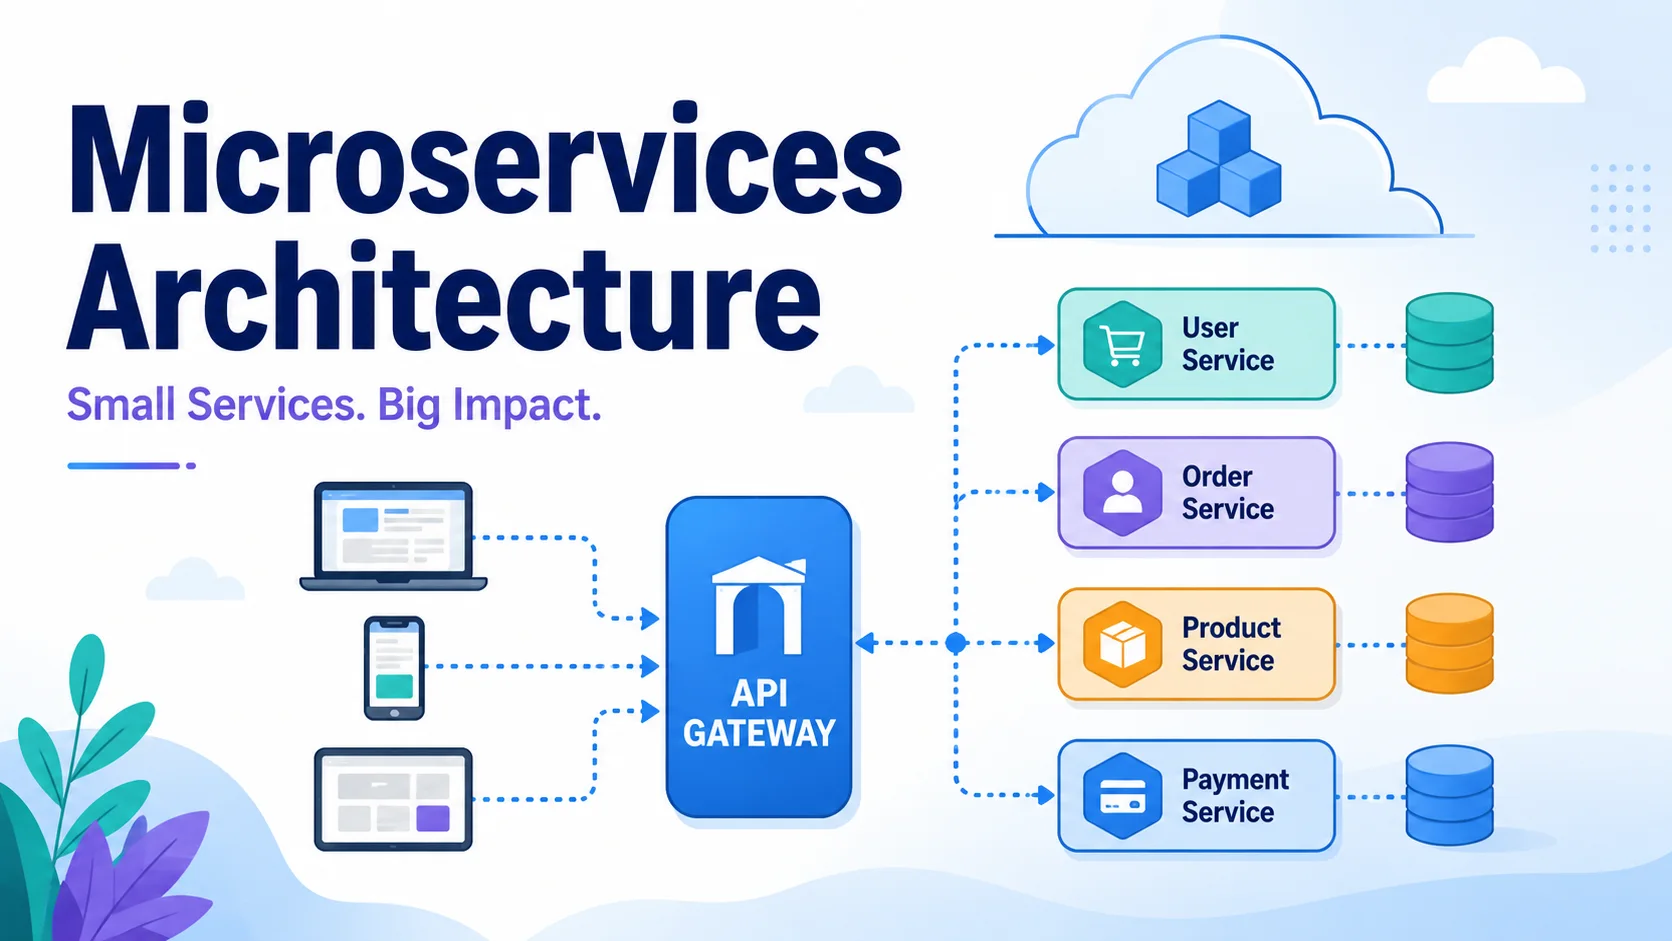
La arquitectura de microservicios estructura una aplicación como una colección de servicios débilmente acoplados y que se pueden implementar de forma independiente. Cada servicio posee una capacidad comercial específica, tiene su propio almacén de datos y se comunica a través de una red. Si bien los microservicios introducen una complejidad operativa significativa, permiten a las organizaciones escalar equipos de desarrollo, implementar de forma independiente y construir sistemas más resistentes.
Introducción
La arquitectura de microservicios estructura una aplicación como una colección de servicios débilmente acoplados y que se pueden implementar de forma independiente. Cada servicio posee una capacidad comercial específica, tiene su propio almacén de datos y se comunica a través de una red. Si bien los microservicios introducen una complejidad operativa significativa, permiten a las organizaciones escalar equipos de desarrollo, implementar de forma independiente y construir sistemas más resistentes.
Monolito versus microservicios
El monolito
Una aplicación monolítica tiene todas las funciones en una única base de código y unidad de implementación:
┌─────────────────────────────────────────────┐
│              Monolith Application           │
├──────────────┬──────────────┬───────────────┤
│  User Module │  Order Module│  Payment      │
│  (controllers, services, repos, DB tables)  │
└──────────────┴──────────────┴───────────────┘
Ventajas del monolito:
- Desarrollo y pruebas simples (proceso único).
- Fácil depuración (sin llamadas de red entre módulos).
- Comunicación rápida (llamadas a métodos en memoria).
- Sin complejidad del sistema distribuido.
- Ideal para equipos pequeños y productos en etapa inicial.
Desventajas del monolito:
- Escalar significa escalar todo, no sólo el cuello de botella.
- Un solo error puede bloquear toda la aplicación.
- La pila de tecnología está bloqueada.
- Una base de código grande se vuelve difícil de entender y mantener.
- La implementación lleva más tiempo a medida que crece el código base.
- Los gastos generales de coordinación del equipo aumentan.
La arquitectura de microservicios
┌──────────────────┐   ┌──────────────────┐   ┌──────────────────┐
│   User Service   │   │   Order Service  │   │  Payment Service │
│   (own DB, API)  │   │  (own DB, API)   │   │  (own DB, API)   │
└────────┬─────────┘   └────────┬─────────┘   └────────┬─────────┘
         │                      │                      │
         └──────────────────────┼──────────────────────┘
                                │
                    ┌───────────▼───────────┐
                    │     API Gateway       │
                    │   (auth, routing)     │
                    └───────────────────────┘
Principios básicos
1. Responsabilidad única
Cada servicio posee exactamente una capacidad comercial. Si puede describir el propósito de un servicio sin utilizar "y", es probable que tenga un buen alcance.
Bien:
servicio de pago: gestiona el procesamiento de pagos y los reembolsos.servicio de notificaciones: envía correos electrónicos, SMS y notificaciones automáticas.inventory-service: gestiona los niveles de stock y las reservas.
Malo:
- "servicio de usuario y pedido": dos capacidades distintas combinadas (viola SRP).
backend-service: todo en un solo servicio (ningún microservicio).
2. Gestión de datos descentralizada
Cada servicio es dueño de su base de datos. Los servicios nunca comparten bases de datos: se comunican a través de API.
-- Service A has its own database
CREATE TABLE users (
    id UUID PRIMARY KEY,
    email VARCHAR(255) UNIQUE,
    name VARCHAR(255)
);

-- Service B has its own database, stores only the user ID
CREATE TABLE orders (
    id UUID PRIMARY KEY,
    user_id UUID NOT NULL,
    total DECIMAL(10,2),
    status VARCHAR(50)
);
¿Por qué no compartir bases de datos?
- Estrecho acoplamiento: los cambios de esquema en un servicio interrumpen otros.
- Los diferentes servicios tienen diferentes necesidades de almacenamiento (relacional, de documento o de gráfico).
- El despliegue independiente se vuelve imposible.
- El escalado requiere migraciones de esquemas coordinadas.
3. Resiliencia y aislamiento de fallas
Una falla en un servicio no debería afectar a otros.
Patrón de disyuntor:
// Using a circuit breaker to handle service failures gracefully
const breaker = new CircuitBreaker({
  failureThreshold: 5,
  resetTimeout: 30000, // 30 seconds
});

async function getPaymentStatus(orderId: string) {
  try {
    return await breaker.call(() => paymentService.getStatus(orderId));
  } catch (error) {
    // Fallback: return cached status or default
    return { status: 'pending', note: 'Payment service unavailable' };
  }
}
Patrón de mamparo: Asigne grupos de subprocesos separados para diferentes servicios para que un servicio lento no agote todos los recursos:
// Separate thread pools per service
const paymentPool = new ThreadPool({ maxThreads: 10 });
const inventoryPool = new ThreadPool({ maxThreads: 20 });
const notificationPool = new ThreadPool({ maxThreads: 5 });
4. Implementabilidad independiente
Cada servicio se puede implementar de forma independiente. Este es el principal beneficio de los microservicios.
Automatización de la implementación:
# GitHub Actions for a single microservice
name: Deploy Payment Service
on:
  push:
    paths:
      - 'services/payment/**'
      - '.github/workflows/payment.yml'
jobs:
  deploy:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: docker build -t payment-service .
      - run: docker push registry.example.com/payment-service:${{ github.sha }}
      - run: kubectl set image deployment/payment-service payment-service=registry.example.com/payment-service:${{ github.sha }}
Patrones de comunicación
Comunicación síncrona (REST, gRPC)
Pros: Fácil de implementar y razonar. La semántica de solicitud-respuesta es familiar.
Contras: Crea un acoplamiento en tiempo de ejecución: si el servicio descendente no funciona, la persona que llama se ve afectada.
// REST call using fetch
const order = await fetch(`http://order-service:8080/api/orders/${orderId}`);
// gRPC definition
service OrderService {
  rpc GetOrder (GetOrderRequest) returns (Order);
}
message GetOrderRequest {
  string order_id = 1;
}
Comunicación asincrónica (colas de mensajes)
Ventajas: Acoplamiento flexible, mejor resiliencia y admite arquitecturas basadas en eventos.
Contras: La coherencia final, más difícil de depurar, requiere infraestructura de mensajes.
// Kafka producer
await producer.send({
  topic: 'order.created',
  messages: [{ value: JSON.stringify({ orderId, userId, total }) }]
});

// Kafka consumer in notification service
await consumer.run({
  eachMessage: async ({ message }) => {
    const { orderId, userId } = JSON.parse(message.value.toString());
    await emailService.sendOrderConfirmation(userId, orderId);
  }
});
Elegir entre síncrono y asíncrono
| Criterios | Sincrónico | Asincrónico |
|---|---|---|
| ¿La persona que llama necesita una respuesta inmediata? | Sí | No |
| ¿Se puede aplazar la operación? | No | Sí |
| ¿El servicio downstream está siempre disponible? | Sí | No requerido |
| ¿Necesitas una fuerte consistencia? | Sí | Eventual está bien |
Estrategias de descomposición
Cómo dividir un monolito
- Identifique contextos delimitados: utilice el diseño basado en dominios (DDD) para encontrar límites naturales.
- Comience con el servicio de mayor valor: extraiga un servicio que tenga un valor independiente claro.
- Extraiga un servicio a la vez: no intente una migración a gran escala.
- Utilice el patrón Higo estrangulador: dirija gradualmente el tráfico desde el monolito hacia el nuevo servicio.
// Strangler Fig pattern
const gateway = express();

// Route to new service if available, fall back to monolith
gateway.use('/api/users', async (req, res, next) => {
  try {
    const response = await fetch('http://user-service/api/users' + req.path);
    return res.json(await response.json());
  } catch {
    next(); // Fall through to monolith handler
  }
});
Directrices de granularidad del servicio
| Tamaño del servicio | Tamaño del equipo | Frecuencia de implementación | Ejemplo |
|---|---|---|---|
| ⚡ Pequeño | 1-3 desarrolladores | Varias veces/día | Verificación de usuario |
| 📐 Medio | 3-6 desarrolladores | Diario/semanal | Procesamiento de pedidos |
| 🏗️ Grande | 6-10 desarrolladores | Semanalmente | Plataforma de pago |
Regla general: Un servicio debe ser lo suficientemente pequeño como para que un solo equipo pueda poseerlo por completo, y lo suficientemente grande como para proporcionar un valor comercial significativo.
Desafíos operativos
Observabilidad
Los microservicios generan enormes cantidades de telemetría. Tres pilares:
1. Registro:
// Structured logging (JSON)
{
  "timestamp": "2026-05-24T10:30:00.123Z",
  "level": "error",
  "service": "payment-service",
  "trace_id": "abc123",
  "message": "Payment processing failed",
  "error": "stripe: insufficient funds",
  "metadata": { "order_id": "ord_456", "amount": 2999 }
}
2. Métricas (formato Prometheus):
# HELP http_requests_total Total HTTP requests
# TYPE http_requests_total counter
http_requests_total{method="POST",path="/api/payments",status="500"} 42
3. Seguimiento distribuido (OpenTelemetry):
# OpenTelemetry auto-instrumentation
OTEL_EXPORTER_OTLP_ENDPOINT: "http://otel-collector:4318"
OTEL_SERVICE_NAME: "payment-service"
OTEL_TRACES_SAMPLER: "parentbased_traceidratio"
OTEL_TRACES_SAMPLER_ARG: "0.1"
Descubrimiento de servicios
En entornos dinámicos (Kubernetes), las direcciones IP cambian. Los servicios se encuentran entre sí a través de DNS:
- Kubernetes DNS —
pago-servicio.namespace.svc.cluster.local. - Cónsul — Registro de servicios con controles de salud.
- Eureka: descubrimiento de servicios de Netflix (Spring Cloud).
Puerta de enlace API
Un único punto de entrada para todas las solicitudes de los clientes:
| Función | Ejemplo |
|---|---|
| Enrutamiento | /api/users → servicio-usuario, /api/orders → servicio-pedido |
| Autenticación | Validar tokens JWT antes de enrutar |
| Limitación de velocidad | 1000 solicitudes/min por cliente |
| Solicitar transformación | Convertir JSON a Protobuf |
| Almacenamiento en caché de respuestas | Caché de respuestas GET |
| ruptura de circuito | Dejar de dirigirse a servicios en mal estado |
Gestión de configuración
Externalizar toda la configuración:
# ConfigMap in Kubernetes
apiVersion: v1
kind: ConfigMap
metadata:
  name: payment-service-config
data:
  DATABASE_URL: "postgresql://..."
  STRIPE_API_KEY: "${STRIPE_API_KEY}"  # from Secret
  MAX_RETRIES: "3"
  FEATURE_FLAG_NEW_CHECKOUT: "true"
Orquestación de contenedores con Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: payment-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: payment-service
  template:
    metadata:
      labels:
        app: payment-service
    spec:
      containers:
      - name: payment-service
        image: registry.example.com/payment-service:latest
        ports:
        - containerPort: 8080
        resources:
          requests:
            memory: "256Mi"
            cpu: "250m"
          limits:
            memory: "512Mi"
            cpu: "500m"
        livenessProbe:
          httpGet:
            path: /health
            port: 8080
          initialDelaySeconds: 10
          periodSeconds: 5
Cuándo NO utilizar microservicios
- Equipos pequeños (< 10 desarrolladores): la sobrecarga cognitiva de los microservicios supera los beneficios.
- Aplicaciones simples — Aplicación CRUD con pocas funciones. Un monolito es más rápido de construir.
- Startups en etapa inicial: la velocidad de iteración importa más que la escalabilidad.
- Límites de dominio poco claros: si no puede identificar los límites del servicio, creará un monolito distribuido.
- Aplicaciones de poco tráfico: la sobrecarga de microservicios (redes, implementación, monitoreo) no está justificada.
Ley de Conway: Las organizaciones diseñan sistemas que reflejan su estructura de comunicación. Si su equipo no está organizado en torno a los límites de los servicios, los microservicios crearán fricciones.
Estrategia de migración
Fase 1: prepararse
- Agregue monitoreo y registro centralizado al monolito.
- Identificar contextos acotados mediante talleres de DDD.
- Extraiga bibliotecas compartidas (autenticación, registro, utilidades).
- Configure CI/CD y contenedorización.
Fase 2: Extracto
- Extraer el primer servicio (menor riesgo, mayor valor).
- Implementa el patrón Strangler Fig.
- Ejecute monolito + nuevo servicio en paralelo.
- Agregue disyuntores y alternativas.
Fase 3: Escala
- Extraiga servicios adicionales de forma iterativa.
- Implementar comunicación basada en eventos cuando sea apropiado.
- Agregue malla de servicios (Istio, Linkerd) para redes avanzadas.
- Invierta en ingeniería de plataformas (backstage, portales de desarrolladores).
Recomendaciones de pila de tecnología
| Categoría | Opciones | Notas |
|---|---|---|
| Estructura | Spring Boot, NestJS, FastAPI, kit Go | Elija según la experiencia del equipo |
| API | DESCANSO, gRPC, GraphQL | gRPC para interno, REST para externo |
| Mensajería | Kafka, RabbitMQ, NATS | Kafka para un alto rendimiento |
| Base de datos | PostgreSQL, DynamoDB, MongoDB | Haga coincidir la base de datos con las necesidades del servicio |
| Recipiente | Estibador | Universal |
| Orquestación | Kubernetes | EKS, AKS, GKE o autogestionado |
| Puerta de enlace API | Kong, enviado, puerta de enlace API de AWS | Enviado para la integración de la malla de servicios |
| Observabilidad | OpenTelemetry, Prometheus, Jaeger | OpenTelemetry es el estándar |
| CI/CD | Acciones de GitHub, GitLab CI, ArgoCD | ArgoCD para GitOps |
| Malla de servicio | Istio, Linkerd, Cilio | Linkerd para simplificar |
| Gestión Secreta | HashiCorp Vault, administrador de secretos de AWS | Bóveda para múltiples nubes |
Conclusión
Los microservicios son un poderoso patrón arquitectónico que permite una implementación independiente, autonomía del equipo y sistemas escalables. Sin embargo, conllevan una complejidad operativa significativa. Las adopciones de microservicios más exitosas:
- Comience con un monolito: comprenda su dominio antes de dividirlo.
- Extraiga servicios de forma incremental: un servicio a la vez.
- Invierta mucho en automatización: CI/CD, monitoreo e infraestructura como código.
- Organizar equipos en torno a los servicios: alinear la estructura del equipo con la arquitectura.
- Adopte la coherencia eventual: no es necesario que todo sea muy coherente.
Los microservicios no son la arquitectura predeterminada: son una solución a problemas organizativos y de escala específicos. Elíjalos deliberadamente, no por defecto.
Artículos destacados

6 patrones de programación que aprendí de ingenieros senior

Crea un asistente privado de notas con IA
Convierte notas Markdown en un asistente consultable sin exponer borradores privados.

Automatiza la extracción de datos de facturas con OCR
Crea un flujo que lee facturas, extrae campos y marca valores dudosos para revisión.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.