Deep Learning explicado: Guía práctica y completa para desarrolladores
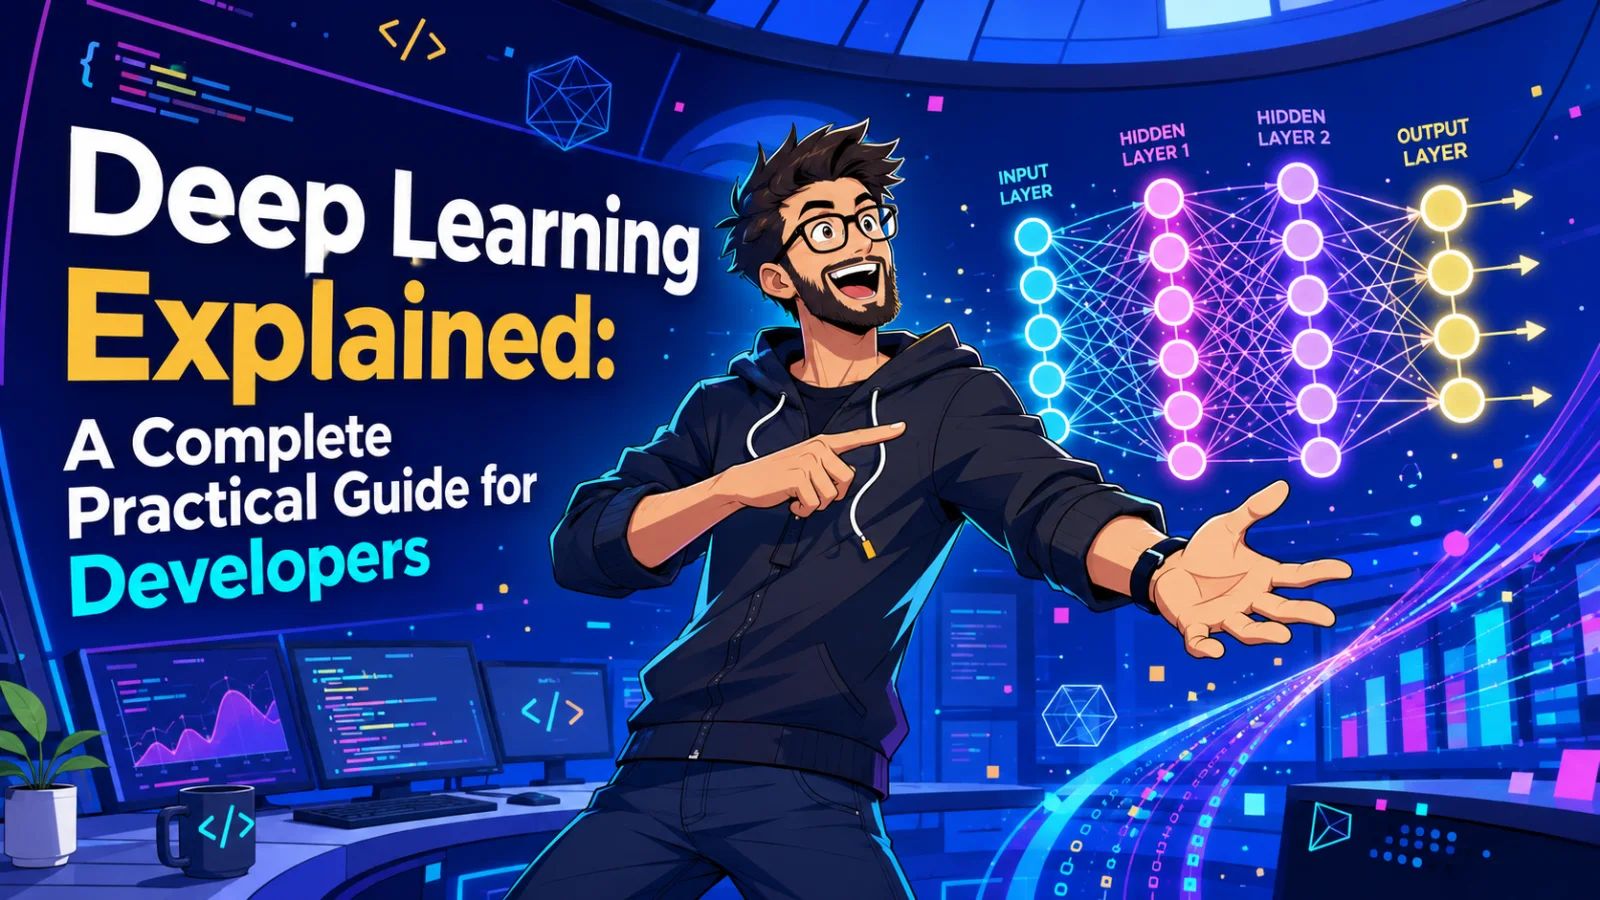
Una guía para desarrolladores que cubre desde neuronas y descenso del gradiente hasta CNN, transformers, evaluación, despliegue, monitorización y entrevistas.
Deep Learning explicado: Guía práctica y completa para desarrolladores
El deep learning es una rama del aprendizaje automático que utiliza redes neuronales con múltiples capas para aprender representaciones directamente de los datos. En lugar de diseñar manualmente cada característica, el modelo descubre patrones progresivamente abstractos: los bordes se convierten en formas, las formas en objetos, las palabras en significados contextuales y los eventos en predicciones.
Esta guía ofrece a los desarrolladores un modelo mental técnicamente correcto y conecta los fundamentos con el entrenamiento, la evaluación y la operación en producción.
1. Inteligencia artificial, machine learning y deep learning
La inteligencia artificial es el campo general de los sistemas que realizan tareas asociadas con la inteligencia humana. El machine learning aprende patrones a partir de ejemplos. El deep learning es una parte del machine learning basada principalmente en redes neuronales profundas. Los métodos tradicionales suelen necesitar características creadas a mano. Los modelos profundos pueden aprenderlas, pero normalmente exigen más datos, cómputo y control operativo.
2. La neurona artificial
Una neurona multiplica sus entradas por pesos aprendibles, suma un sesgo y aplica una función de activación:
z = w1x1 + w2x2 + ... + wnxn + b
salida = activación(z)
Los pesos controlan la influencia de cada entrada y el sesgo desplaza la frontera de decisión. La activación introduce no linealidad. Sin ella, muchas capas equivaldrían a una sola transformación lineal. ReLU es una opción eficaz para capas ocultas. Sigmoid suele representar una probabilidad binaria, Tanh produce valores entre -1 y 1 y Softmax genera una distribución entre varias clases.
3. Capas y propagación hacia delante
Una red contiene una capa de entrada, capas ocultas y una capa de salida. En el forward pass, los datos atraviesan todas las capas hasta producir una predicción. Las primeras capas aprenden patrones sencillos; las profundas los combinan en conceptos complejos. “Profundo” describe el número de transformaciones, no conciencia ni comprensión humana.
4. Funciones de pérdida
La pérdida cuantifica la diferencia entre predicción y objetivo. Mean Squared Error es habitual en regresión; Binary Cross-Entropy en clasificación binaria; Categorical Cross-Entropy en clasificación multiclase. La función y la salida deben corresponder a la tarea. De lo contrario, el modelo puede optimizar una cifra que no representa el objetivo real del producto.
5. Retropropagación y descenso del gradiente
La retropropagación aplica la regla de la cadena desde la salida hacia la entrada para calcular cuánto contribuyó cada parámetro al error. Calcula gradientes; el optimizador actualiza los pesos:
peso nuevo = peso anterior - tasa de aprendizaje × gradiente
Una tasa alta puede volver inestable el entrenamiento; una muy baja lo hace lento. SGD es el optimizador clásico. Adam adapta el paso para cada parámetro y es un buen punto de partida, aunque SGD puede generalizar mejor en algunas cargas.
6. Épocas, lotes y bucle de entrenamiento
Una época es un recorrido completo por el conjunto de entrenamiento. Un lote es el subconjunto procesado antes de actualizar parámetros. El ciclo estándar carga un lote, ejecuta el forward pass, calcula la pérdida, borra gradientes anteriores, ejecuta backpropagation, actualiza los pesos y evalúa con validación.
Los lotes pequeños consumen menos memoria y generan ruido que puede ayudar a generalizar. Los grandes aprovechan mejor el hardware, pero pueden exigir ajustes en la tasa de aprendizaje.
7. Preparación y división de datos
Elimine ejemplos corruptos, normalice etiquetas, gestione valores faltantes, estandarice variables numéricas y tokenice el texto de forma reproducible. Documente y versione cada transformación.
Los datos de entrenamiento actualizan parámetros. La validación guía la arquitectura y los hiperparámetros. El test permanece aislado hasta la estimación final. Evite data leakage: ninguna información de validación o test debe influir en las características ni en las estadísticas de preprocesamiento. Divida series temporales cronológicamente y mantenga todos los registros de un mismo cliente o paciente en una sola partición.
8. Sobreajuste y regularización
El overfitting aparece cuando el modelo memoriza detalles de entrenamiento y falla con datos nuevos. Una señal típica es que baja la pérdida de entrenamiento mientras sube la de validación.
Las medidas incluyen datos más representativos, data augmentation, penalizaciones L1/L2, Dropout, Early Stopping, modelos pequeños y validación cruzada. Batch Normalization puede estabilizar la optimización; Layer Normalization es frecuente en transformers. La regularización no corrige datos sesgados, duplicados o filtrados.
9. Arquitecturas principales
Las redes totalmente conectadas sirven para vectores de tamaño fijo y baselines. Las CNN utilizan filtros aprendidos y pesos compartidos para detectar patrones locales en imágenes, audio y algunas series temporales.
Las RNN procesan secuencias manteniendo un estado. LSTM y GRU reducen el problema del gradiente desvanecido. Los transformers usan Self-Attention para que cada token pondere información de otros tokens. Permiten entrenamiento paralelo y sustentan modelos modernos de lenguaje, visión y sistemas multimodales. La atención estándar es costosa porque crece de forma cuadrática con la longitud de la secuencia.
Los autoencoders comprimen y reconstruyen datos para representación, eliminación de ruido y anomalías. Las GAN enfrentan un generador con un discriminador. Los modelos de difusión aprenden a invertir un proceso de ruido y generan contenido de alta calidad.
10. Flujo mínimo con PyTorch
Un clasificador con diez variables puede usar Linear(10,64), ReLU, Dropout, Linear(64,32), ReLU y Linear(32,2). En cada paso se borran gradientes, se calculan logits, se evalúa CrossEntropyLoss, se llama a backward() y Adam actualiza parámetros. CrossEntropyLoss espera logits sin Softmax. PyTorch acumula gradientes por defecto, por eso deben limpiarse.
11. Evaluación más allá de Accuracy
Accuracy puede engañar con clases desequilibradas. Revise Precision, Recall, F1, matriz de confusión, ROC-AUC y PR-AUC. Para regresión son comunes MAE, RMSE y R-squared. La métrica debe reflejar el coste real de cada error. Evalúe también calibración, rendimiento por subgrupos, robustez, latencia, memoria y coste por predicción.
12. Transfer learning y fine-tuning
Un modelo preentrenado ya posee representaciones reutilizables. Transfer learning reemplaza o adapta la cabeza final; fine-tuning actualiza algunos o todos los parámetros con datos específicos. Empiece congelando la base, entrene la nueva cabeza y desbloquee capas gradualmente si es necesario. Una tasa menor evita destruir conocimiento útil.
13. Del notebook a producción
Versione dataset, código, configuración, pesos, tokenizer y resultados. Empaquete preprocesamiento e inferencia para que las transformaciones sean idénticas. Use una API síncrona para peticiones interactivas o colas y procesamiento batch para cargas pesadas.
Planifique tamaño del modelo, coste CPU/GPU, batching, caché, cuantización y autoscaling. Monitorice drift de entradas y predicciones, latencia, errores, recursos y métricas del resultado real. Mantenga rollback. El reentrenamiento debe pasar por una pipeline controlada con puertas de validación.
14. Seguridad, privacidad y uso responsable
Los datos pueden ser personales, licenciados, sesgados o maliciosos. Aplique minimización, controles de acceso, cifrado, retención y trazabilidad. Pruebe equidad en grupos relevantes. Proteja endpoints contra abuso, peticiones enormes, extracción del modelo y entradas adversarias.
Una predicción es estadística, no una verdad garantizada. Las decisiones de alto impacto necesitan supervisión humana, limitaciones transparentes, auditoría y un mecanismo seguro de apelación.
15. Errores frecuentes
Empezar con un modelo enorme sin baseline; optimizar Accuracy ignorando el coste de errores; consultar test repetidamente; permitir filtraciones por duplicados o datos futuros; usar distinto preprocesamiento en entrenamiento y producción; ignorar latencia y coste hasta el lanzamiento; desplegar sin monitorización, versiones o rollback; y tratar contenido generado como verdad sin verificar.
16. Plan práctico de proyecto
Defina una política de etiquetas y audite un dataset pequeño. Construya un baseline preentrenado. Cree las particiones antes de experimentar y aplique augmentation solo al entrenamiento. Registre experimentos bajo las mismas métricas. Exporte el modelo, cree un servicio con validación de entrada y haga pruebas de carga. Despliegue primero a poco tráfico y amplíe cuando calidad y operación sean estables.
17. Preguntas de entrevista
Los parámetros, como pesos y sesgos, se aprenden; los hiperparámetros, como tasa, batch y número de capas, se eligen. Las activaciones permiten relaciones no lineales. El vanishing gradient vuelve demasiado pequeños los gradientes de las primeras capas. Validación guía decisiones y test mide la generalización final. Dropout desactiva activaciones aleatoriamente. Data leakage usa información que no existiría durante la predicción. El entrenamiento modifica parámetros; la inferencia usa parámetros fijos.
Un modelo listo para producción no solo obtiene buena puntuación offline: debe cumplir calidad, equidad, robustez, latencia, fiabilidad, coste, seguridad, observabilidad y rollback.
Conclusión
El deep learning no es magia. Es ingeniería basada en datos, modelos diferenciables, optimización, evaluación disciplinada y sistemas de producción fiables. Domine primero forward pass, pérdida, backpropagation y partición de datos. La mejor solución no es el modelo más grande, sino el sistema más sencillo que aporta valor medible de forma segura y fiable.
Artículos destacados
8 plugins de Claude Code que facilitan el desarrollo en 2026
Un asistente de programación funciona mejor cuando tiene el contexto adecuado. Un plugin puede consultar documentación actual, seguir símbolos del código o probar una página en el navegador. No hace falta instalarlo todo: empieza por las herramientas que resuelven problemas habituales en tu proyecto. ## Cómo empezar Escribe `/plugin` en Claude Code y abre **Discover**. También puedes usar `/plugin install NAME@claude-plugins-official`. Si no aparece el catálogo, añade `/plugin marketplace add anthropics/claude-plugins-official`. Lee los requisitos de cada plugin: algunos necesitan configuración adicional. ## 1. Context7: documentación relevante para tu versión Context7 consulta documentación y ejemplos específicos de una versión mediante un servicio MCP. Es útil al actualizar dependencias: «Comprueba la documentación actual de Laravel antes de proponer este cambio». Confirma la versión instalada y verifica los ejemplos decisivos en la fuente. `/plugin install context7@claude-plugins-official` ## 2. PHP LSP: orientarte en Laravel El servidor de lenguaje para PHP aporta navegación entre definiciones y referencias, además de diagnósticos. Pide seguir una llamada desde el controlador hasta el servicio, el trabajo en cola y el modelo. Sigue las instrucciones para configurar Intelephense. `/plugin install php-lsp@claude-plugins-official` ## 3. TypeScript LSP: comprender el frontend En React, Next.js o Vue con TypeScript, localizar los usos de un tipo o una propiedad compartida evita cambios a ciegas. Después, ejecuta la comprobación de tipos y las pruebas de tu proyecto. `/plugin install typescript-lsp@claude-plugins-official` ## 4. Code Review: revisar antes del pull request Al terminar una función, solicita una revisión del diff con errores concretos, casos límite y pruebas que falten. En un endpoint de envío de respuestas, revisa duplicados, permisos y concurrencia. Comprueba personalmente cada hallazgo. `/plugin install code-review@claude-plugins-official` ## 5. Security Guidance: señales durante la edición Este plugin avisa sobre patrones de riesgo y examina cambios desde una perspectiva de seguridad. Úsalo al modificar autenticación, subidas de archivos o autorización de API. Es una ayuda, no una garantía ni un sustituto de auditorías y revisión humana. `/plugin install security-guidance@claude-plugins-official` ## 6. Playwright: comprobar la experiencia real Una compilación correcta no asegura que el menú móvil o un formulario funcionen. Con Playwright puedes pedir que se pruebe el inicio de sesión, las validaciones o el selector de idioma en el navegador. Para operaciones que escriben datos, utiliza un entorno y una cuenta de pruebas. `/plugin install playwright@claude-plugins-official` ## 7. Frontend Design: mejorar una interfaz Describe a quién va dirigida la página, sus componentes existentes, los requisitos de accesibilidad y la acción principal. Revisa el resultado en móvil y escritorio, y ajusta lo que no encaje con tu sistema de diseño. `/plugin install frontend-design@claude-plugins-official` ## 8. CLAUDE.md Management: conservar instrucciones útiles Un `CLAUDE.md` breve puede indicar dónde están las pruebas, cómo ejecutarlas y qué reglas arquitectónicas seguir. El plugin ayuda a revisar y mejorar ese archivo. Conserva instrucciones concretas y elimina las obsoletas. `/plugin install claude-md-management@claude-plugins-official` ## Una selección inicial sencilla Para Laravel, prueba **PHP LSP** y **Context7**. Para Next.js, empieza con **TypeScript LSP** y **Playwright**. Añade **Code Review** y **Security Guidance** para cambios delicados. El mejor conjunto es el que de verdad usas, acompañado de tus pruebas y criterio técnico. ## Fuentes oficiales [Claude Code plugins](https://code.claude.com/docs/en/plugins) · [Anthropic marketplace](https://github.com/anthropics/claude-plugins-official).
Detección de objetos con YOLO: Guía práctica completa para desarrolladores
Guía integral para desarrollar con YOLO: conceptos, datos, entrenamiento, evaluación, tiempo real, API de producción, rendimiento, seguridad y entrevistas.
50 Claude Skills que vale la pena crear en 2026
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.