Apache Kafka explicado: temas, particiones, grupos de consumidores y tu primer flujo de eventos
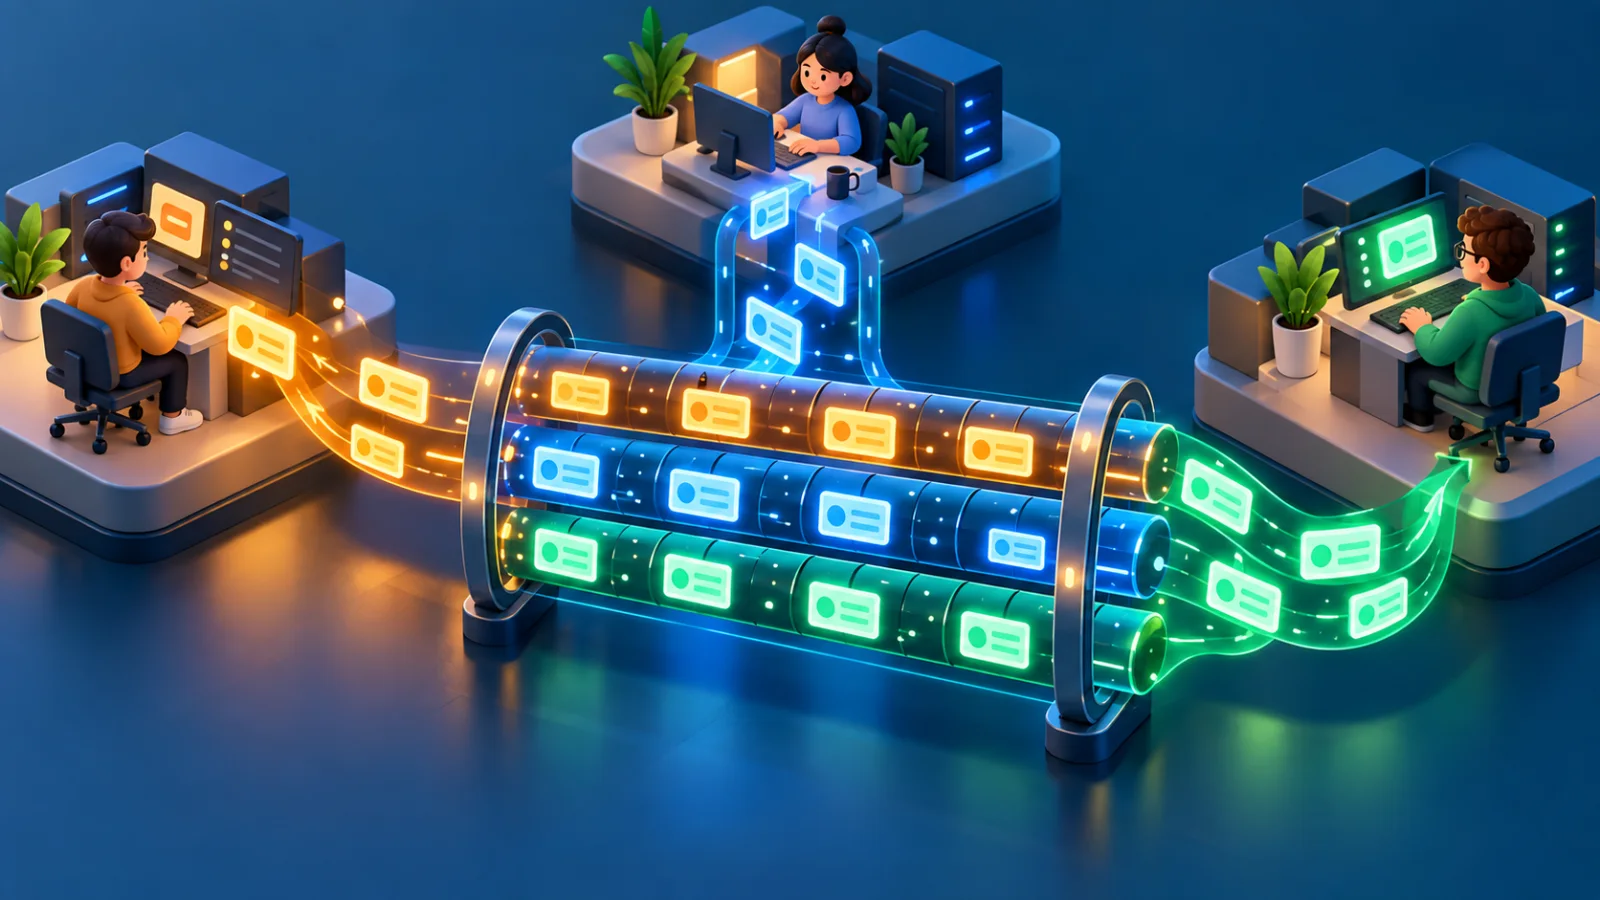
Sigue un evento de pedido desde el productor hasta varios consumidores y prueba en local cómo funcionan las particiones, el orden y la reproducción.
Kafka puede mover trabajo a segundo plano, pero su mejor modelo mental es un registro distribuido de eventos que varias aplicaciones leen de forma independiente. El servicio de pedidos registra una compra. Inventario, analítica y notificaciones reaccionan a su ritmo sin que la petición del cliente espere a las tres.
Esta flexibilidad exige decidir cómo repartir y ordenar eventos, cuánto tiempo conservarlos y qué hacer cuando falla un consumidor. Sigamos un evento a través de Kafka y probémoslo en local.
Los conceptos esenciales
Un productor escribe registros en un tema o topic. Cada tema tiene una o más particiones, registros ordenados a los que se añaden datos. Un broker almacena particiones y atiende a los clientes. Un consumidor lee; los miembros de un mismo grupo de consumidores se reparten las particiones.
Un registro contiene valor, clave opcional, cabeceras y marca temporal. Kafka le asigna un offset dentro de su partición. (tema, partición, offset) identifica su posición. El offset 42 de una partición no establece un orden global respecto al 42 de otra.
En orders.placed.v1 con cuatro particiones, usa orderId como clave si necesitas orden para cada pedido. Los eventos con la misma clave llegan a la misma partición bajo una política estable. Kafka garantiza el orden dentro de una partición, no en todo el tema. Si cambias el número de particiones, la ubicación de eventos futuros para una clave puede variar.
Define el contrato del evento
{
  "eventId": "evt_01JQ8X8F",
  "eventType": "OrderPlaced",
  "schemaVersion": 1,
  "occurredAt": "2026-09-29T10:30:00Z",
  "orderId": "ord_782",
  "customerId": "cus_17",
  "totalMinor": 12900,
  "currency": "USD"
}
eventId permite detectar procesamientos duplicados. La clave Kafka es orderId. totalMinor expresa dinero en la unidad mínima de la moneda. Publica solo datos necesarios: el evento puede conservarse y reproducirse. OrderPlaced describe un hecho ocurrido; ReserveInventory sería una orden con otro propietario y otro contrato de fallo.
Qué ocurre al publicar y consumir
El productor obtiene metadatos del clúster, elige partición y envía el registro al broker líder. Las réplicas pueden mantener copias en otros brokers. La configuración de confirmación determina cuándo el envío se considera exitoso. Los consumidores leen las particiones asignadas.
Cada grupo guarda su avance mediante offsets confirmados. Confirmar un offset no borra el evento. inventory-reservation y sales-analytics son grupos diferentes: ambos leen OrderPlaced y avanzan independientemente. Un grupo puede volver a una posición antigua mientras los registros sigan retenidos.
Con cuatro particiones y tres instancias en el grupo de inventario, se reparten las particiones. Una quinta instancia no ganará una partición activa adicional de ese tema. Cuando entra o sale un miembro, el grupo puede reequilibrarse. Tu aplicación debe tolerar la reasignación y los trabajos incompletos.
Pruébalo en local
La guía rápida oficial ofrece la imagen Docker de Apache:
docker run -d --name kafka-demo -p 9092:9092 apache/kafka:4.3.1
Ejecuta estos comandos donde estén los binarios de Kafka en bin/ y el broker sea accesible en localhost:9092:
bin/kafka-topics.sh --create --topic quickstart-events \
  --bootstrap-server localhost:9092
bin/kafka-topics.sh --describe --topic quickstart-events \
  --bootstrap-server localhost:9092
bin/kafka-console-producer.sh --topic quickstart-events \
  --bootstrap-server localhost:9092
Escribe varias líneas en el productor. En otra terminal:
bin/kafka-console-consumer.sh --topic quickstart-events \
  --from-beginning --bootstrap-server localhost:9092
Si ejecutas la CLI dentro del contenedor, usa sus binarios y la dirección local adecuada allí. Un solo broker sirve para aprender, no para demostrar tolerancia a fallos. Repite con dos consumidores del mismo grupo y otro de un grupo diferente. Crea un tema con varias particiones para observar paralelismo real; una partición solo puede asignarse a un consumidor activo por grupo para ese tema.
La clave es una decisión de negocio
orderId conserva el orden de cada pedido. customerId conserva el orden de un cliente, pero uno muy activo puede sobrecargar una partición. Una clave constante concentra todo el tráfico; una aleatoria reparte trabajo pero rompe el orden de eventos relacionados. Escribe primero qué entidad necesita orden.
La cantidad de particiones limita la paralelización activa de un grupo, aunque también aumenta metadatos, archivos y trabajo de replicación. Decide con mediciones y crecimiento esperado. Añadir particiones después requiere revisar la distribución de claves y los requisitos de orden.
Retención, reproducción y compactación
Kafka no borra registros cuando alguien los lee. La retención por tiempo o tamaño determina cuándo desaparecen. Un grupo parado más tiempo que la ventana de retención podría perder la posibilidad de reanudar desde su offset anterior. Vigila ese margen.
La compactación del registro conserva con el tiempo un valor reciente por clave para temas de estado, no un historial íntegro de auditoría. Una tumba o tombstone con clave y valor nulo indica eliminación. Diferencia un historial de eventos de un changelog del estado actual.
Reproducir eventos ayuda a reconstruir una proyección, pero también puede volver a enviar correos o repetir cargos. Usa eventId y operaciones idempotentes. Si solo necesitas enviar un correo en segundo plano, una cola de trabajos normal puede ser suficiente; Kafka se justifica cuando necesitas suscriptores independientes y reproducción.
Un proyecto para comprobar lo aprendido
Crea orders.placed.v1 en un entorno desechable, publica eventos con clave orderId y ejecuta grupos de inventario y analítica. Detén y reinicia un consumidor. Explica en el README por qué elegiste esa clave, dónde continúa cada grupo, qué ocurre al superar la retención y cómo se maneja un evento duplicado.
Fuentes oficiales
Artículos destacados
Kafka en producción: particiones, lag, fiabilidad y respuesta a incidentes
Una guía práctica para tomar decisiones de orden, capacidad y recuperación en Kafka, interpretar el lag y responder a fallos sin perder de vista el resultado de negocio.
Laravel y Kafka sin eventos perdidos: outbox transaccional y consumidores idempotentes con PostgreSQL
Una confirmación en PostgreSQL y una publicación en Kafka no forman una transacción ordinaria. Aprende a evitar pérdidas y duplicación de efectos.
Cómo diseñar APIs en las que los clientes puedan confiar: guía práctica desde el contrato
Una buena API hace predecible la próxima acción del cliente. Diseña una inscripción a un curso con reintentos seguros, errores útiles y un plan de evolución.
Comentarios
0 comentariosTodavía no hay comentarios aprobados. Las respuestas nuevas pueden esperar moderación.