Ücretsiz kitap
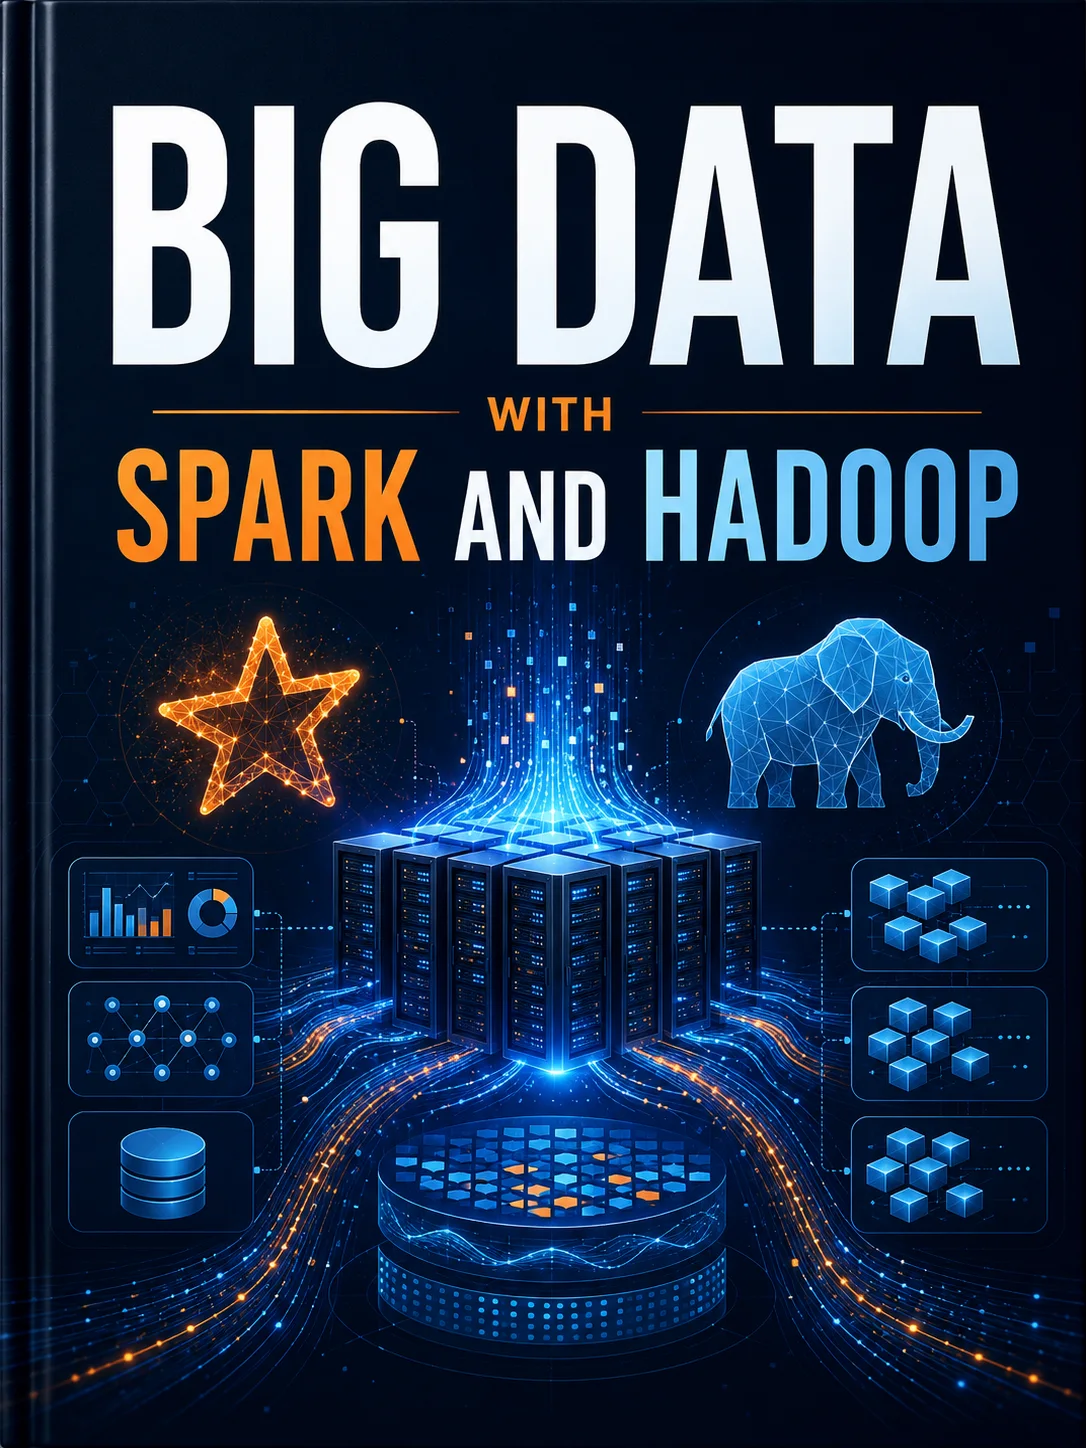
Spark ve Hadoop ile Büyük Veri
Okuma erişimi
Ücretsiz kitap
Bu kitap, büyük veri sistemlerini başlangıç seviyesinden pratik platform tasarımına kadar basit bir dille öğretiyor. Hadoop, Spark, dağıtılmış işleme, veri gölleri, ayarlama, izleme ve gerçek dünya veri hattı modellerini kapsar.
Seviye: intermediateDil: TR TürkçePuan: 0İncelemeler: 0
Kitap
Book contents
01Chapter 1: Introduction to Big Data Systems02Chapter 2: Batch Processing and Distributed Storage03Chapter 3: Hadoop Foundations and HDFS04Chapter 4: MapReduce and Cluster Thinking05Chapter 5: Spark Fundamentals and Execution Model06Chapter 6: PySpark for Practical Data Processing07Chapter 7: Data Lakes, File Formats, and Partitioning08Chapter 8: Resource Management and Scheduling09Chapter 9: ETL Pipelines at Scale10Chapter 10: Performance Tuning for Spark Jobs11Chapter 11: Monitoring and Debugging Big Data Workloads12Chapter 12: Security and Governance in Data Platforms13Chapter 13: Streaming and Near-Real-Time Extensions14Chapter 14: Cost Optimization in Data Processing15Chapter 15: Capstone: Build a Spark Data Pipeline16Chapter 16: Capstone: Operate a Hadoop and Spark Stack17Appendix A: Commands and Workflow Cheat Sheet18Appendix B: Reference Architectures and Patterns19Appendix C: Common Mistakes and Fixes20Appendix D: Best Practices Summary
İncelemeler
Henüz onaylı inceleme yok.
Öne Çıkan Kitaplar
Tartışma
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.