Vektör Veritabanları: Semantik Arama ve Yapay Zekanın Arkasındaki Motor
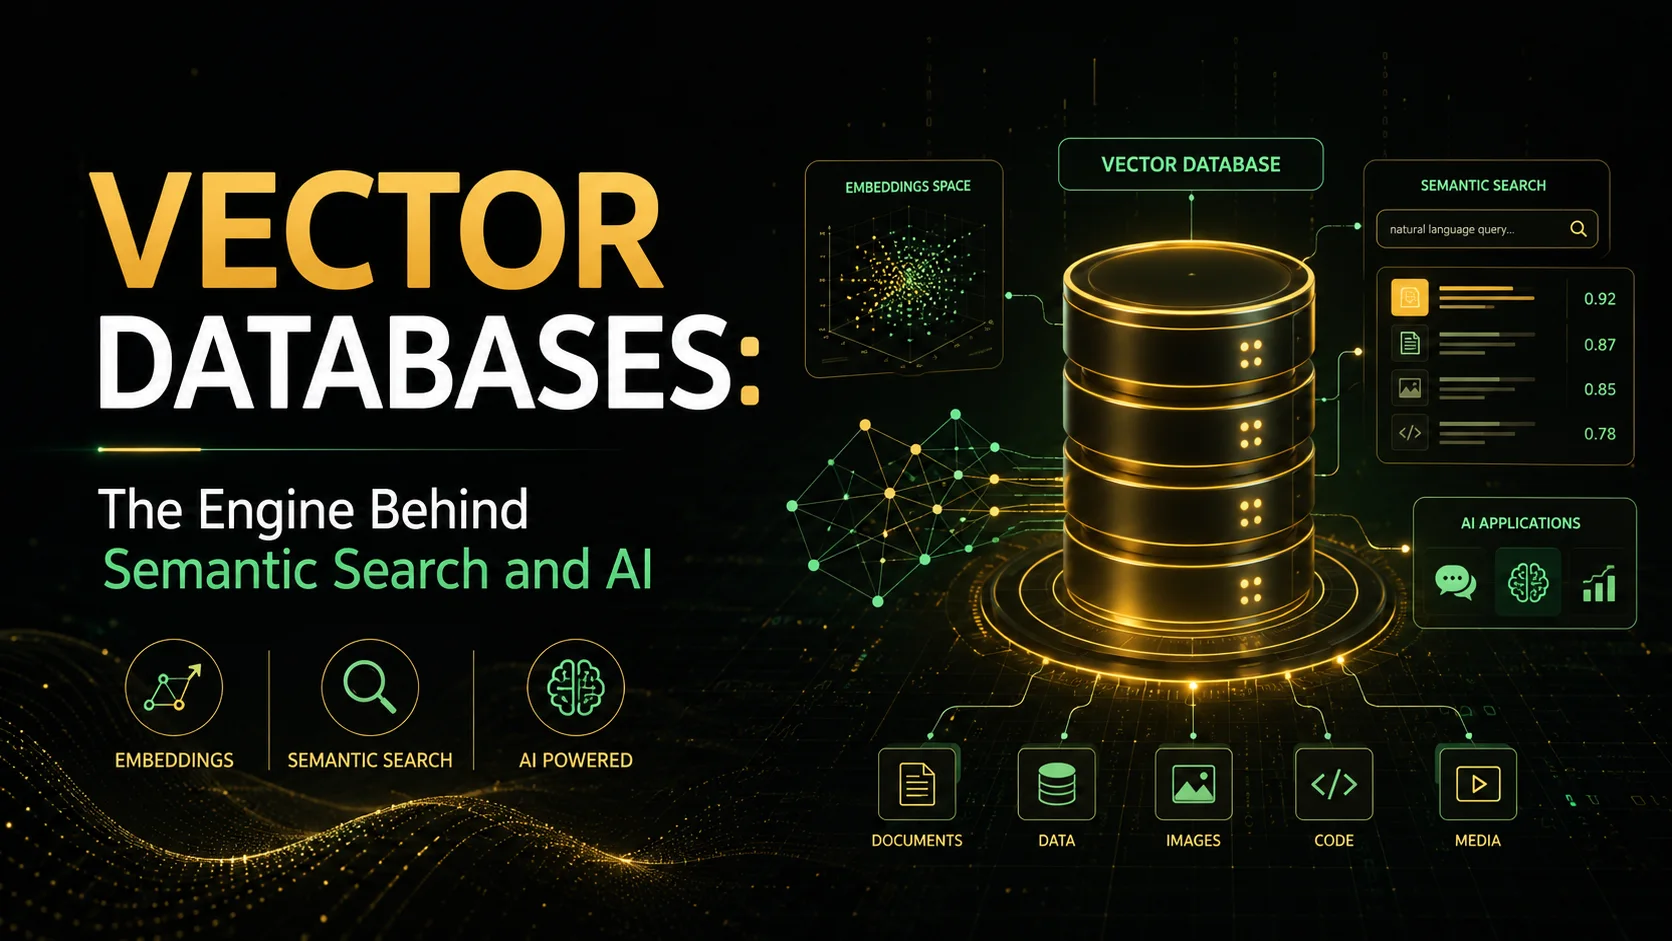
Vektör veritabanı, yüksek boyutlu vektör yerleştirmelerini depolamak, indekslemek ve sorgulamak için tasarlanmış özel bir veritabanıdır. Tam anahtar kelime eşleşmelerine veya yapılandırılmış sorgulara göre arama yapan geleneksel veritabanlarının aksine, vektör veritabanları anlamsal benzerliğe göre arama yapar; farklı kelimeler kullansa bile kavramsal olarak ilişkili verileri bulur.
Giriş
Vektör veritabanı, yüksek boyutlu vektör yerleştirmelerini depolamak, indekslemek ve sorgulamak için tasarlanmış özel bir veritabanıdır. Tam anahtar kelime eşleşmelerine veya yapılandırılmış sorgulara göre arama yapan geleneksel veritabanlarının aksine, vektör veritabanları anlamsal benzerliğe göre arama yapar; farklı kelimeler kullansa bile kavramsal olarak ilişkili verileri bulur.
Vektör veritabanları yapay zeka uygulamaları için temel altyapı haline geldi: erişimle artırılmış nesil (RAG), anlamsal arama, öneri sistemleri, anormallik tespiti ve çok modlu yapay zeka (metin, resim, ses) desteği.
Vektör Gömmeleri Nedir?
Kelimelerden Sayılara
Yerleştirmeler, makine öğrenimi modelleri tarafından üretilen verilerin (metin, resim, ses veya başka herhangi bir yöntem) sayısal temsilleridir. İşin sihri, benzer öğelerin vektör uzayında birbirine yakınlaşmasıdır:
"king" ──► [0.23, -0.45, 0.78, ..., 0.12]  (768 dimensions)
"queen" ──► [0.25, -0.42, 0.76, ..., 0.15]  (close to king)
"apple" ──► [-0.12, 0.65, 0.33, ..., -0.28]  (far from king)
Gömmeler Anlamı Nasıl Yakalar?
                   ┌───────┐
                   │  man  │
                   └───┬───┘
                       │
       ┌───────────────┼───────────────┐
       │               │               │
   ┌───▼───┐       ┌───▼───┐       ┌───▼───┐
   │  king  │───────│ woman │───────│ queen │
   └───┬───┘       └───┬───┘       └───┬───┘
       │               │               │
       └───────────────┼───────────────┘
                       │
                   ┌───▼───┐
                   │  girl  │
                   └───────┘

Vector arithmetic: king - man + woman = queen
Popüler Gömme Modelleri
| Modeli | Boyutlar | En İyisi | sağlayıcı |
|---|---|---|---|
| metin yerleştirme-3-küçük | 512-1536 | Genel amaçlı, uygun maliyetli | OpenAI |
| metin gömme-3-büyük | 256-3072 | Yüksek doğruluk, anlamsal arama | OpenAI |
| Tutarlı Yerleştirme v3 | 1024 | Çok dilli, sınıflandırma | tutarlı |
| BAAI/bge-large-en-v1.5 | 1024 | Açık kaynak, yüksek kalite | Sarılma Yüz |
| cümle-transformatörler/tümü-MiniLM-L6-v2 | 384 | Hafif, hızlı | Sarılma Yüz |
| resim bağlama | 1024 | Çok modlu (metin, resim, ses) | meta |
Vektör Veritabanları Nasıl Çalışır?
Temel Operasyonlar
- Dizin oluşturma — Vektörler üzerinde verimli bir veri yapısı (ANN dizini) oluşturun.
- Besleme — Dizine meta veri içeren vektörler ekleyin.
- Sorgulama — Bir sorgu vektörü verildiğinde, en yakın K komşuyu (KNN) bulun.
- Filtreleme — Vektör benzerliğini meta veri filtreleriyle birleştirin (karma arama).
Arama Sorunu
Kaba kuvvetle en yakın komşu araması O(N)'dir; milyonlarca vektör için çok yavaştır:
# Brute force — O(N), not scalable
def brute_force_search(query_vector, all_vectors, k=10):
    distances = []
    for i, vec in enumerate(all_vectors):
        dist = cosine_distance(query_vector, vec)
        distances.append((dist, i))
    return sorted(distances)[:k]
Yaklaşık En Yakın Komşu (YSA) Dizinleri
Vektör veritabanları, alt doğrusal arama süresini elde etmek için YSA algoritmalarını kullanır:
| Algoritma | Hız | Geri çağırma | Bellek | Oluşturma Süresi |
|---|---|---|---|---|
| HNSW (Hiyerarşik Gezinilebilir Küçük Dünya) | ⚡ Hızlı | %95-99 | Yüksek | Yavaş |
| IVF (Tersine Çevrilmiş Dosya Dizini) | 🐢 Yavaş | %90-95 | Orta | Hızlı |
| IVF + PQ (Ürün Niceleme) | ⚡ Hızlı | %85-95 | Düşük | Orta |
| DiskANN | ⚡ Hızlı | %90-95 | Düşük (disk) | Orta |
| LSH (Yerelliğe Duyarlı Karma) | 🐢 Yavaş | %80-90 | Yüksek | Hızlı |
HNSW — En Popüler Algoritma
HNSW çok katmanlı bir grafik yapısı oluşturur:
Layer 3:  ────────●────────  (sparse, long-range connections)
                   │
Layer 2:  ────●────────●───  (medium density)
               │       │
Layer 1:  ──●──●──●──●──●──  (dense, short-range connections)

Search starts at top layer (coarse) and descends to bottom layer (fine).
Vektör Veritabanı Karşılaştırması
| Özellik | Çam kozalağı | Dokuma | Qdrant | Milvus | Renk | pgvektör |
|---|---|---|---|---|---|---|
| Mimarlık | Yönetilen SaaS | Hibrit | Bağımsız | Dağıtılmış | Gömülü | PostgreSQL uzantısı |
| İstikrar | Bulut | Bulut/Şirket içi | Bulut/Şirket içi | Bulut/Şirket içi | Yerel dosya | PostgreSQL |
| dizin | HNSW | HNSW | HNSW | IVF/HNSW | HNSW | IVFFlat/HNSW |
| Karma arama | Evet | Evet | Evet | Evet | Sınırlı | Evet (SQL aracılığıyla) |
| Çoklu kiracılık | Evet | Evet | Evet | Evet | Manuel | Şemalar aracılığıyla |
| Filtreleme | Ön filtre | Ön/son filtre | Ön filtre | Filtre sonrası | Sınırlı | Filtre + dizin |
| Meta veriler | JSON | JSON | JSON | JSON | JSON | JSONB |
| Açık kaynak | Hayır | Evet (BSL) | Evet (Apache 2.0) | Evet (Apache 2.0) | Evet (Apache 2.0) | Evet (PostgreSQL) |
| Kendi kendine barındırıcı | Hayır | Evet | Evet | Evet | Evet | Evet |
Kullanım Durumları
1. Alma-Artırılmış Üretim (RAG)
En popüler vektör veritabanı kullanım örneği — LLM'leri özel verilerle genişletmek:
User Query: "What is our company policy on remote work?"

                ┌─────────────────────────┐
                │   Embedding Model       │
                │  text-embedding-3-small │
                └────────────┬────────────┘
                             │ (query vector)
                             ▼
                ┌─────────────────────────┐
                │   Vector Database       │
                │  (company policies)     │
                └────────────┬────────────┘
                             │ (relevant chunks)
                             ▼
                ┌─────────────────────────┐
                │   LLM (GPT-4 / Claude)  │
                │  "Based on our policy   │
                │   document X, remote    │
                │   work is allowed 3     │
                │   days per week..."    │
                └─────────────────────────┘
Python uygulaması:
import openai
from qdrant_client import QdrantClient

client = QdrantClient("localhost", port=6333)

def rag_query(question: str) -> str:
    # 1. Embed the question
    query_vector = openai.embeddings.create(
        input=question, model="text-embedding-3-small"
    ).data[0].embedding

    # 2. Search vector database
    results = client.query_points(
        collection_name="company_policies",
        query=query_vector,
        limit=5
    )

    # 3. Build context from retrieved chunks
    context = "\n\n".join([r.payload["text"] for r in results.points])

    # 4. Generate answer with context
    response = openai.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "Answer based on the provided context only."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {question}"}
        ]
    )
    return response.choices[0].message.content
2. Anlamsal Arama
Anahtar kelimelere göre değil, anlama göre arama yapın:
# Traditional keyword search — misses synonyms
SELECT * FROM products WHERE description LIKE '%cheap laptop%'
# May miss: "affordable notebook" or "budget computer"

# Vector semantic search — finds conceptually related items
results = vector_db.search(
    query="budget-friendly portable computer",
    collection="products",
    limit=10
)
# Finds: "cheap laptop", "affordable notebook", "budget desktop", "entry-level PC"
Performans karşılaştırması:
| Arama Türü | Geri çağırma | Kullanıcı Memnuniyeti | Uygulama Karmaşıklığı |
|---|---|---|---|
| Anahtar Kelime (BM25) | %40-60 | Düşük | Düşük |
| Anlamsal (Vektör) | %70-90 | Yüksek | Orta |
| Hibrit (BM25 + Vektör) | %85-95 | Çok Yüksek | Yüksek |
3. Çok Modlu Arama
Farklı veri türlerinde arama yapın:
# Text-to-image search
text_vector = embed_text("sunset over mountains")
image_results = vector_db.search(text_vector, collection="images")

# Image-to-text search
image_vector = embed_image(uploaded_photo)
text_results = vector_db.search(image_vector, collection="descriptions")

# Image-to-image search (visual similarity)
product_image_vector = embed_image(product_photo)
similar_products = vector_db.search(product_image_vector, collection="products")
4. Öneri Sistemleri
def recommend_items(user_id: str, n: int = 10):
    # Get user's embedding (from past behavior)
    user_vector = get_user_embedding(user_id)

    # Find similar items in vector space
    recs = vector_db.search(
        query=user_vector,
        collection="items",
        limit=n,
        with_payload=True
    )

    # Diversity re-ranking
    return diversify(recs, diversity_factor=0.3)
Vektör Veritabanı İşlemleri
Koleksiyon Oluşturma ve Vektör Ekleme
Qdrant örneği:
from qdrant_client import QdrantClient
from qdrant_client.models import VectorParams, Distance

client = QdrantClient("localhost", port=6333)

# Create collection with specific vector config
client.create_collection(
    collection_name="documents",
    vectors_config=VectorParams(
        size=1536,  # Matches text-embedding-3-small
        distance=Distance.COSINE  # or DOT, EUCLIDEAN
    ),
)

# Insert vectors with payload (metadata)
client.upsert(
    collection_name="documents",
    points=[
        {
            "id": "doc_001",
            "vector": [0.12, -0.45, ..., 0.78],  # 1536-dimensional
            "payload": {
                "title": "Remote Work Policy",
                "category": "HR",
                "author": "HR Team",
                "date": "2026-01-15",
                "chunk_index": 0,
                "text": "Employees may work remotely up to 3 days per week..."
            }
        },
        # ... more points
    ]
)
Filtrelerle Karma Arama
# Semantic search with metadata filters
results = client.query_points(
    collection_name="documents",
    query=query_vector,
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="category",
                match=models.MatchValue(value="Engineering")
            ),
            models.FieldCondition(
                key="date",
                range=models.Range(gte="2025-01-01")
            ),
        ],
        should=[
            models.FieldCondition(
                key="author",
                match=models.MatchValue(value="Alice")
            ),
        ]
    ),
    limit=20,
    score_threshold=0.75  # Minimum similarity score
)
Vektör Veritabanı ve Geleneksel Veritabanı Karşılaştırması
| Operasyon | PostgreSQL | pgvektör | Özel Vektör DB |
|---|---|---|---|
| Tam KNN | ❌ (tam tarama) | ❌ (yavaş) | ✅ (kaba kuvvet yoluyla) |
| YSA arama | ❌ | ✅ (IVFFlat, HNSW) | ✅ (optimize edilmiş) |
| 10 milyondan fazla vektör | ✅ | ⚠️ Performans düşer | ✅ |
| Gerçek zamanlı akış | ✅ | ⚠️ | ✅ |
| Hibrit arama | ✅ (SQL filtreleri) | ✅ | ✅ |
| Çok kiracılı | ✅ (şemalar) | ✅ | ✅ (yerli) |
| ASİT işlemleri | ✅ | ✅ | ⚠️ (sınırlı) |
| Zaman yolculuğu sorguları | ❌ | ❌ | ✅(WAL) |
Zorluklar ve Dikkat Edilmesi Gerekenler
Boyutsallık Laneti
- Daha yüksek boyutlar mesafe metriklerini daha az anlamlı hale getirir.
- Çoğu yerleştirme modeli 384-1536 boyutları kullanır; bu yönetilebilir bir durumdur.
- 2000 boyutun ötesinde boyut azaltmayı (PCA, UMAP) göz önünde bulundurun.
Dizin Bakımı
- HNSW önemli miktarda bellek gerektirir (vektörler + grafik yapısı).
- Veriler arttıkça IVF'nin periyodik olarak yeniden eğitime ihtiyacı vardır.
- DiskANN, daha düşük bellek karşılığında bir miktar hızdan vazgeçer.
Maliyet
vector_database_pricing:
  pinecone:
    starter: "$70/month for 100K vectors"
    enterprise: "$2,000+/month for 10M+ vectors"
  self_hosted_qdrant:
    infrastructure: "$50-500/month (cloud VMs)"
    maintenance: "Operational overhead"
Veri Güncelliği
- Gerçek zamanlı besleme, dizin optimizasyonuyla çakışıyor.
- Yeni vektörler için toplu indeksleme, güncellemeler için artımlı.
- Tazelik ve arama kalitesi arasındaki denge.
Sonuç
Vektör veritabanları yapay zeka uygulamaları için kritik bir altyapı bileşenidir:
- Bunları anahtar kelime eşlemeye değil, anlamsal anlayışa ihtiyaç duyduğunuzda kullanın.
- Önemli uygulama RAG — Yüksek Lisans'ları özel, güncel verilerle zenginleştiriyor.
- Ölçeğe göre seçim yapın — küçük projeler için pgvector, üretim için Pinecone/Qdrant, büyük ölçekli projeler için Milvus.
- Karma arama (vektör + anahtar kelime + meta veriler) en iyi sonuçları sağlar.
- Yerleştirme modeli seçimi önemlidir — özel kullanım durumunuz için farklı modelleri test edin.
Vektör veritabanı ortamı hızla gelişiyor. Basit bir başlangıç yapın (pgvector veya açık kaynak Qdrant), verilerinizle kıyaslama yapın ve gerektiğinde ölçeklendirin.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
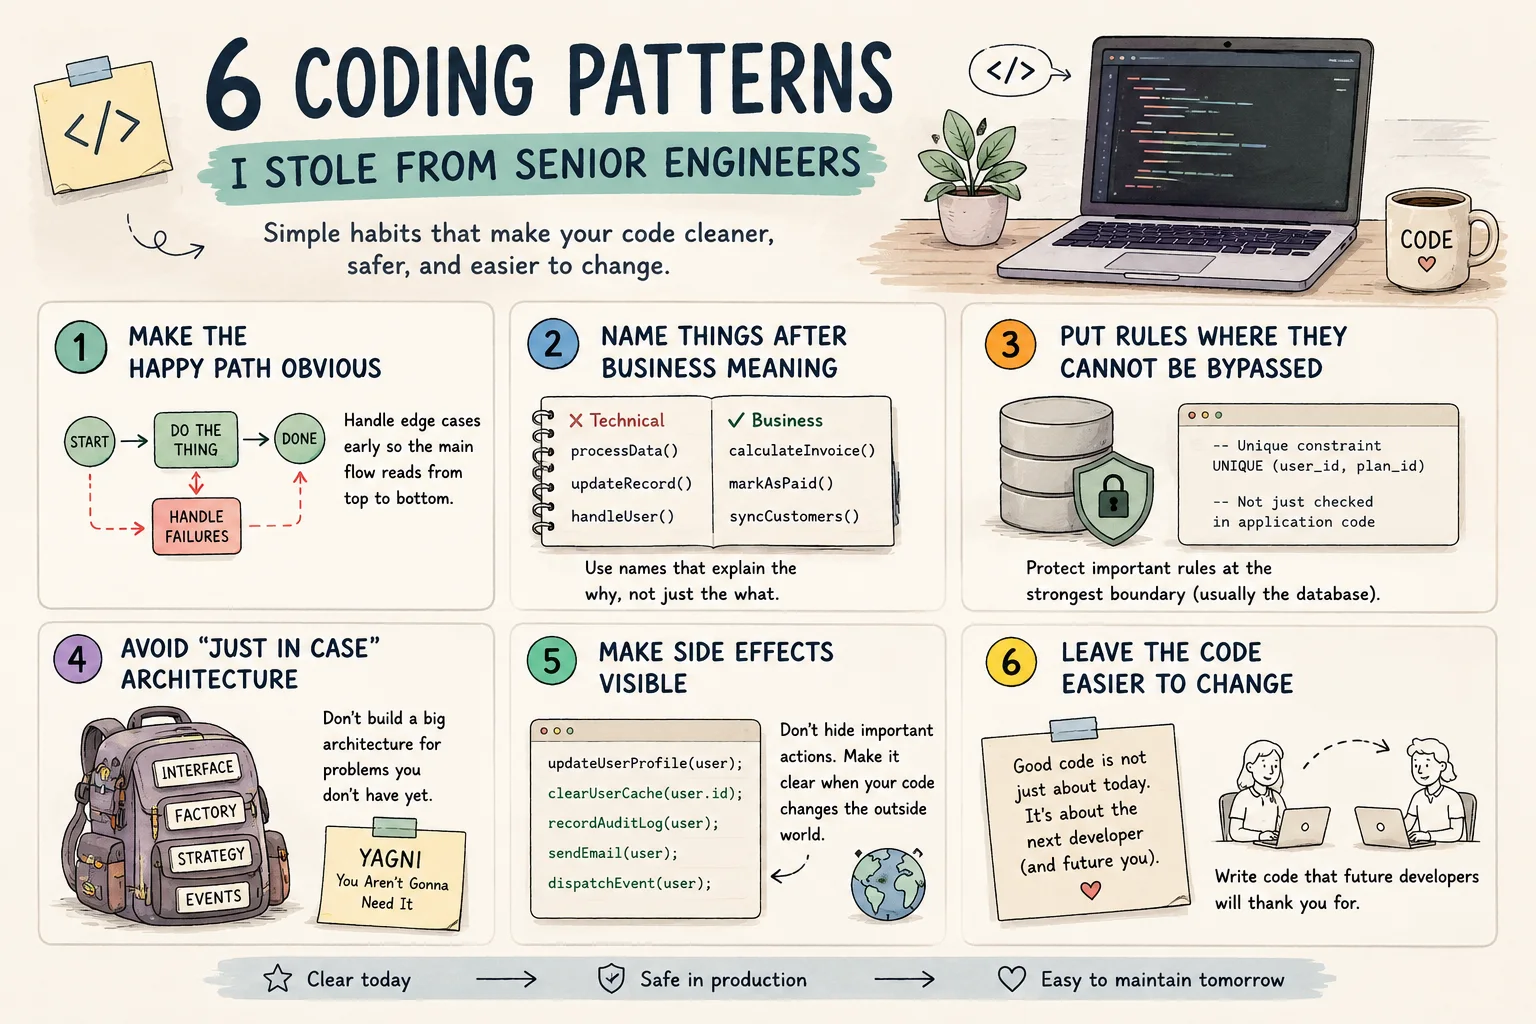
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.