Zaman Serisi Veritabanları: Zaman İçinde Değişen Verileri Yönetme
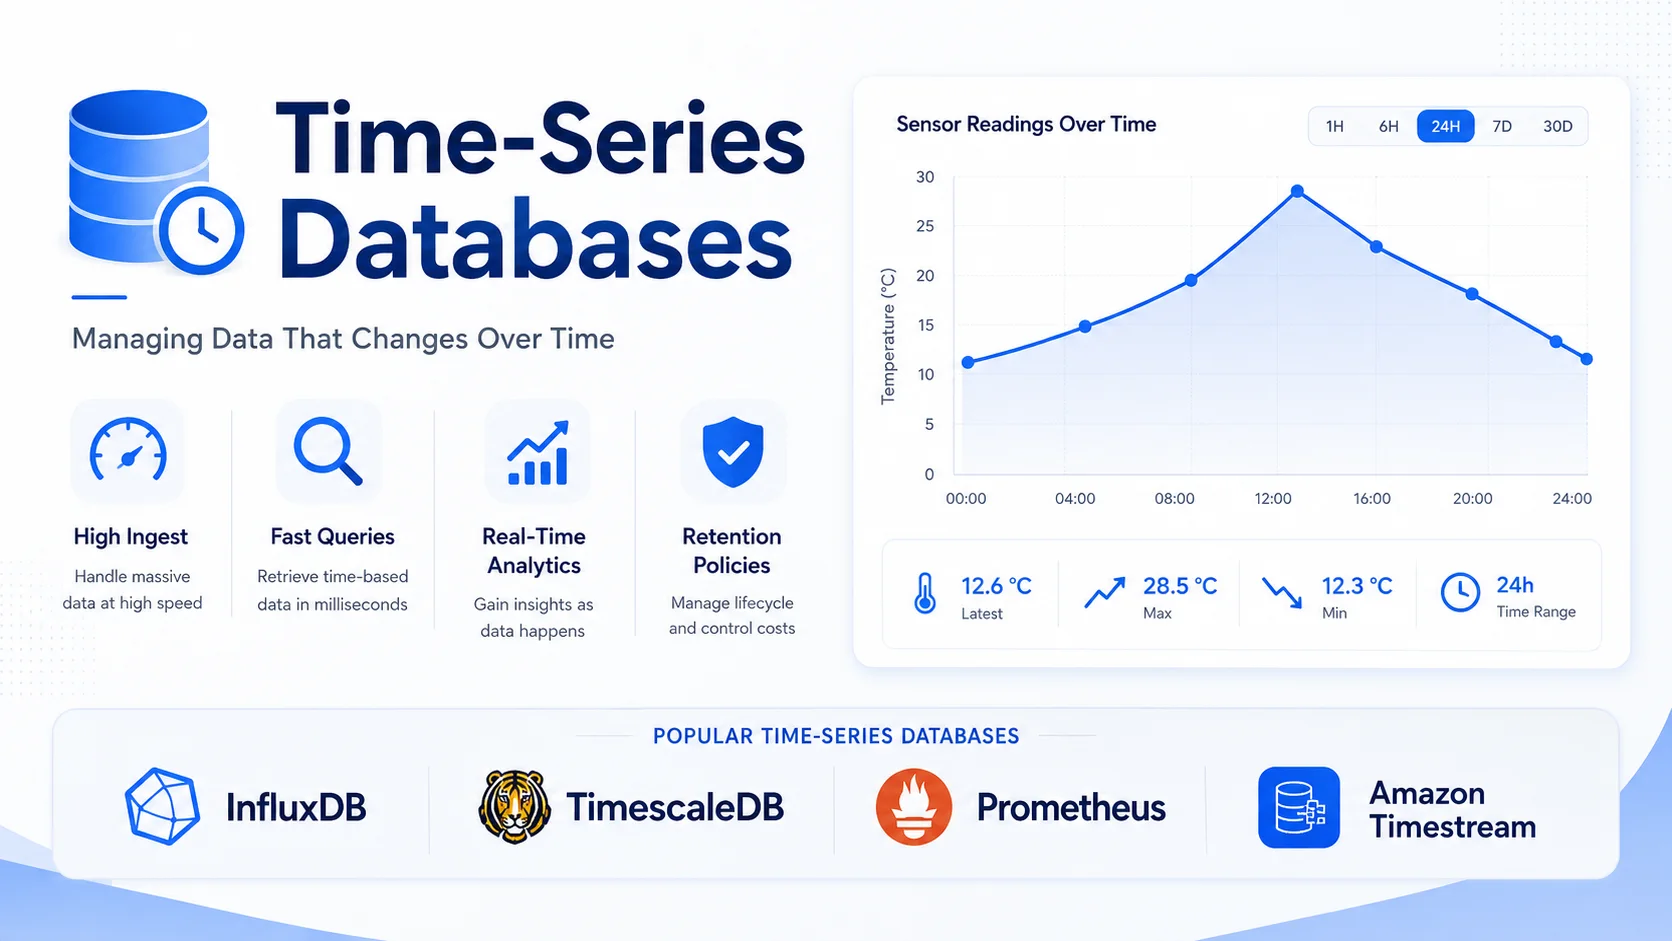
Bir zaman serisi veritabanı (TSDB), zamana göre indekslenen veri noktalarını (sensör okumaları, sunucu ölçümleri, uygulama günlükleri, finansal onay verileri ve IoT telemetrisi) depolamak ve sorgulamak için uzmanlaşmıştır. Zaman serisi verileri, geleneksel veritabanlarını optimalin altında kılan benzersiz özelliklere sahiptir:
Giriş
Bir zaman serisi veritabanı (TSDB), zamana göre indekslenen veri noktalarını (sensör okumaları, sunucu ölçümleri, uygulama günlükleri, finansal onay verileri ve IoT telemetrisi) depolamak ve sorgulamak için uzmanlaşmıştır. Zaman serisi verileri, geleneksel veritabanlarını optimalin altında kılan benzersiz özelliklere sahiptir:
- Yoğun yazma — Günde milyonlarca ila milyarlarca veri noktası.
- Yalnızca ekleme — Veriler nadiren güncellenir, neredeyse her zaman eklenir.
- Zaman sıralı — Sorgular her zaman bir zaman aralığı içerir.
- Saklamaya dayalı — Eski veriler zamanla özetlenir veya silinir.
- Altörneklenmiş — Daha eski veriler daha düşük çözünürlükte depolanır.
Zaman Serisi Veri Özellikleri
Veri Modeli
Her zaman serisi veri noktası şunları içerir:
| Bileşen | Örnek | Açıklama |
|---|---|---|
| Zaman damgası | 2026-05-24T14:30:00Z | Ölçümün alındığı zaman |
| Değer | 42.5 | Ölçülen değer |
| Metrik | cpu_usage | Ne ölçülüyor |
| Etiketler/Etiketler | ana bilgisayar=web01, bölge=abd-doğu | Filtreleme için meta veriler |
Metric: cpu_usage{host="web01", region="us-east"}
┌─────────────────────┬───────┐
│ Timestamp           │ Value │
├─────────────────────┼───────┤
│ 2026-05-24T14:30:00 │ 42.5  │
│ 2026-05-24T14:30:01 │ 43.2  │
│ 2026-05-24T14:30:02 │ 41.8  │
│ ...                 │ ...   │
└─────────────────────┴───────┘
Zaman Serisi ve Geleneksel Veritabanları
| Operasyon | PostgreSQL | Zaman ÖlçeğiDB (PostgreSQL + TS) | AkışDB (TSDB) |
|---|---|---|---|
| Yazma verimi | 10.000 satır/sn | 100K-1M satır/sn | 1 milyonun üzerinde satır/sn |
| Sorgu: Ortalama 1 saat, 5 dakikaya kadar | Dakika (tam tarama) | Saniye (sürekli toplam) | Saniye |
| Depolama | Satır odaklı | Hibrit satır/sütun | Sütun odaklı |
| Sıkıştırma | Varsayılan olarak yok | %90+ (yerel sıkıştırma) | 90%+ |
| Saklama politikaları | Manuel bölüm yönetimi | Otomatik | Otomatik |
| Veri altörnekleme | Manuel sorgular | Sürekli agregalar | Sorguları altörnekleme |
| SQL desteği | Tam | Tam (SQL) | Sınırlı (Akı/SQL) |
Zaman Serisi Veritabanı Karşılaştırması
| Özellik | Zaman ÖlçeğiDB | AkışDB | Prometheus | VictoriaMetrics | GörevDB |
|---|---|---|---|---|---|
| Motor | PostgreSQL uzantısı | Özel TS motoru | Özel çekme tabanlı | Özel TS motoru | Sütunlu |
| Sorgu dili | SQL | SQL/Akı | PromQL | PromQL uyumlu | SQL + Akışı |
| Yuma oranı | 1 milyon+/sn | 1 milyon+/sn | 500K/sn | 1 milyon+/sn | 2 milyon+/sn |
| Sıkıştırma | %90-97 | 90+% | Yok | 90+% | 90+% |
| Kümeleme | Çok düğümlü (zaman ölçeklib) | kurumsal | Yerel parçalama | Yerli | Yok |
| Saklama | Politikalarla otomatik | Otomatik | Yapılandırılabilir | Yapılandırılabilir | Manuel |
| Sürekli agregalar | Evet (yerli) | Hayır (ayrı görev) | Kayıt kuralları | Kayıt kuralları | Hayır |
| Şunlar için en iyisi | SQL kullanıcıları, operasyonel veriler | Nesnelerin İnterneti, DevOps | Kubernetes, Bulutta Yerel | Yüksek ölçekli metrikler | Finansal, yüksek hızlı |
InfluxDB: Özel TSDB
Veri Modeli
# InfluxDB v3 — data model
from influxdb_client import InfluxDBClient, Point
from influxdb_client.client.write_api import SYNCHRONOUS

client = InfluxDBClient(url="http://localhost:8086", token="my-token")
write_api = client.write_api(write_options=SYNCHRONOUS)

# A point = measurement + tags + fields + timestamp
point = (
    Point("temperature")
    .tag("sensor", "sensor-001")
    .tag("location", "warehouse-a")
    .field("value", 23.5)
    .field("humidity", 65.2)
    .time(datetime.utcnow())
)

write_api.write(bucket="sensors", record=point)
Sorgulama
-- InfluxDB SQL (v3)
SELECT time, value
FROM temperature
WHERE sensor = 'sensor-001'
  AND time >= NOW() - INTERVAL '1 hour'
ORDER BY time DESC;

-- Aggregation with downsampling
SELECT time_bucket(INTERVAL '5 minutes', time) as bucket,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp
FROM temperature
WHERE location = 'warehouse-a'
  AND time >= NOW() - INTERVAL '24 hours'
GROUP BY bucket
ORDER BY bucket;
Saklama Politikaları
-- InfluxDB: automatic data lifecycle
CREATE RETENTION POLICY "one_hour"
ON "sensors"
DURATION 1h
REPLICATION 1
DEFAULT;

CREATE RETENTION POLICY "one_week"
ON "sensors"
DURATION 168h
REPLICATION 1;

-- Create downsample task
CREATE TASK "downsample_1h" ON "sensors"
  EVERY 1 HOUR
  BEGIN
    -- Aggregate 1-minute data to 1-hour averages
    SELECT time_bucket(INTERVAL '1 hour', time) as time,
           AVG(value) as value
    INTO "one_week"."temperature_hourly"
    FROM "one_hour"."temperature"
    WHERE time >= NOW() - INTERVAL '2 hours'
    GROUP BY 1, sensor, location;
  END;
Prometheus: Bulutta Yerel İzleme
Mimari (Çekme Modeli)
┌─────────────────────────────────────────────────┐
│              Prometheus Server                   │
│  ┌──────────┐  ┌──────────┐  ┌───────────────┐  │
│  │ Retrieval│  │ TSDB     │  │ Alertmanager  │  │
│  │ (pull)   │──│ (storage)│──│ (alerts)      │  │
│  └─────┬────┘  └──────────┘  └───────────────┘  │
│        │                                          │
└────────┼──────────────────────────────────────────┘
         │
    ┌────┼────────────┬──────────────┐
    ▼    ▼            ▼              ▼
  App  App   Node Exporter   Custom Exporter
PromQL (Prometheus Sorgu Dili)
# Basic queries
cpu_usage{host="web01"}
http_requests_total[5m]

# Rate (per-second average)
rate(http_requests_total[5m])

# Aggregation
avg by (host) (cpu_usage)

# Histogram quantile
histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))

# Predict linear regression
predict_linear(node_disk_free_bytes[1h], 3600) < 0

# Recording rule (pre-computed)
- record: job:http_requests:rate5m
  expr: rate(http_requests_total[5m])
Hizmet Keşfi ve Hedefler
# prometheus.yml
scrape_configs:
  - job_name: 'kubernetes-nodes'
    kubernetes_sd_configs:
      - role: node
    relabel_configs:
      - source_labels: [__meta_kubernetes_node_label_kubernetes_io_role]
        regex: control-plane
        action: drop

  - job_name: 'custom-app'
    static_configs:
      - targets: ['app01:8080', 'app02:8080', 'app03:8080']
TimescaleDB: Zaman Serileri için PostgreSQL
TimescaleDB, tam SQL uyumluluğunu korurken zaman serisi yetenekleri ekleyen PostgreSQL'in bir uzantısıdır.
Hipertablolar
-- Create a hypertable (automatically partitions by time)
CREATE TABLE temperature (
    time TIMESTAMPTZ NOT NULL,
    sensor_id INTEGER,
    location TEXT,
    value DOUBLE PRECISION,
    humidity DOUBLE PRECISION
);

-- Convert to hypertable (partitions by 1 day chunks)
SELECT create_hypertable('temperature', 'time',
    chunk_time_interval => INTERVAL '1 day');

-- Add partitioning by location (optional, for multi-node)
SELECT add_dimension('temperature', 'location', number_partitions => 4);
Sıkıştırma
-- Enable compression on hypertable
ALTER TABLE temperature SET (
    timescaledb.compress,
    timescaledb.compress_segmentby = 'sensor_id',
    timescaledb.compress_orderby = 'time DESC'
);

-- Compression policy: compress data older than 7 days
SELECT add_compression_policy('temperature', INTERVAL '7 days');

-- Compression ratio: 90-97%
-- 100GB of raw data → 3-10GB compressed
Sürekli Toplamalar (Gerçekleştirilmiş Görünümler)
-- Create 5-minute aggregates (refreshed every minute)
CREATE MATERIALIZED VIEW temperature_hourly
WITH (timescaledb.continuous) AS
SELECT time_bucket('5 minutes', time) as bucket,
       sensor_id,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp,
       stddev(value) as temp_stddev
FROM temperature
GROUP BY bucket, sensor_id;

-- Refresh policy
SELECT add_continuous_aggregate_policy('temperature_hourly',
    start_offset => INTERVAL '3 days',
    end_offset => INTERVAL '1 hour',
    schedule_interval => INTERVAL '1 minute');
Veri Saklama
-- Automatic data removal
SELECT add_retention_policy('temperature_raw', INTERVAL '30 days');
SELECT add_retention_policy('temperature_hourly', INTERVAL '1 year');
SELECT add_retention_policy('temperature_daily', INTERVAL '5 years');
Sorgu Kalıpları
Altörnekleme
-- Raw data: 1m intervals, kept 30 days
-- 5m average: kept 1 year
-- 1h average: kept 5 years

SELECT time_bucket('1 hour', time) as hour,
       AVG(value) as avg_temperature,
       PERCENTILE_CONT(0.95) WITHIN GROUP (ORDER BY value) as p95
FROM temperature
WHERE time >= NOW() - INTERVAL '7 days'
GROUP BY hour
ORDER BY hour;
İnterpolasyon (Boşlukları Doldurma)
-- Fill missing data with linear interpolation
SELECT time_bucket('5 minutes', time) as bucket,
       INTERPOLATE(AVG(value)) as temperature
FROM temperature
WHERE sensor_id = 1
  AND time >= NOW() - INTERVAL '1 hour'
GROUP BY bucket
ORDER BY bucket;

-- Or use LAST observation carried forward (LOCF)
SELECT time_bucket('5 minutes', time) as bucket,
       LOCF(AVG(value)) as temperature
FROM temperature
GROUP BY bucket
ORDER BY bucket;
Anormallik Tespiti
-- Detect values outside 3 standard deviations
WITH stats AS (
    SELECT AVG(value) as mean,
           stddev(value) as sigma
    FROM temperature
    WHERE time >= NOW() - INTERVAL '24 hours'
)
SELECT time, value,
       (value - mean) / sigma as z_score
FROM temperature, stats
WHERE time >= NOW() - INTERVAL '1 hour'
  AND ABS((value - mean) / sigma) > 3
ORDER BY time;
Depolama ve Sıkıştırma
TSDB'ler Yüksek Sıkıştırmaya Nasıl Ulaşır?
Raw data layout (row-oriented):
time, sensor_id, location, value
14:30:00, 1, "room_a", 23.5
14:30:01, 1, "room_a", 23.6
14:30:02, 1, "room_a", 23.4
14:30:03, 1, "room_a", 23.7

Column-oriented + Delta encoding:
time:    14:30:00, +1s, +1s, +1s  → 1 value + 3 deltas
sensor_id: 1, 1, 1, 1 → run-length encoding: "1 × 4"
location: "room_a" × 4 → run-length encoding: "room_a × 4"
value: 23.5, +0.1, -0.2, +0.3 → delta encoding

Result: ~95% compression vs. raw text
Sıkıştırma Oranları
| Veritabanı | Ham | Sıkıştırılmış | Oran |
|---|---|---|---|
| Zaman ÖlçeğiDB | 100GB | 3-10GB | %90-97 |
| AkışDB | 100GB | 5-15GB | %85-95 |
| Prometheus | 100GB | 20-25GB | %75-80 |
| VictoriaMetrics | 100GB | 3-8GB | %92-97 |
Kullanım Durumları
1. Altyapı İzleme
# Node exporter metrics collected every 15 seconds
metrics:
  - cpu_usage{host="web01", cpu="0"}
  - memory_used{host="web01", type="RAM"}
  - disk_io{host="web01", device="sda", type="read_bytes"}
  - network_bytes{host="web01", interface="eth0", direction="in"}
  - load_average{host="web01", duration="1m"}

storage:
  raw: 15s intervals, 7 days
  aggregated: 5m intervals, 30 days
  daily: 1h intervals, 1 year
2. IoT Sensör Verileri
# Millions of devices sending data every minute
from timescaledb import hypertable

sensors = hypertable('sensor_data', 'time',
    chunk_time='1 day',
    compression='7 days',
    retention='90 days'
)

# Query: average temperature per device per hour
query = """
    SELECT time_bucket('1 hour', time) as hour,
           device_id,
           AVG(temperature) as avg_temp,
           COUNT(*) as samples
    FROM sensor_data
    WHERE time >= NOW() - INTERVAL '24 hours'
    GROUP BY hour, device_id
"""
3. Mali Kene Verisi
-- Stock price ticks: 10M+ per day per instrument
CREATE TABLE ticks (
    time TIMESTAMPTZ NOT NULL,
    symbol TEXT NOT NULL,
    price DOUBLE PRECISION,
    volume BIGINT,
    bid DOUBLE PRECISION,
    ask DOUBLE PRECISION
);

SELECT create_hypertable('ticks', 'time',
    chunk_time_interval => INTERVAL '1 hour');

-- OHLC (Open-High-Low-Close) candlestick query
SELECT time_bucket('5 minutes', time) as bucket,
       symbol,
       FIRST(price, time) as open,
       MAX(price) as high,
       MIN(price) as low,
       LAST(price, time) as close,
       SUM(volume) as volume
FROM ticks
WHERE symbol = 'AAPL'
  AND time >= NOW() - INTERVAL '1 day'
GROUP BY bucket, symbol;
En İyi Uygulamalar
Şema Tasarımı
-- Good schema: separate metrics by table
CREATE TABLE cpu_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);
CREATE TABLE memory_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);

-- Avoid: single wide table with all metrics as columns
-- (leads to sparse data, poor compression)
Parça Boyutu Ayarı
-- Too small: too many partitions, slow queries
-- Too large: poor memory management, slow ingestion
-- Rule of thumb: each chunk should be 1-10GB compressed

-- For 1000 writes/sec, 1KB each = 86GB/day
-- 1 day chunks = 86GB (too large)
-- 6 hour chunks = 21GB (good)
SELECT set_chunk_time_interval('temperature', INTERVAL '6 hours');
Sonuç
Zaman serisi veritabanları, modern sistemlerin çoğunu ürettiği veriler için amaca yönelik olarak oluşturulmuştur: uygulamalardan, altyapıdan, IoT cihazlarından ve finansal piyasalardan alınan zaman damgalı ölçümler.
| Kullanım Örneği | Önerilen Veritabanı |
|---|---|
| Altyapı izleme (Kubernetes) | Prometheus + VictoriaMetrics |
| SQL sorgularıyla IoT sensör verileri | Zaman ÖlçeğiDB |
| Gerçek zamanlı analiz, DevOps | AkışDB |
| Yüksek frekanslı finansal veriler | GörevDB |
| Bulutta yerel, çekme tabanlı ölçümler | Prometheus |
Temel çıkarımlar:
- TSDB'ler yazma açısından optimize edilmiştir — tek bir düğümde saniyede 1 milyondan fazla veri noktasını işler.
- Yüksek sıkıştırma (%90+) — daha az maliyetle daha fazla veri depolayın.
- Otomatik veri yaşam döngüsü — saklama politikaları + alt örnekleme, depolama maliyetlerini azaltır.
- Mümkün olduğunda SQL desteği — TimescaleDB tam SQL uyumluluğu sağlar.
- Farklı ihtiyaçlar için farklı araçlar — Bulutta yerel için Prometheus, DevOps için InfluxDB, SQL konusunda uzman kullanıcılar için TimescaleDB.
Doğru zaman serisi mimarisi, verileri verimli bir şekilde alır, zarif bir şekilde yaşlandırır ve anında sorgulayarak ham zaman damgalı sayıları eyleme geçirilebilir içgörülere dönüştürür.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
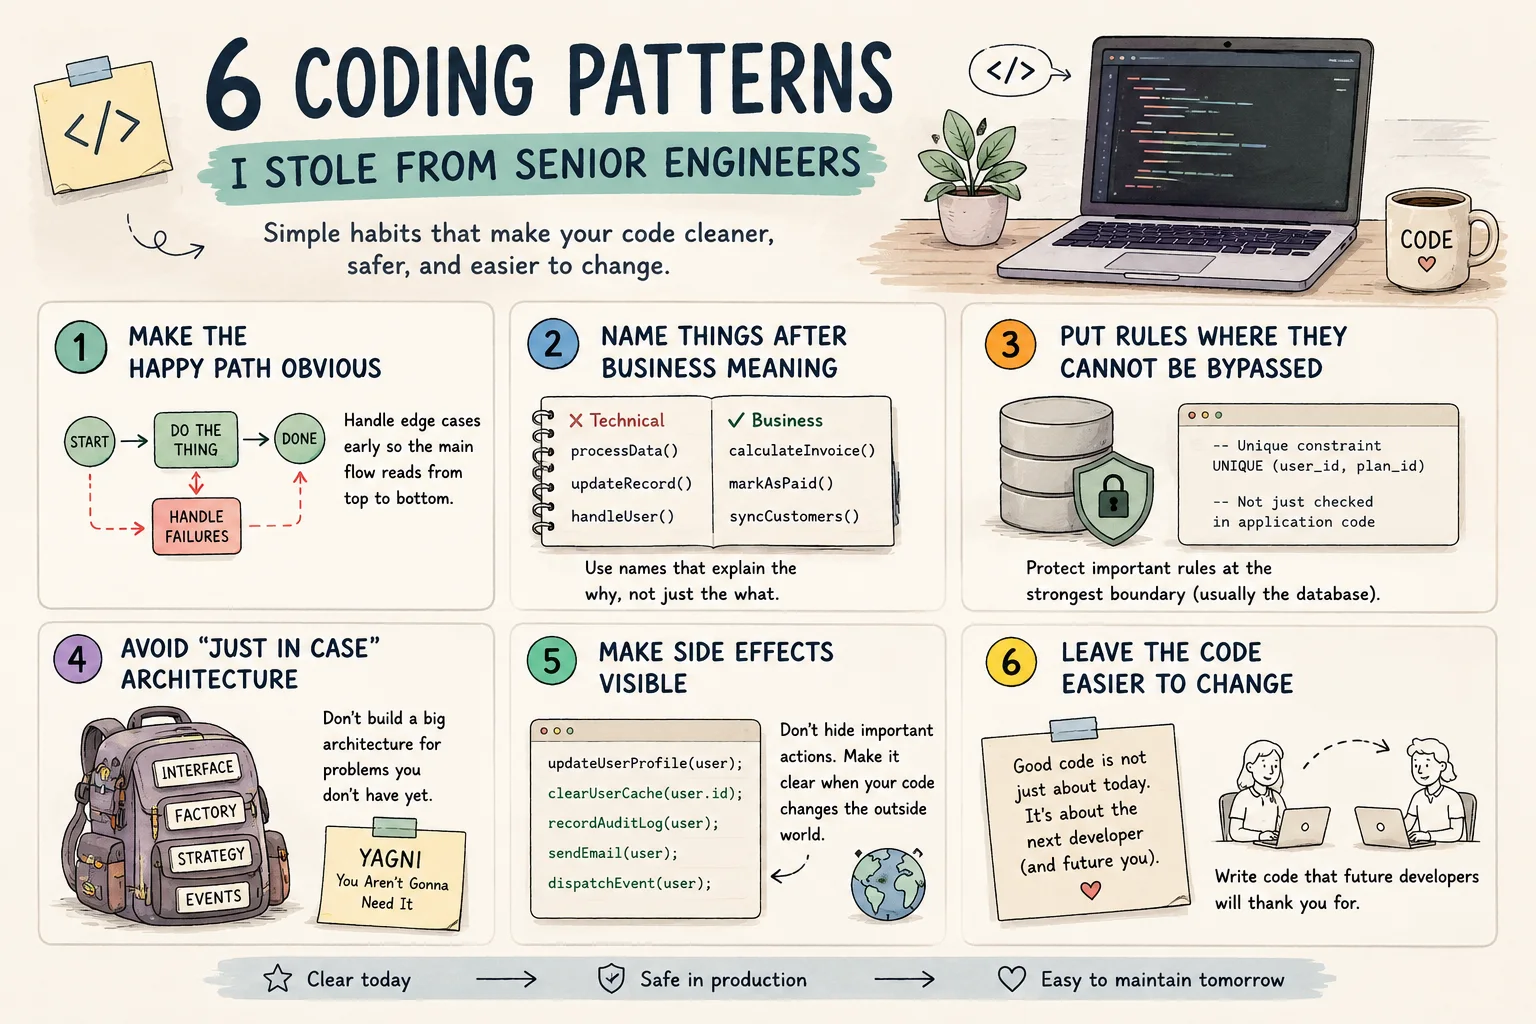
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.