Alma-Artırılmış Nesil (RAG): Mimari, Desenler ve Üretim
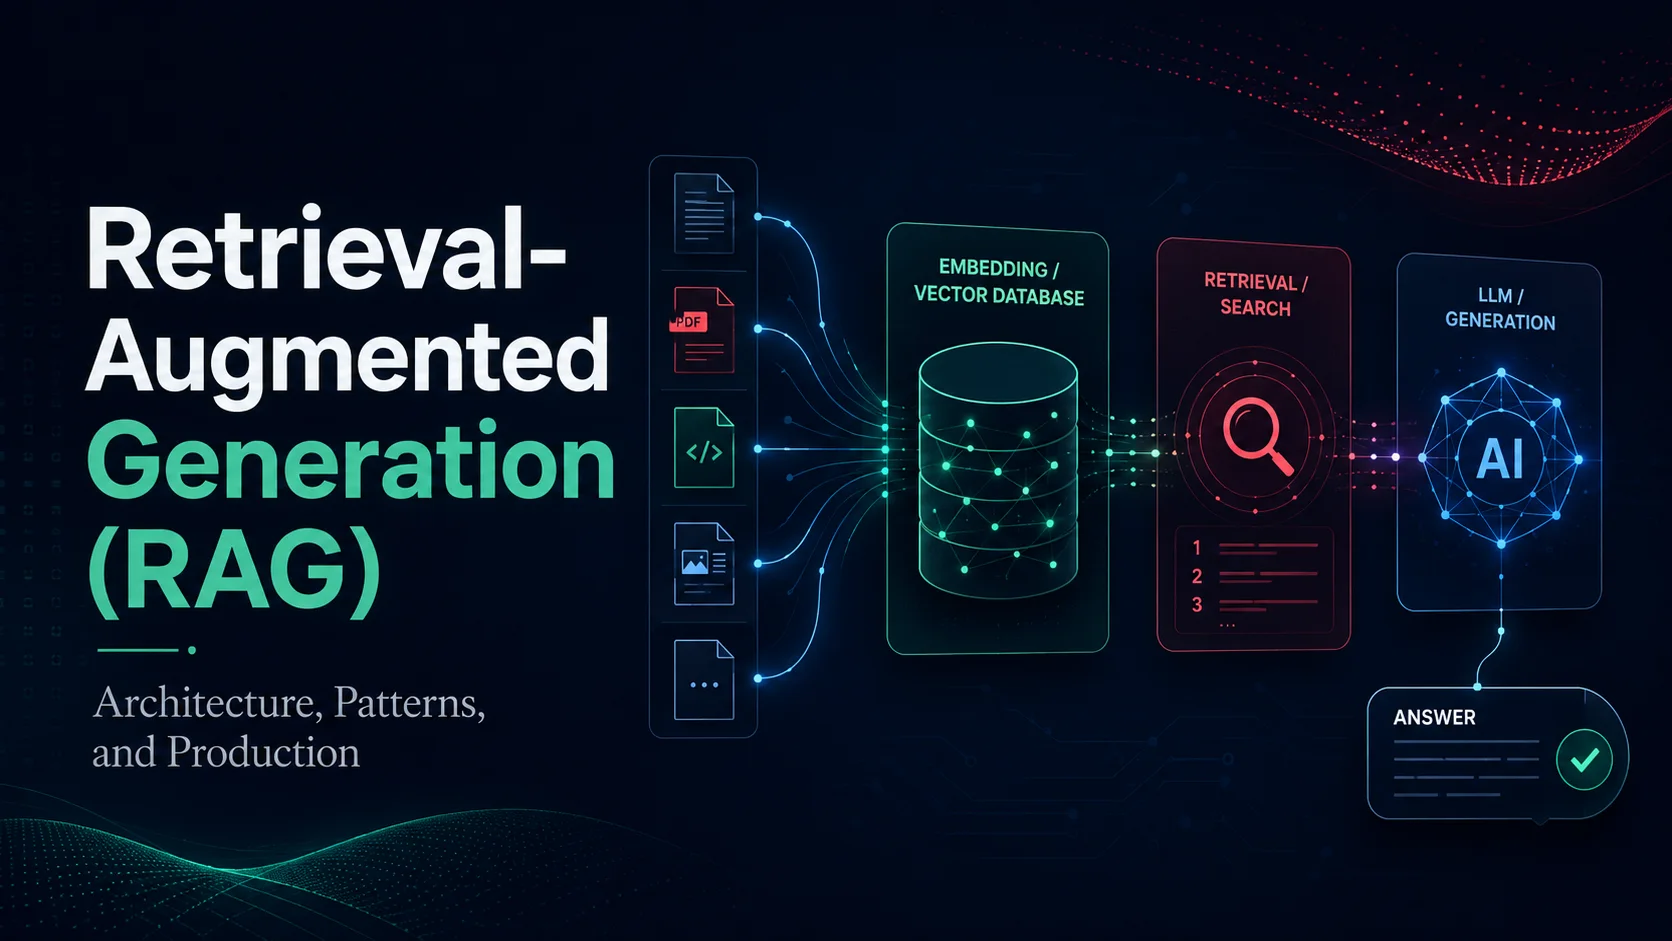
Alma-Artırılmış Üretim (RAG), bilgi almayı büyük dil modelleriyle (LLM'ler) birleştiren bir yapay zeka mimarisidir. RAG, yanıtlar için yalnızca Yüksek Lisans'ın eğitim verilerine güvenmek yerine, ilgili bilgileri bir bilgi tabanından alır ve Yüksek Lisans'a bağlam olarak sağlar.
Giriş
Alma-Artırılmış Üretim (RAG), bilgi almayı büyük dil modelleriyle (LLM'ler) birleştiren bir yapay zeka mimarisidir. RAG, yanıtlar için yalnızca Yüksek Lisans'ın eğitim verilerine güvenmek yerine, ilgili bilgileri bir bilgi tabanından alır ve Yüksek Lisans'a bağlam olarak sağlar.
Bu yaklaşım üç kritik Yüksek Lisans sınırlamasını çözer: güncelliği geçmiş bilgi (eğitim verilerinin kesilmesi), halüsinasyon (gerçekleri uydurmak) ve özel verilere erişim eksikliği (dahili belgelerinizi bilmemek).
Neden RAG?
Yüksek Lisans Sınırlamaları ve RAG Çözümleri
| Sorun | RAG'sız LLM | RAG'lı Yüksek Lisans |
|---|---|---|
| Bilgi kesintisi | Yalnızca eğitim tarihine kadar olan verileri bilir | Bilgi tabanından yeni bilgiler alır |
| Halüsinasyon | Belirsiz olduğunda gerçekleri icat edebilir | Alınan bağlamda yanıtları temel alır |
| Özel veriler | Dahili belgelerinizi görmedi | Kurumsal bilgi tabanında arama yapar |
| Kaynak ilişkilendirmesi | Kaynaklardan alıntı yapılamaz | Alıntılarla birlikte tam parçaları döndürür |
| Maliyet | İnce ayar pahalıdır | Eğitim gerekmez; yalnızca belgeleri dizinleyin |
RAG ve İnce Ayar Karşılaştırması
| Görünüş | paçavra | İnce Ayar |
|---|---|---|
| Bilgi güncellemeleri | Anında (vektör DB'yi güncelle) | Haftalar (modeli yeniden eğitme) |
| Eğitim maliyeti | Yok | 100$-10.000$+ |
| Yeni konseptler | Evet — bilgi tabanına ekle | Hayır — yeniden eğitim gerektirir |
| Halüsinasyon önleme | İyi (bağlam temellendirme) | Sınırlı (ezberleme) |
| Kaynak ilişkilendirmesi | Evet | Hayır (kara kutu) |
| Gecikme | Daha yüksek (geri alma + oluşturma) | Daha düşük (sadece nesil) |
| Ne zaman kullanılmalı | Güncel bilgilere, alıntılara ve özel verilere ihtiyacınız var | Model davranışını, tonunu, çıktı formatını değiştirmeniz gerekiyor |
RAG Mimarlık
Yüksek Seviye Akış
                      ┌───────────────────────┐
                      │   Document Processing  │ (Ingestion Pipeline)
                      │   (Chunking → Embed)   │
                      └──────────┬────────────┘
                                 │
                                 ▼
                      ┌───────────────────────┐
                      │   Vector Database     │
                      │   (Knowledge Base)    │
                      └──────────┬────────────┘
                                 │
                      ┌──────────▼────────────┐
User Query ──────────►│   Retrieval Pipeline   │
                      │  (embed → search →     │
                      │   fetch chunks)        │
                      └──────────┬────────────┘
                                 │ (relevant chunks)
                                 ▼
                      ┌───────────────────────┐
                      │   Generation          │
                      │  (LLM + Context)      │
                      └──────────┬────────────┘
                                 │ (answer with citations)
                                 ▼
                           Final Answer
Besleme Boru Hattı
1. Belge Yükleme
from langchain_community.document_loaders import (
    PDFLoader, TextLoader, CSVLoader,
    UnstructuredHTMLLoader, ConfluenceLoader
)

# Load various document types
loaders = {
    '.pdf': PDFLoader("policy.pdf"),
    '.txt': TextLoader("readme.txt"),
    '.html': UnstructuredHTMLLoader("page.html"),
    '.csv': CSVLoader("data.csv"),
}

documents = []
for ext, loader in loaders.items():
    documents.extend(loader.load())
2. Parçalama Stratejisi
Parçalama kritik öneme sahiptir; çok küçük olması bağlamı kaybeder, çok büyük olması ise gürültüye neden olur:
from langchain.text_splitter import (
    RecursiveCharacterTextSplitter,
    TokenTextSplitter,
    SemanticChunker
)

# Recursive character splitting (most common)
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    separators=["\n\n", "\n", " ", ""],
    length_function=len,
)

# Semantic chunking (AI-aware — splits at topic boundaries)
semantic_splitter = SemanticChunker(
    embeddings=openai_embeddings,
    breakpoint_threshold_type="percentile",
)

chunks = text_splitter.split_documents(documents)
Parçalanmış Takaslar
| Strateji | Parça Boyutu | Geri çağırma | Hassasiyet | En İyisi |
|---|---|---|---|---|
| Küçük parçalar | 200-500 jeton | Yüksek | Düşük (parçalanmış) | SSS, tanımlar |
| Orta parçalar | 500-1500 jeton | Orta | Orta | Genel RAG |
| Büyük parçalar | 1500-3000 jeton | Düşük | Yüksek | Özetleme |
| Anlamsal parçalar | Değişken | Yüksek | Yüksek | Karmaşık belgeler |
3. Yerleştirme
from langchain_openai import OpenAIEmbeddings
from langchain_qdrant import QdrantVectorStore

embeddings = OpenAIEmbeddings(
    model="text-embedding-3-small",
    dimensions=1536,
)

vector_store = QdrantVectorStore.from_documents(
    documents=chunks,
    embedding=embeddings,
    url="http://localhost:6333",
    collection_name="knowledge_base",
)
Geri Alma Boru Hattı
1. Sorguyu Anlamak
from langchain.llms import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

def rewrite_query(original_query: str) -> str:
    """Rewrite user query for better retrieval"""
    prompt = ChatPromptTemplate.from_messages([
        ("system", "You are a query rewriting assistant. "
         "Rewrite the user's question to be more specific "
         "and searchable in a knowledge base."),
        ("user", original_query),
    ])
    llm = ChatOpenAI(model="gpt-4o-mini")
    return llm.invoke(prompt).content

# Example:
# Original: "What about vacation?"
# Rewritten: "What is the company policy on paid vacation days,
#             including accrual rate and carry-over limits?"
2. Erişim Stratejileri
Basit benzerlik araması:
results = vector_store.similarity_search_with_score(
    query=rewritten_query,
    k=5,
    score_threshold=0.75,
)
Hibrit arama (vektör + anahtar kelime):
# BM25 keyword scores combined with vector similarity
from langchain.retrievers import BM25Retriever, EnsembleRetriever

bm25_retriever = BM25Retriever.from_documents(chunks, k=5)
vector_retriever = vector_store.as_retriever(search_kwargs={"k": 5})

# Weighted ensemble
ensemble_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, bm25_retriever],
    weights=[0.7, 0.3],
)
Çoklu sorgu alımı:
def generate_sub_queries(query: str, n: int = 3) -> list[str]:
    """Generate multiple perspectives on the same query"""
    prompt = f"Generate {n} different versions of this query for search: {query}"
    response = llm.invoke(prompt)
    return response.content.split('\n')

sub_queries = generate_sub_queries("remote work policy")
# Returns:
# - "How many days per week can employees work from home?"
# - "Remote work eligibility and approval process"
# - "Company work-from-home policy and guidelines"

all_results = []
for q in sub_queries:
    all_results.extend(vector_store.similarity_search(q, k=3))
3. Yeniden Sıralama
Çapraz kodlayıcıyla sonuçları yeniden sıralayarak alma kalitesini artırın:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

pairs = [(query, result.page_content) for result in initial_results]
scores = reranker.predict(pairs)

reranked_results = [
    result for _, result in
    sorted(zip(scores, initial_results), key=lambda x: x[0], reverse=True)
]

# Take top 3 after reranking
final_context = reranked_results[:3]
Üretim Boru Hattı
Sistem İstemi Mühendisliği
rag_prompt = """You are a helpful assistant that answers questions based
on the provided context. Follow these rules:

1. Answer ONLY using information from the provided context.
2. If the context does not contain the answer, say
   "I don't have enough information to answer this question."
3. Do NOT make up or infer information not in the context.
4. Include citations in [Source: filename.pdf] format.
5. Be concise but thorough.
6. Format lists and tables using markdown when appropriate.

Context:
{context}

Question: {question}
Answer (with citations):"""
Alıntılarla Nesil
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

qa_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    chain_type="stuff",  # "stuff" = put all context in one prompt
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    chain_type_kwargs={
        "prompt": PromptTemplate.from_template(rag_prompt),
        "verbose": True,
    },
    return_source_documents=True,
)

result = qa_chain.invoke({"query": "What is the vacation policy?"})

print(result['result'])
# "Employees accrue 15 days of paid vacation per year (accrued monthly
# at 1.25 days/month). Unused days may carry over up to 5 days to the
# next calendar year. [Source: HR_Handbook_2026.pdf]"

print(result['source_documents'])
# [Document(page_content="...", metadata={"source": "HR_Handbook_2026.pdf", ...})]
Gelişmiş RAG Desenleri
1. Çok Atlamalı RAG
Birden fazla belgeden bilgi gerektiren sorular için:
Q: "Which products are affected by the new regulation and who needs training?"

Step 1: Retrieve regulation document → identifies affected product categories
Step 2: Use product list to query training documents
Step 3: Compose answer from both sources
2. Ajan RAG
Erişimi planlamak, hangi araçların kullanılacağına karar vermek ve yinelemek için bir Yüksek Lisans temsilcisi kullanın:
from langchain.agents import AgentExecutor, create_openai_functions_agent
from langchain.tools import Tool

retrieval_tool = Tool(
    name="search_knowledge_base",
    func=lambda q: vector_store.similarity_search(q, k=3),
    description="Search company knowledge base for policies and procedures"
)

calculator_tool = Tool(
    name="calculator",
    func=lambda expr: eval(expr),
    description="Perform mathematical calculations"
)

agent = create_openai_functions_agent(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    tools=[retrieval_tool, calculator_tool],
    prompt=agent_prompt,
)
agent_executor = AgentExecutor(agent=agent, tools=[retrieval_tool, calculator_tool])
3. Kendinden Yansıtıcı RAG (Kendinden Yansıtıcı RAG)
Model kendi alma ve oluşturma kalitesini kontrol eder:
def self_rag(query: str) -> str:
    # 1. Retrieve
    docs = retrieve(query, k=5)

    # 2. Check: is retrieved info relevant?
    relevance_score = check_relevance(query, docs)

    if relevance_score < 0.7:
        return "I cannot find relevant information to answer this question."

    # 3. Generate answer
    answer = generate(query, docs)

    # 4. Check: does answer match retrieved info?
    faithfulness_score = check_faithfulness(answer, docs)

    if faithfulness_score < 0.8:
        return generate_with_constraints(query, docs)  # Regenerate

    # 5. Check: is answer useful?
    usefulness_score = check_usefulness(query, answer)

    return answer
4. Düzeltici RAG (CRAG)
Oluşturmadan önce alır, değerlendirir ve düzeltir:
def corrective_rag(query):
    # Initial retrieval
    docs = retrieve(query)

    # Evaluate retrieval quality
    quality = evaluate_retrieval(query, docs)

    if quality == "excellent":
        # Direct generation
        return generate(query, docs)

    elif quality == "partial":
        # Re-rank and try again
        docs = rerank_and_retry(query, docs)
        return generate(query, docs)

    else:  # poor
        # Try web search or generate without context
        if web_search_available:
            docs = web_search(query)
            return generate(query, docs)
        else:
            return generate_without_context(query)
Üretim RAG Konuları
Değerlendirme Metrikleri
| Metrik | Neyi Ölçer? | Hedef |
|---|---|---|
| Geri çağırma | İlgili tüm parçaları bulduk mu? | > 0,90 |
| Bağlam hassasiyeti | Alınan parçalar gerçekten alakalı mı? | > 0,85 |
| Sadakat | Cevap bağlama sadık kalıyor mu? | > 0,95 |
| Cevap alaka düzeyi | Cevap soruyu ele alıyor mu? | > 0,90 |
| Halüsinasyon oranı | Uydurulmuş gerçeklerin yüzdesi | < %1 |
İzleme
class RAGMonitor:
    def __init__(self):
        self.metrics = {
            'retrieval_latency': [],
            'generation_latency': [],
            'context_token_count': [],
            'completion_token_count': [],
        }

    def log_query(self, query: str, retrieval_time: float,
                  gen_time: float, context: str, response: str):
        self.metrics['retrieval_latency'].append(retrieval_time)
        self.metrics['generation_latency'].append(gen_time)
        # Track context size — too large = expensive, too small = poor quality
        self.metrics['context_token_count'].append(count_tokens(context))
        # Log for later analysis
        log_to_db(query, response, context)

    def alert_if_degraded(self):
        avg_latency = mean(self.metrics['generation_latency'][-100:])
        if avg_latency > 5.0:  # seconds
            alert_pagerduty("RAG generation latency degraded")
Gecikme Bütçesi
Total RAG latency: 1.5-4 seconds
├── Query embedding:      100-300ms
├── Vector search:         50-200ms
├── Reranking:            100-300ms
├── Context formatting:    10-50ms
└── LLM generation:      1000-3000ms (depends on output length)
Parçalama ve Dizine Ekleme En İyi Uygulamaları
| Alıştırma | neden | Uygulama |
|---|---|---|
| Meta veri depolama | Filtreleme, kaynak, alıntılar | Dosya adını, sayfa numarasını, bölüm başlığını, tarihi saklayın |
| Ebeveyn-çocuk parçalaması | Küçük parçaları alın, büyük bağlamı döndürün | Arama için küçük parçaları saklayın, nesil için ana öğeye bağlantı verin |
| Belge özeti | Geniş kapsamlı sorular için küresel bağlam | Belge başına bir özet saklayın, ilk filtreleme için kullanın |
| İçerik tekilleştirme | Gereksiz bağlamdan kaçının | Karma parçalar, neredeyse kopyaları kaldırın |
| Sürüm oluşturma | Belge güncellemelerini takip edin | Meta verilere sürüm alanı ekleyin, geri alma desteği |
Sonuç
RAG, LLM'leri doğru, güncel ve ilişkilendirilebilir bilgilerle dağıtmanın en pratik yoludur. Temel çıkarımlar:
- RAG > ince ayar çoğu kullanım durumu için — daha ucuz, daha esnek, güncellenebilir.
- Parçalama kalitesi RAG kalitesini belirler — doğru stratejiyi bulmak için zaman ayırın.
- Karma arama, saf vektörü yener — daha iyi hatırlama için anahtar kelimeyle birleştirin.
- Yeniden sıralama ekstra adıma değerdir — sonuç kalitesini önemli ölçüde artırır.
- Bozulmayı izleyin — Belgeler eklendikçe alma kalitesi değişir.
- Basitten başlayın, gerektiği kadar karmaşıklık ekleyin — temel RAG iyi çalışır; gelişmiş modeller belirli sorunları çözer.
RAG, erişim destekli sistemlerin başarabileceklerinin sınırlarını zorlayan etmenli, kendini yansıtan ve düzeltici değişkenlerle hızla gelişiyor.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
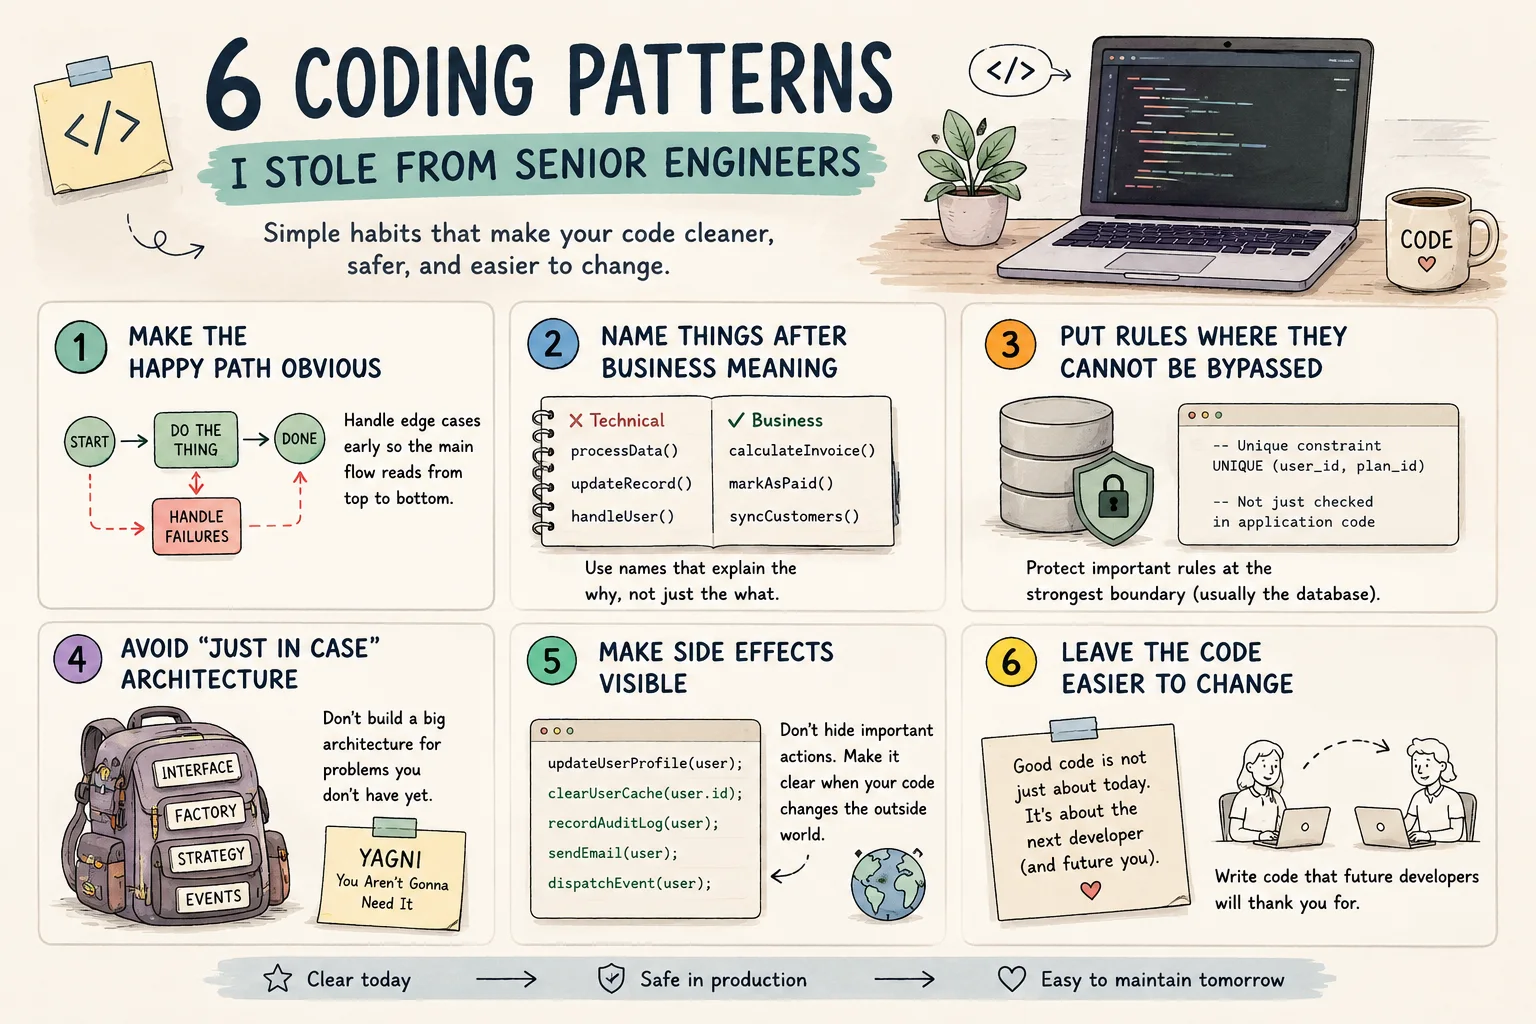
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.