Grafik Veritabanları: Bağlantılı Verilerin Modellenmesi
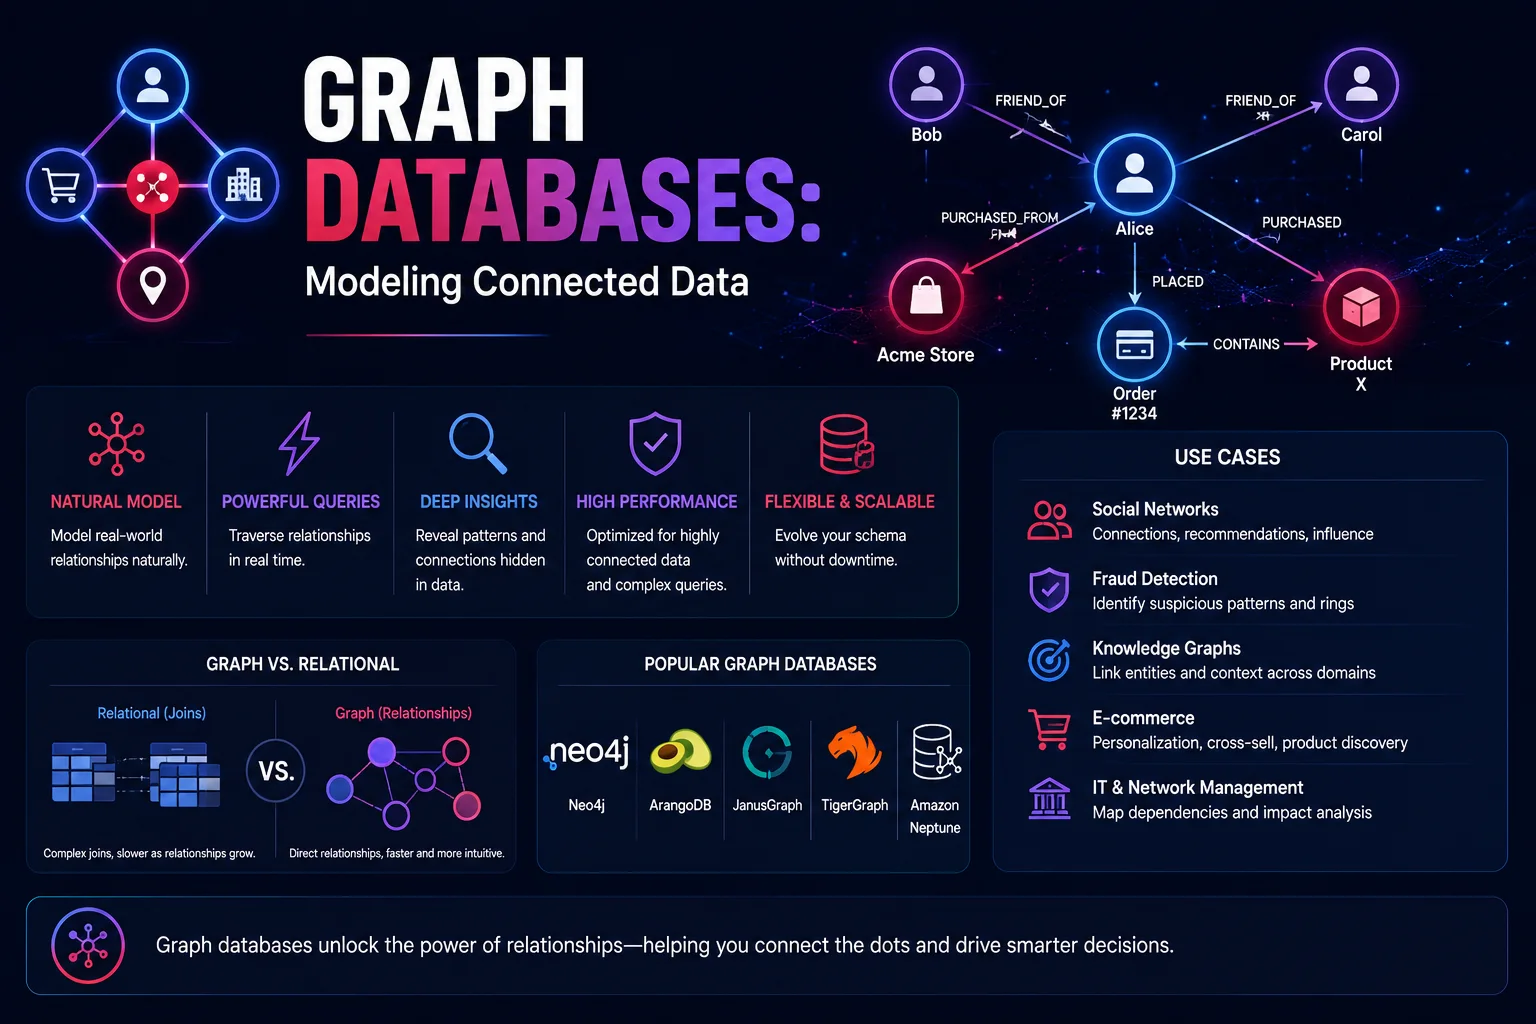
Grafik veritabanları, yüksek düzeyde bağlantılı verileri depolamak ve sorgulamak için özel olarak tasarlanmıştır. İlişkisel veritabanları bilinen ilişkilere sahip tablo halindeki verilerde başarılı olurken, grafik veritabanları ilişkilerin verinin kendisi kadar önemli olduğu durumlarda (sosyal ağlar, öneri motorları, dolandırıcılık tespiti, bilgi grafikleri ve tedarik zincirleri) öne çıkar.
Giriş
Grafik veritabanları, yüksek düzeyde bağlantılı verileri depolamak ve sorgulamak için özel olarak tasarlanmıştır. İlişkisel veritabanları bilinen ilişkilere sahip tablo halindeki verilerde başarılı olurken, grafik veritabanları ilişkilerin verinin kendisi kadar önemli olduğu durumlarda (sosyal ağlar, öneri motorları, dolandırıcılık tespiti, bilgi grafikleri ve tedarik zincirleri) öne çıkar.
Temel içgörü: Birçok alanda, varlıklar arasındaki bağlantılar verilerdir ve grafik veritabanları bu bağlantıları birinci sınıf vatandaş haline getirir.
Grafik Veritabanı Kavramları
Özellik Grafiği Modeli
       ┌──────────────────┐
       │   Person         │
       │  name: "Alice"  │
       │  age: 30        │
       └────────┬─────────┘
                │
       ┌────────▼─────────┐
       │   KNOWS           │
       │  since: 2020      │
       │  type: "friend"   │
       └────────┬─────────┘
                │
       ┌────────▼─────────┐
       │   Person         │
       │  name: "Bob"    │
       │  age: 32         │
       └──────────────────┘
Üç temel bileşen:
| Bileşen | Açıklama | Örnek |
|---|---|---|
| Düğüm (Köşe) | Grafikteki bir varlık | Kişi, Şirket, Ürün |
| Kenar (İlişki) | İki düğüm arasındaki bağlantı | BİLİYOR, ÇALIŞIYOR, SATIN ALINDI |
| Gayrimenkul | Düğümlerdeki veya kenarlardaki nitelikler | isim: "Alice", şu tarihten beri: 2020 |
İlişkisel ve Grafik
SQL'de ilişkileri sorgulama:
-- Find friends of friends who work at Google
SELECT DISTINCT p3.name
FROM persons p1
JOIN friendships f1 ON p1.id = f1.person_id
JOIN persons p2 ON f1.friend_id = p2.id
JOIN friendships f2 ON p2.id = f2.person_id
JOIN persons p3 ON f2.friend_id = p3.id
JOIN employment e ON p3.id = e.person_id
JOIN companies c ON e.company_id = c.id
WHERE p1.name = 'Alice'
  AND c.name = 'Google';
Cypher'da (Neo4j) aynı sorgu:
MATCH (alice:Person {name: "Alice"})
      -[:KNOWS*2]->
      (friend_of_friend:Person)
MATCH (friend_of_friend)-[:WORKS_AT]->(google:Company {name: "Google"})
RETURN DISTINCT friend_of_friend.name
Önemli fark: SQL birden fazla JOIN ile denge kurar. Grafik geçişleri desenlerle doğal olarak eşleşir.
Grafik Sorgulama Dilleri
Cypher (Neo4j) – Bildirime Dayalı Desen Eşleştirme
// Create nodes and relationships
CREATE (alice:Person {name: "Alice", age: 30})
CREATE (bob:Person {name: "Bob", age: 32})
CREATE (alice)-[:KNOWS {since: 2020}]->(bob)

// Find friends of friends who bought products in the last month
MATCH (user:Person {id: $userId})
      -[:KNOWS]->
      (friend:Person)
      -[:PURCHASED]->
      (product:Product)
WHERE product.purchased_at > datetime() - duration('P1M')
RETURN product.name, count(*) as purchase_count
ORDER BY purchase_count DESC
LIMIT 10

// Shortest path between two people
MATCH p = shortestPath(
  (alice:Person {name: "Alice"})-[:KNOWS*]-(bob:Person {name: "Bob"})
)
RETURN length(p) as degrees_of_separation,
       [node IN nodes(p) | node.name] as path
Gremlin (Apache TinkerPop) — Zorunlu Grafik Geçişi
// Same query in Gremlin
g.V().has('Person', 'name', 'Alice')
  .repeat(out('KNOWS')).times(2)
  .out('WORKS_AT')
  .has('Company', 'name', 'Google')
  .values('name')
  .dedup()
SPARQL (RDF) — Anlamsal Web
PREFIX foaf: <http://xmlns.com/foaf/0.1/>
PREFIX org: <http://www.w3.org/ns/org#>

SELECT ?name WHERE {
  ?alice foaf:name "Alice" ;
         foaf:knows ?friend .
  ?friend foaf:knows ?friend_of_friend .
  ?friend_of_friend org:memberOf ?company .
  ?company org:legalName "Google" .
  ?friend_of_friend foaf:name ?name .
}
Grafik Veritabanı Karşılaştırması
| Özellik | Neo4j | Amazon Neptün | ArangoDB | Janus Grafiği | Dgraf |
|---|---|---|---|---|---|
| Sorgu dili | Şifre | Gremlin/SPARQL | AQL | Gremlin | GraphQL+ |
| Depolamak | Yerel grafik | RDF/Özellik | Çoklu model | Cassandra/HBase | Porsuk |
| Kümeleme | kurumsal | Yönetilen | Evet | Evet | Evet |
| ASİT | Evet | Evet | Evet | Depolama başına | Evet |
| Ücretsiz katman | Topluluk (1 düğüm) | Kullandığın kadar öde | Açık kaynak | Açık kaynak | Açık kaynak |
| Şunlar için en iyisi | Kurumsal grafikler | AWS ekosistemi | Çoklu model | Büyük veri grafikleri | Yüksek performans |
| Vektör arama | ✅ (5.x+) | ❌ | ✅ | ❌ | ❌ |
Kullanım Durumları
1. Sosyal Ağlar ve Öneriler
(User:Alice)-[:KNOWS]->(User:Bob)
(User:Alice)-[:LIKES]->(Movie:Inception)
(User:Bob)-[:LIKES]->(Movie:Inception)
(User:Charlie)-[:KNOWS]->(User:Alice)
Öneri sorgusu - "Arkadaşların arkadaşlarının beğendiği filmler":
MATCH (me:User {id: $userId})
      -[:KNOWS*1..2]-
      (other:User)
      -[:LIKES]->
      (movie:Movie)
WHERE NOT EXISTS {
  (me)-[:LIKES]->(movie)
  OR (me)-[:DISLIKES]->(movie)
}
RETURN movie.title, count(DISTINCT other) as friend_count,
       avg(other.rating) as avg_rating
ORDER BY friend_count DESC, avg_rating DESC
LIMIT 20
2. Dolandırıcılık Tespiti
Dolandırıcılık halkaları karmaşık, belirgin olmayan modeller sergiliyor. Grafik sorguları bunları verimli bir şekilde algılar:
// Detect potential fraud rings:
// Multiple accounts sharing same device, IP, or phone
MATCH (account:Account)
      -[:USED_DEVICE]->(device:Device)<-[:USED_DEVICE]-
      (other:Account),
      (account)-[:USED_IP]->(ip:IPAddress)<-[:USED_IP]-
      (other)
WHERE account.id <> other.id
  AND account.created_at > datetime() - duration('P7D')
RETURN account.id, other.id, device.device_id, ip.address,
       count(*) as connection_count
ORDER BY connection_count DESC
LIMIT 100
Dolandırıcılık tespit istatistikleri:
| Metrik | Grafikten Önce | Grafikten Sonra |
|---|---|---|
| Tespit oranı | 65% | 93% |
| Yanlış pozitiflik oranı | 8% | 2% |
| Vaka başına soruşturma süresi | 45 dakika | 5 dakika |
3. Bilgi Grafikleri
Bilgi grafikleri yapılandırılmış ve yapılandırılmamış verileri birleşik bir anlam ağına bağlar:
// Create a knowledge graph from documents
LOAD CSV WITH HEADERS FROM 'file:///entities.csv' AS row
CREATE (e:Entity {
  id: row.id,
  name: row.name,
  type: row.type,
  description: row.description
});

LOAD CSV WITH HEADERS FROM 'file:///relationships.csv' AS row
MATCH (a:Entity {id: row.source_id})
MATCH (b:Entity {id: row.target_id})
CALL apoc.create.relationship(a, row.relationship_type, {
  source_document: row.document,
  confidence: toFloat(row.confidence)
}) YIELD rel
RETURN count(*);

// Query: "How does Product X relate to Regulation Y?"
MATCH path = shortestPath(
  (product:Entity {name: "Product X"})
  -[:AFFECTS|REGULATES|DEPENDS_ON|MANUFACTURED_BY*]-
  (regulation:Entity {name: "Regulation Y"})
)
RETURN [node IN nodes(path) | {name: node.name, type: node.type}],
       [rel IN relationships(path) | type(rel)]
4. Tedarik Zinciri
// Find all suppliers that feed into a critical component
MATCH (component:Part {name: "Critical Microchip"})
      <-[:PRODUCES]-
      (:Factory)
      -[:SOURCES_FROM]->
      (supplier:Supplier)
      -[:SUPPLIED_BY]->
      (sub_supplier:Supplier)
WHERE sub_supplier.location IN ["Region_A", "Region_B"]
RETURN component.name, supplier.name, sub_supplier.name,
       sub_supplier.location

// Impact analysis: "If Supplier X fails, which products are affected?"
MATCH (failing:Supplier {id: $supplierId})
      <-[:SUPPLIED_BY]-*
      (factory:Factory)
      -[:PRODUCES]->
      (product:Product)
RETURN product.name, product.revenue,
       count(DISTINCT factory) as factories_affected
ORDER BY product.revenue DESC
Grafik Veritabanı Dahili Bileşenleri
Dizinsiz Yakınlık
Yerel grafik veritabanlarının temel performans avantajı: her düğüm doğrudan bağlı komşularına işaret eder. Geçişler için dizin aramasına gerek yoktur.
Relational Database:                         Graph Database:
                                            ┌────────┐
Find friends:                              │ Alice  │──┐
1. Index lookup on person_id ──┐            │        │  │
2. Index lookup on friend_id ──┤            └────────┘  │
3. Join results              ──┤               │        │
4. Fetch friend data         ──┤            ┌──▼─────┐  │
                               │            │ Bob    │◄─┘
O(log N) per hop               │            │        │
                               │            └────────┘
                               │
For 6 degrees of separation:  │  O(1) per traversal hop
O(log N × 6) = O(log N)      │  O(6) = O(1)
                               │
                               │  For 6 hops: 6 pointer dereferences
Grafik Bölümleme
Dağıtılmış grafik veritabanları için bölümleme zordur:
| Strateji | Açıklama | Sorun |
|---|---|---|
| Kenar kesim | Tepe noktasına göre bölünmüş, kenarlar bölümleri çaprazlıyor | Birçok bölüm arası geçiş |
| Köşe kesimli | Kenara göre bölünmüş, köşe çoğaltılmış | Tutarlılık yükü |
| Karma bölümleme | Bölümlere hash köşeleri | Rastgele — zayıf konum |
| Aralık bölümleme | Özellik değerine göre bölümleme | Veriler tekdüze değilse eğrilme |
Gelişmiş Grafik Desenleri
Zamansal Grafikler (Zaman Yolculuğu Sorguları)
// Property graph with versioned edges
MATCH (employee:Employee {id: $empId})
      -[assignment:ASSIGNED_TO]->(project:Project)
WHERE assignment.from_date <= date("2026-01-15")
  AND (assignment.to_date IS NULL OR assignment.to_date >= date("2026-01-15"))
RETURN employee.name, project.name, assignment.role

// What was the org structure on Jan 1, 2025?
MATCH (manager:Employee)
      -[reports:MANAGES]->(report:Employee)
WHERE reports.effective_from <= date("2025-01-01")
  AND (reports.effective_to IS NULL OR reports.effective_to > date("2025-01-01"))
RETURN manager.name, collect(report.name) as reports
Grafik Algoritmaları (Neo4j GDS)
from neo4j import GraphDatabase
from graphdatascience import GraphDataScience

gds = GraphDataScience("bolt://localhost:7687", auth=("neo4j", "password"))

# Create in-memory graph
G, result = gds.graph.project(
    "myGraph",
    ["Person", "Company"],
    ["KNOWS", "WORKS_AT"]
)

# PageRank — find influential people
pagerank = gds.pageRank.stream(G)
influencers = pagerank.sort_values('score', ascending=False).head(10)

# Community detection (Louvain) — find clusters
communities = gds.louvain.stream(G)
Grafik + Vektör Arama (Karma)
Modern grafik veritabanları (Neo4j 5.x+) hem grafik hem de vektör aramasını destekler:
// Find similar products using vector embeddings,
// then traverse the recommendation graph
CALL db.index.vector.queryNodes(
  'product-embeddings',
  10,
  $query_embedding
) YIELD node AS similar_product, score

MATCH (similar_product)-[:ALSO_BOUGHT]->(recommended:Product)
WHERE recommended.rating > 4.0
RETURN recommended.name, recommended.price, score
ORDER BY score DESC, recommended.rating DESC
LIMIT 20
Grafik Veritabanı Anti-Desenleri
| Anti-Desen | Neden Acıyor | Daha İyi Yaklaşım |
|---|---|---|
| Küresel operasyonlar | MATCH (n) WHERE n.property tüm düğümleri tarar |
Dizin ekle: CREATE INDEX FOR (n:Label) ON (n.property) |
| Derin ve sınırsız geçişler | MATCH (a)-[*]->(b) sınırsız |
Derinliği belirtin: [*1..5] |
| Süper düğümler | Milyonlarca kenarı olan bir düğüm | Ara düğümlere girin, zaman sınırlarını kullanın |
| Eksik yön | Çift yönlü kenarlar çift geçişe neden olur | Net bir yön tanımlayın ve verimli bir şekilde hareket edin |
| Aşırı normalleştirme | Basit nitelikler için düğümler oluşturma | Bunun yerine düğüm özelliklerini kullanın |
Grafik Veritabanı Ne Zaman Kullanılmalı?
Grafiği Şu Durumlarda Kullanın:
- İlişkiler birinci sınıftır — bağlantılar verilerdir.
- Geçiş derinliği değişkendir — 2 atlamalı ve 6 atlamalı sorgular dinamik olarak değişir.
- Şema sık sık gelişir — anında yeni ilişki türleri eklenir.
- Desen eşleştirme sorgu kalıbıdır - "X'e benzeyen yolları bulun."
- Karmaşık birleştirme zincirleri — SQL'de 5'ten fazla JOIN, bir grafiğin daha iyi olabileceğini düşündürür.
Grafiği Şu Durumlarda Kullanmayın:
- Veriler tamamen tablo halindedir — satış kayıtları, işlem günlükleri.
- Toplam ağır iş yükleri — "bölgeye göre toplam gelir" (SQL/sütun deposu daha iyidir).
- Kimliğe göre basit CRUD — "kullanıcıyı e-postayla bul" (ilişkisel veritabanı uygundur).
- Yüksek hacimli nokta sorguları — saniyede milyonlarca basit arama.
Sonuç
Grafik veritabanları, ilişkilerin karmaşık, değişken ve etki alanı açısından merkezi olduğu durumlarda mükemmeldir. İlişkisel veritabanlarının yerini almazlar; belirli sorunlu alanlar için tamamlayıcı bir araçtırlar.
- Sosyal ve öneri sistemleri — Arkadaş-arkadaş grafiklerinde doğal bir şekilde gezinin.
- Sahtekarlık tespiti — Finansal ağlarda bariz olmayan bağlantıları bulun.
- Bilgi grafikleri — Farklı kaynaklardan gelen verileri birleşik bir modelde birleştirin.
- Tedarik zinciri ve lojistik — Karmaşık çok katmanlı ilişkileri modelleyin.
- Ağ ve BT operasyonları — bağımlılık grafikleri, temel neden analizi.
En iyi uygulama: Neo4j (en olgun ekosistem) ile başlayın, sorgular için Cypher'ı kullanın ve yapay zeka destekli grafik uygulamaları için vektör aramayla birleştirin. Geçiş derinliklerini sınırlı tutun, etiketli özellikleri indeksleyin ve süper düğüm büyümesini izleyin.
Öne Çıkan Makaleler
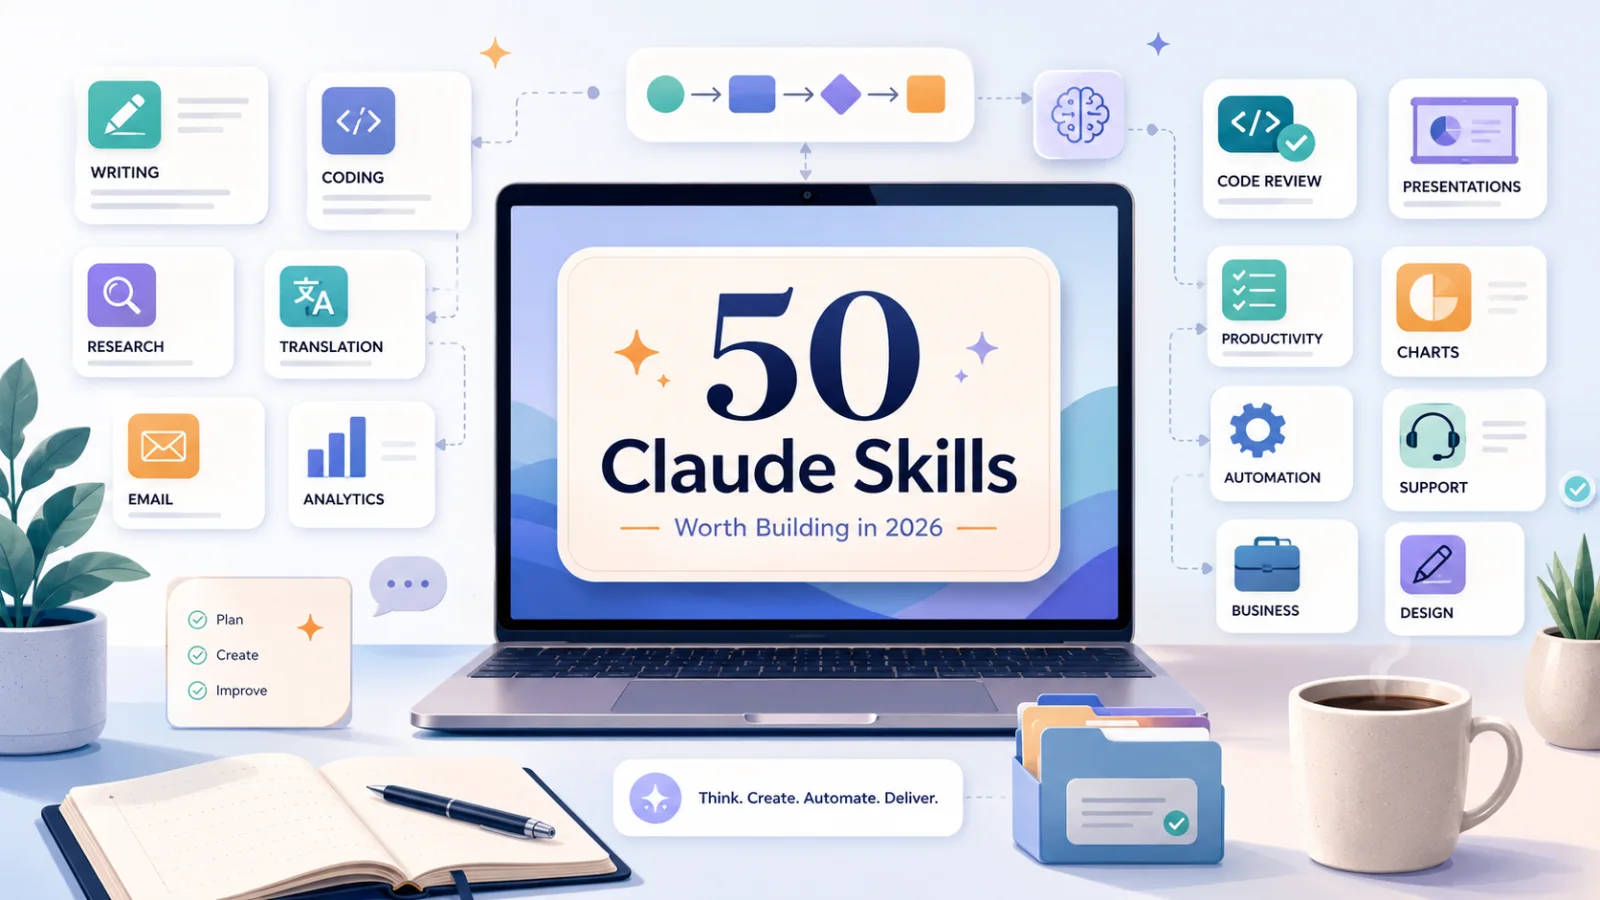
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
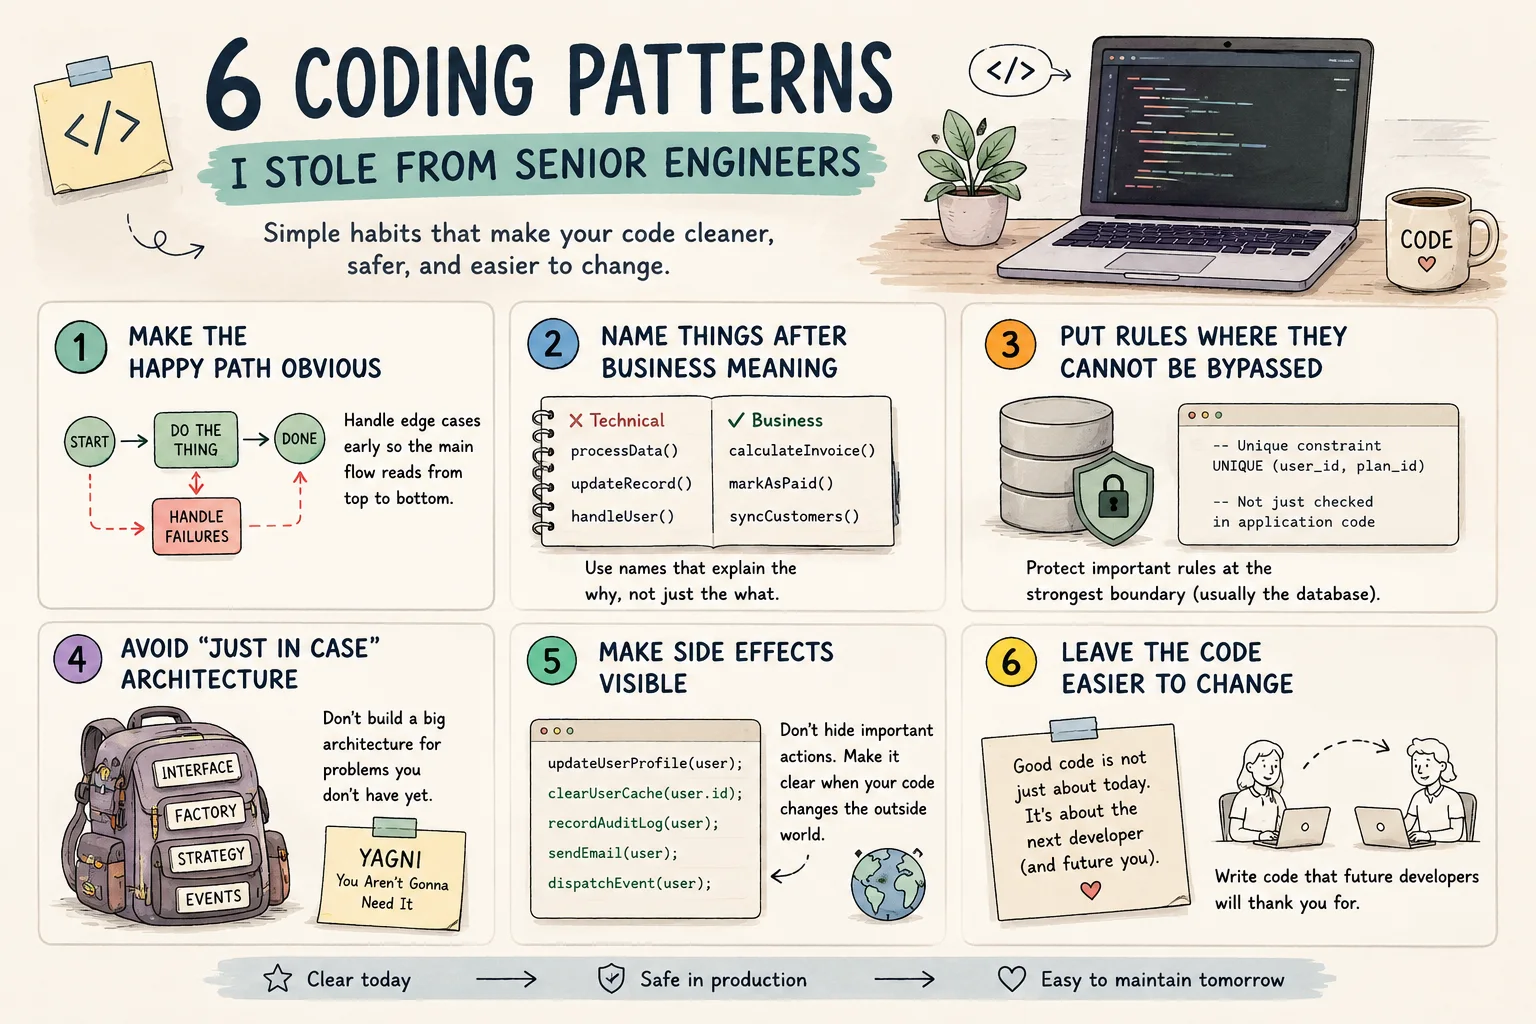
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.