Gömmeler ve Semantik Arama: Kelimelerden Anlamlara
Yerleştirmeler, yapay zeka destekli modern arama, öneri ve erişim sistemlerinin arkasındaki temel teknolojidir. Gömme, verinin (metin, resim, ses veya başka herhangi bir yöntem) anlamsal anlamını temsil eden yoğun bir sayısal vektördür. Benzer anlama sahip öğeler, yerleştirme alanında birbirine yakın vektörlere sahiptir.
Giriş
Yerleştirmeler, yapay zeka destekli modern arama, öneri ve erişim sistemlerinin arkasındaki temel teknolojidir. Gömme, verinin (metin, resim, ses veya başka herhangi bir yöntem) anlamsal anlamını temsil eden yoğun bir sayısal vektördür. Benzer anlama sahip öğeler, yerleştirme alanında birbirine yakın vektörlere sahiptir.
Bu makalede, yerleştirmelerin nasıl çalıştığı, bunların nasıl oluşturulacağı, anlamsal arama için nasıl kullanılacağı ve üretim dağıtımları için pratik hususlar açıklanmaktadır.
Gömmeler Nelerdir?
Temel Fikir
Kelimeler, cümleler veya belgeler yüksek boyutlu bir vektör uzayındaki noktalara eşlenir:
            ┌─────────────────────────────────┐
            │          Vector Space            │
            │           (768D)                 │
            │                                 │
            │   "king" ●                       │
            │              ● "queen"           │
            │                                 │
            │  "apple" ●                       │
            │              ● "orange"          │
            │                                 │
            │      "car" ●                     │
            │                    ● "bicycle"   │
            └─────────────────────────────────┘

Semantic relationships:
  king - man + woman ≈ queen
  Paris - France + Italy ≈ Rome
  walking - walk + run ≈ running
Gömmeler Neden Çalışıyor?
Yerleştirmeler dağıtım semantiğini, yani benzer bağlamlarda görünen kelimelerin benzer anlamlara sahip olduğu fikrini yakalar. Sinir ağları bu temsilleri bağlamdan sözcükleri tahmin ederek (Word2Vec, GloVe) veya maskelenmiş sözcükleri yeniden oluşturarak (BERT, GPT) öğrenir.
Gömme Modelleri
Metin Gömme Modelleri
| Modeli | Boyutlar | Bağlam Uzunluğu | Maliyet | Kalite |
|---|---|---|---|---|
| metin yerleştirme-3-küçük | 512-1536 | 8K jeton | 0,13 ABD doları/1 milyon jeton | Yüksek |
| metin yerleştirme-3-büyük | 256-3072 | 8K jeton | 0,13 ABD doları/1 milyon jeton | En yüksek |
| Cohere Embed v3 (İngilizce) | 1024 | 512 jeton | 0,10 ABD doları/1 milyon jeton | Yüksek |
| Cohere Embed v3 (Çok Dilli) | 1024 | 512 jeton | 0,10 ABD doları/1 milyon jeton | Yüksek (100+ dil) |
| BAAI/bge-large-en-v1.5 | 1024 | 512 jeton | Ücretsiz (kendi kendine barındırma) | Yüksek |
| cümle-transformatörler/tümü-MiniLM-L6-v2 | 384 | 256 jeton | Ücretsiz (kendi kendine barındırma) | Orta |
| intfloat/e5-mistral-7b-instruct | 4096 | 32 bin jeton | Ücretsiz (kendi kendine barındırma) | Çok Yüksek |
| Yolculuk-2 | 1024 | 4K jetonlar | 0,10 ABD doları/1 milyon jeton | Yüksek |
Çok Modlu Gömme Modelleri
| Modeli | Modaliteler | Boyutlar | Kullanım Örneği |
|---|---|---|---|
| KLİP (OpenAI) | Metin + Resim | 512 | Görsel arama, metinden görsele |
| Görüntü Bağlama (Meta) | Metin + Görüntü + Ses + Derinlik + Termal + IMU | 1024 | Evrensel çok modlu |
| Tutarlı Multimodal | Metin + Resim | 1024 | Ürün arama |
Gömme Modeli Seçme
# Decision framework for embedding model selection
def select_embedding_model(
    dataset_size: int,
    languages: list[str],
    latency_ms: int,
    accuracy_requirement: str,
    budget_per_month: float,
) -> str:
    if dataset_size < 100_000 and accuracy_requirement == "medium":
        return "all-MiniLM-L6-v2"  # Free, fast, good enough
    elif languages != ["en"] and budget_per_month > 100:
        return "text-embedding-3-large"  # Best multilingual, API
    elif latency_ms < 50:
        return "intfloat/e5-small-v2"  # Fast, self-hosted
    elif accuracy_requirement == "highest":
        return "text-embedding-3-large"  # Best quality
    else:
        return "BAAI/bge-large-en-v1.5"  # Open-source, high quality
Gömmeler Oluşturma
OpenAI Yerleştirme API'si
import openai

def embed_text(texts: list[str], model: str = "text-embedding-3-small",
               dimensions: int = 768) -> list[list[float]]:
    """Generate embeddings for a list of texts"""
    response = openai.embeddings.create(
        input=texts,
        model=model,
        dimensions=dimensions,
    )
    return [r.embedding for r in response.data]

# Example
texts = [
    "The quick brown fox jumps over the lazy dog",
    "A fast auburn canine leaps above the sleepy hound",
    "Python is a programming language",
]

embeddings = embed_text(texts, dimensions=256)

# Similarity: texts 0 and 1 should be close (similar meaning)
# texts 0 and 2 should be far (different meaning)
Cümle Transformatörleri (Kendi Kendine Barındırılan)
from sentence_transformers import SentenceTransformer
import numpy as np

# Load model (downloads on first use)
model = SentenceTransformer('all-MiniLM-L6-v2')

def embed_batch(texts: list[str], batch_size: int = 32) -> np.ndarray:
    """Generate embeddings with batching and normalization"""
    embeddings = model.encode(
        texts,
        batch_size=batch_size,
        show_progress_bar=True,
        normalize_embeddings=True,  # Cosine similarity = dot product
        convert_to_numpy=True,
    )
    return embeddings

# For very large datasets, process in chunks
def embed_large_collection(texts: list[str], output_path: str):
    n = len(texts)
    chunk_size = 10000
    all_embeddings = []

    for i in range(0, n, chunk_size):
        chunk = texts[i:i + chunk_size]
        chunk_embeddings = embed_batch(chunk)
        all_embeddings.append(chunk_embeddings)
        print(f"Processed {i + len(chunk)}/{n}")

    np.save(output_path, np.vstack(all_embeddings))
Semantik Arama Mimarisi
Temel Boru Hattı
                  ┌───────────────────────┐
                  │   Document Corpus      │
                  │      (N documents)     │
                  └──────────┬────────────┘
                             │ (embedding)
                             ▼
                  ┌───────────────────────┐
                  │   Index (ANN)         │
                  │   HNSW / IVF / PQ     │
                  └──────────┬────────────┘
                             │
User Query ─────────► Embed ──┤
                             │
                             ▼
                  ┌───────────────────────┐
                  │   Similarity Search   │
                  │   (K nearest vectors) │
                  └──────────┬────────────┘
                             │ (top K results)
                             ▼
                  ┌───────────────────────┐
                  │   Rerank (optional)   │
                  │   Cross-encoder       │
                  └──────────┬────────────┘
                             │
                             ▼
                        Final Results
FAISS (Facebook Yapay Zeka Benzerlik Araması) ile Uygulama
import faiss
import numpy as np

class SemanticSearch:
    def __init__(self, dimension: int = 384, index_type: str = "HNSW"):
        self.dimension = dimension
        self.index = self._build_index(index_type)
        self.documents = []
        self.embeddings = None

    def _build_index(self, index_type: str) -> faiss.Index:
        if index_type == "HNSW":
            index = faiss.IndexHNSWFlat(self.dimension, 32)  # 32 neighbors
            index.hnsw.efConstruction = 80  # Build quality vs speed
            return index
        elif index_type == "IVF":
            quantizer = faiss.IndexFlatIP(self.dimension)
            index = faiss.IndexIVFFlat(quantizer, self.dimension, 100)
            index.train(np.random.randn(10000, self.dimension).astype('float32'))
            return index
        elif index_type == "Flat":
            return faiss.IndexFlatIP(self.dimension)  # Exact search (slow)
        else:
            raise ValueError(f"Unknown index type: {index_type}")

    def add_documents(self, documents: list[str], embeddings: np.ndarray):
        """Add documents and their embeddings to the index"""
        assert len(documents) == len(embeddings)
        assert embeddings.shape[1] == self.dimension

        self.index.add(embeddings)
        self.documents.extend(documents)

    def search(self, query_vector: np.ndarray, k: int = 10,
               ef_search: int = 64) -> list[dict]:
        """Search for top K similar documents"""
        if hasattr(self.index, 'hnsw'):
            self.index.hnsw.efSearch = ef_search

        scores, indices = self.index.search(query_vector.reshape(1, -1), k)

        results = []
        for score, idx in zip(scores[0], indices[0]):
            if idx >= 0 and idx < len(self.documents):
                results.append({
                    'document': self.documents[idx],
                    'score': float(score),
                    'index': int(idx),
                })

        return sorted(results, key=lambda x: x['score'], reverse=True)

    def save(self, path: str):
        faiss.write_index(self.index, f"{path}.index")
        np.save(f"{path}_docs.npy", np.array(self.documents))

    @classmethod
    def load(cls, path: str, dimension: int):
        searcher = cls(dimension)
        searcher.index = faiss.read_index(f"{path}.index")
        searcher.documents = list(np.load(f"{path}_docs.npy"))
        return searcher
Benzerlik Metrikleri
| Metrik | Formül | Aralık | Ne Zaman Kullanılmalı |
|---|---|---|---|
| Kosinüs benzerliği | A·B / ( | A | |
| Nokta çarpım | A·B | [-d, d] | Gömmeler normalleştirildiğinde |
| Öklidyen (L2) | A - B | ||
| Manhattan (L1) | Σ | Aᵢ - Bᵢ |
Uygulamada Benzerliğin Ölçülmesi
import numpy as np
from sklearn.metrics.pairwise import cosine_similarity

# Normalize embeddings for cosine similarity (dot product == cosine)
def normalize(embeddings: np.ndarray) -> np.ndarray:
    norms = np.linalg.norm(embeddings, axis=1, keepdims=True)
    return embeddings / norms

# Compute similarity matrix
query = np.array([[0.1, 0.3, 0.5, 0.2]])  # Shape: (1, d)
corpus = np.array([
    [0.1, 0.3, 0.5, 0.2],  # Same → similarity = 1.0
    [0.9, 0.1, 0.2, 0.8],  # Different → similarity ≈ 0.5
    [0.5, 0.5, 0.5, 0.5],  # Random
])

query_norm = normalize(query)
corpus_norm = normalize(corpus)

similarities = cosine_similarity(query_norm, corpus_norm)
print(similarities)
# [[1.0, 0.48, 0.92]]
Üretimle İlgili Hususlar
Önbelleğe Alma Gömme
Gereksiz API çağrılarından ve maliyetlerden kaçının:
import hashlib
import json
import redis

class EmbeddingCache:
    def __init__(self, redis_url: str = "redis://localhost:6379"):
        self.redis = redis.from_url(redis_url)
        self.ttl = 86400 * 30  # 30 days

    def _key(self, text: str, model: str) -> str:
        hash_str = hashlib.sha256(text.encode()).hexdigest()
        return f"embedding:{model}:{hash_str}"

    def get(self, text: str, model: str) -> list[float] | None:
        cached = self.redis.get(self._key(text, model))
        return json.loads(cached) if cached else None

    def set(self, text: str, model: str, embedding: list[float]):
        self.redis.setex(
            self._key(text, model),
            self.ttl,
            json.dumps(embedding)
        )

    def get_or_embed(self, text: str, model: str, embed_fn) -> list[float]:
        cached = self.get(text, model)
        if cached:
            return cached
        embedding = embed_fn([text])[0]
        self.set(text, model, embedding)
        return embedding
Belge Arama için Parçalara Ayırma
Belgeler gömülmeden önce parçalara bölünmelidir:
from langchain.text_splitter import RecursiveCharacterTextSplitter

class DocumentChunker:
    def __init__(self, chunk_size: int = 500, chunk_overlap: int = 50):
        self.splitter = RecursiveCharacterTextSplitter(
            chunk_size=chunk_size,
            chunk_overlap=chunk_overlap,
            separators=["\n\n", "\n", ". ", " ", ""],
            length_function=len,
        )

    def chunk_document(self, text: str, metadata: dict) -> list[dict]:
        chunks = self.splitter.split_text(text)
        result = []

        for i, chunk in enumerate(chunks):
            result.append({
                'text': chunk,
                'metadata': {
                    **metadata,
                    'chunk_index': i,
                    'chunk_count': len(chunks),
                    'chunk_size': len(chunk),
                }
            })

        return result
Büyük Veri Kümeleri için Toplu İşleme
def process_and_index_large_dataset(
    documents: list[str],
    metadata_list: list[dict],
    qdrant_client,
    embedding_model,
    collection_name: str,
    batch_size: int = 500,
):
    """Process and index a large dataset in batches"""
    n = len(documents)

    for i in range(0, n, batch_size):
        batch_texts = documents[i:i + batch_size]
        batch_metadata = metadata_list[i:i + batch_size]

        # Generate embeddings
        embeddings = embedding_model.encode(batch_texts)

        # Prepare points for Qdrant
        points = []
        for idx, (text, meta, embedding) in enumerate(
            zip(batch_texts, batch_metadata, embeddings)
        ):
            points.append({
                'id': i + idx,
                'vector': embedding.tolist(),
                'payload': {'text': text, **meta},
            })

        # Upload to vector database
        qdrant_client.upsert(
            collection_name=collection_name,
            points=points,
        )

        print(f"Indexed batch {i // batch_size + 1}/{(n + batch_size - 1) // batch_size}")
İleri Teknikler
Sorgu Genişletme
Sorguları eşanlamlılarla genişleterek erişimi iyileştirin:
def expand_query(query: str, llm, n: int = 3) -> list[str]:
    """Generate multiple query variations for better recall"""
    prompt = f"""
    Generate {n} alternative versions of this search query.
    Use synonyms and rephrasing while preserving the core meaning.
    Return only the queries, one per line.

    Original: {query}
    """
    response = llm.invoke(prompt)
    variations = response.content.strip().split('\n')

    return [query] + [v.strip() for v in variations if v.strip()]

# Example
query = "cheap laptops for programming"
variations = expand_query(query, llm)
# Returns:
# - "cheap laptops for programming"
# - "affordable notebooks for coding"
# - "budget computers for software development"
# - "inexpensive laptops suitable for programmers"
Hibrit Arama (Vektör + Anahtar Kelime)
En iyi sonuçları elde etmek için anlamsal aramayı ve anahtar kelime aramasını birleştirin:
from rank_bm25 import BM25Okapi

class HybridSearch:
    def __init__(self, vector_weight: float = 0.7):
        self.vector_weight = vector_weight
        self.vector_index = None
        self.bm25_index = None
        self.documents = []

    def add_documents(self, documents: list[str], embeddings: np.ndarray):
        self.documents = documents
        self.vector_index = faiss.IndexFlatIP(embeddings.shape[1])
        self.vector_index.add(embeddings)

        tokenized = [doc.lower().split() for doc in documents]
        self.bm25_index = BM25Okapi(tokenized)

    def search(self, query: str, query_vector: np.ndarray, k: int = 10) -> list[dict]:
        # Vector search
        vec_scores, vec_indices = self.vector_index.search(
            query_vector.reshape(1, -1), k * 2
        )

        # BM25 search
        bm25_scores = self.bm25_index.get_scores(query.lower().split())
        bm25_top_k = np.argsort(bm25_scores)[::-1][:k * 2]

        # Combine scores
        combined = {}
        for idx, score in zip(vec_indices[0], vec_scores[0]):
            combined[int(idx)] = {
                'doc': self.documents[int(idx)],
                'score': score * self.vector_weight,
                'vector_score': score,
            }

        for idx in bm25_top_k:
            bm25_score = bm25_scores[idx] / max(bm25_scores)
            if idx in combined:
                combined[idx]['score'] += bm25_score * (1 - self.vector_weight)
                combined[idx]['bm25_score'] = bm25_score
            else:
                combined[idx] = {
                    'doc': self.documents[idx],
                    'score': bm25_score * (1 - self.vector_weight),
                    'bm25_score': bm25_score,
                }

        # Sort by combined score
        results = sorted(combined.values(), key=lambda x: x['score'], reverse=True)
        return results[:k]
Kalite Değerlendirmesinin Yerleştirilmesi
İçsel Değerlendirme
def evaluate_embeddings(embeddings, texts, query_queries,
                        relevant_docs_per_query):
    """MRR (Mean Reciprocal Rank) evaluation"""
    from sklearn.metrics.pairwise import cosine_similarity

    total_reciprocal_rank = 0

    for i, query in enumerate(query_queries):
        # Get query embedding
        query_emb = embeddings[texts.index(query)].reshape(1, -1)

        # Compute similarities
        similarities = cosine_similarity(query_emb, embeddings)[0]

        # Rank documents
        ranked = np.argsort(similarities)[::-1]

        # Find rank of first relevant document
        relevant = set(relevant_docs_per_query[i])
        for rank, idx in enumerate(ranked, 1):
            if idx in relevant:
                total_reciprocal_rank += 1.0 / rank
                break

    mrr = total_reciprocal_rank / len(query_queries)
    return mrr
Pratik Kalite Kontrol Listesi
- [ ] Similar documents produce similar embeddings (cosine > 0.8)
- [ ] Unrelated documents produce distinct embeddings (cosine < 0.3)
- [ ] Synonym queries return similar results ("car" ≈ "automobile")
- [ ] Misspellings handled gracefully ("teh" ≈ "the")
- [ ] Word order matters ("dog bites man" ≠ "man bites dog")
- [ ] Negation captured ("not interesting" ≠ "interesting")
- [ ] Domain-specific terms work (medical, legal, technical jargon)
Sonuç
Yerleştirmeler yapay zeka sistemlerinde anlamsal anlayışın temelidir:
- Gömmeleri, anahtar kelimelere göre değil, anlama göre arama yapmanız gerektiğinde kullanın.
- Doğru modeli seçin — Kalite için OpenAI, maliyet/uyumluluk için cümle dönüştürücüler.
- Tutarlı kosinüs benzerliği için yerleştirmeleri normalleştirin.
- Yeniden hesaplamayı önlemek için önbelleğe yerleştirmeler.
- Karma arama (vektör + anahtar kelime) her ikisinden de daha iyi performans gösterir.
- Niceliksel olarak değerlendirin — MRR'yi ölçün, özel veri kümenizde geri çağırın@K.
Yerleştirmeler, yalnızca metni değil anlamı da anlayan anlamsal arama, RAG, öneri, kümeleme ve anormallik algılama gibi yeni bir uygulama sınıfına olanak tanır.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
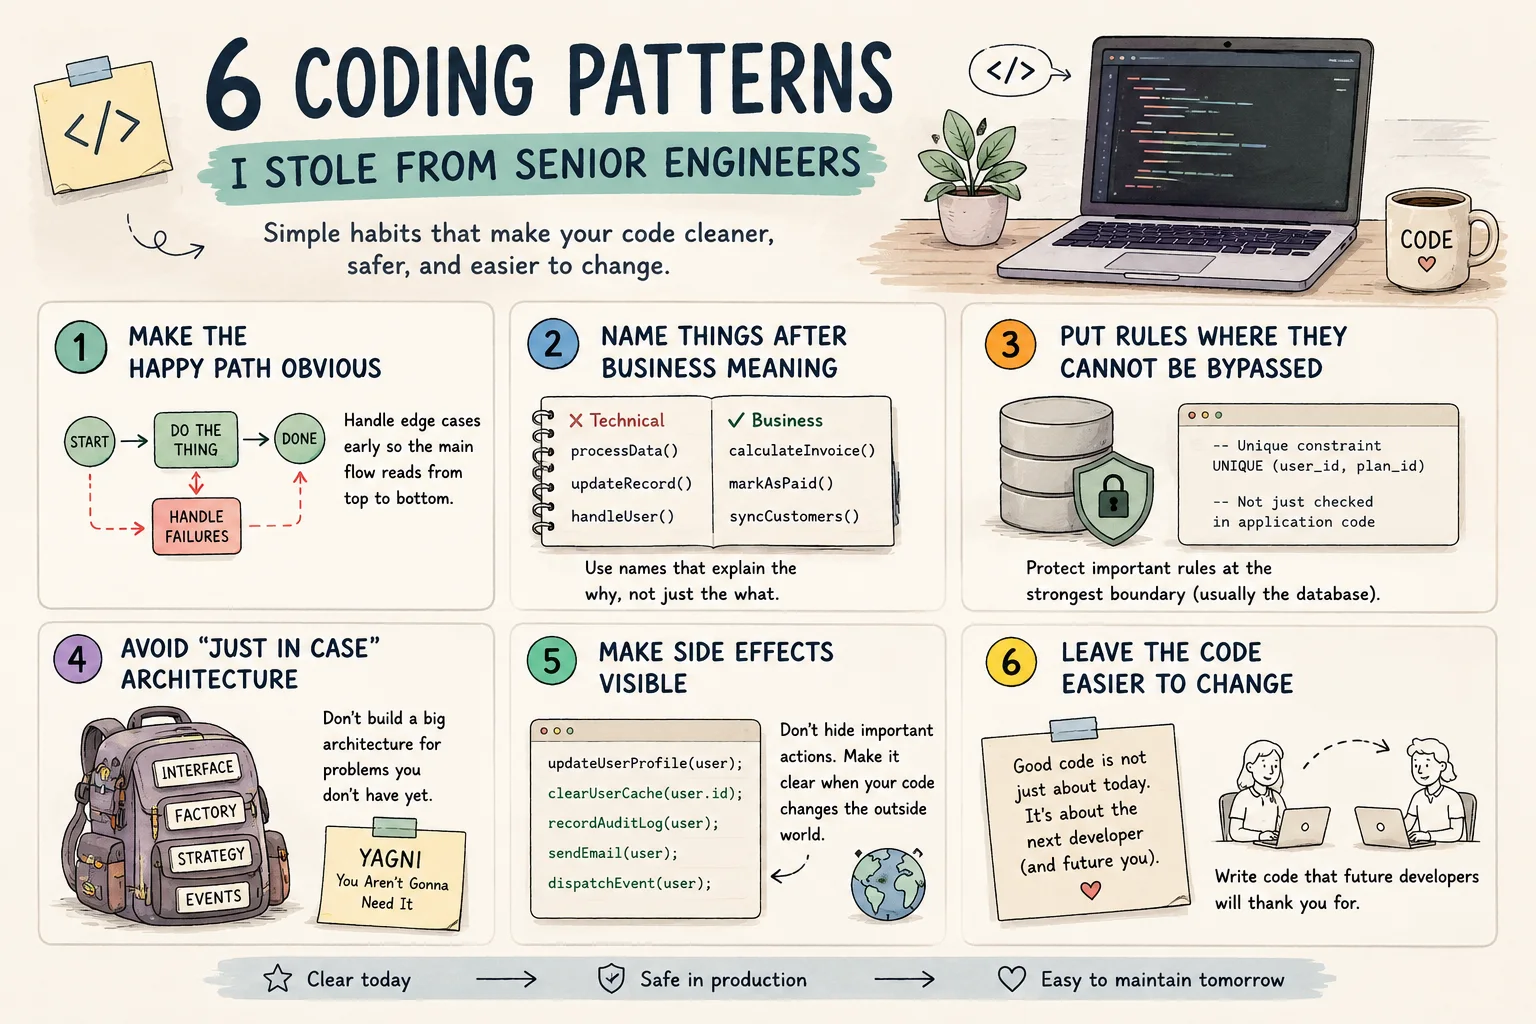
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.