Dağıtılmış SQL ve NewSQL: Yeni Nesil Veritabanları
Onlarca yıldır veritabanı dünyası iki kampa bölünmüştü: güçlü tutarlılığa sahip ancak sınırlı ölçeklenebilirliğe sahip **ilişkisel veritabanları** (PostgreSQL, MySQL) ve yatay ölçeklenebilirliğe ancak daha zayıf tutarlılığa ve sınırlı sorgu yeteneklerine sahip **NoSQL veritabanları** (MongoDB, Cassandra).
Giriş
Onlarca yıldır veritabanı dünyası iki kampa bölünmüştü: güçlü tutarlılığa sahip ancak sınırlı ölçeklenebilirliğe sahip ilişkisel veritabanları (PostgreSQL, MySQL) ve yatay ölçeklenebilirliğe ancak daha zayıf tutarlılığa ve sınırlı sorgu yeteneklerine sahip NoSQL veritabanları (MongoDB, Cassandra).
Dağıtılmış SQL (NewSQL olarak da bilinir) bu boşluğu doldurur. Yatay olarak ölçeklenebilir, dağıtılmış bir mimaride SQL'in (ACID işlemleri, birleştirmeler, yabancı anahtarlar ve tanıdık araçlar) tüm gücünü sağlar. Sonuç: ilişkisel bir veritabanının tutarlılığı ve sorgulama gücü ile NoSQL'in ölçeklenebilirliği.
Veritabanı Spektrumu
Strong Consistency
        ▲
        │           ┌───────────────────────┐
        │           │  Distributed SQL      │
        │           │  (CockroachDB,        │
        │           │   YugabyteDB,         │
        │           │   Google Spanner)     │
        │           └───────────────────────┘
        │
        │    ┌──────────────┐     ┌──────────────────┐
        │    │  Traditional │     │  Traditional      │
        │    │  SQL         │     │  NewSQL           │
        │    │  (PostgreSQL,│     │  (Vitess, TiDB)   │
        │    │   MySQL)     │     │                   │
        │    └──────────────┘     └──────────────────┘
        │
        │                              ┌──────────────────┐
        │                              │  NoSQL           │
        │                              │  (Cassandra,     │
        │                              │   DynamoDB,      │
        │                              │   CosmosDB)      │
        │                              └──────────────────┘
        └────────────────────────────────────────────────────
                              Horizontal Scalability  ──────►
Dağıtılmış SQL Nedir?
Temel Özellikler
| Özellik | Açıklama |
|---|---|
| SQL arayüzü | Tam SQL desteği: JOIN'ler, alt sorgular, toplamalar, pencere işlevleri |
| ASİT işlemleri | Düğümler arasında Serileştirilebilir veya Anlık Görüntü Yalıtımı |
| Yatay ölçeklendirme | Kesinti süresi olmadan düğüm ekleyin, veriler otomatik olarak yeniden dengelenir |
| Otomatik parçalama | Veriler düğümler arasında otomatik olarak dağıtılır |
| Çoğaltma | Dayanıklılık için eşzamanlı çoğaltma (RPO=0) |
| Yüksek kullanılabilirlik | Otomatik yük devretme, manuel müdahale yok |
| Coğrafi dağıtım | Veriler, gecikme süresi < 50 ms olan birden fazla bölgeye yayılabilir |
Dağıtılmış SQL Mimarileri
Google Spanner — Öncü
┌──────────────────────────────────────────┐
│         Spanner Global Architecture       │
├──────────────────────────────────────────┤
│  Zone 1 (us-east1)   Zone 2 (europe-west)│
│  ┌──────────────┐    ┌──────────────┐    │
│  │ Leader Node  │    │ Follower Node│    │
│  │   ┌────────┐ │    │              │    │
│  │   │ Spanner│ │    │              │    │
│  │   │ Server │ │    │              │    │
│  │   └────────┘ │    │              │    │
│  └──────────────┘    └──────────────┘    │
├──────────────────────────────────────────┤
│          TrueTime API (GPS + Atomic)     │
│          Clock synchronization < 7ms     │
└──────────────────────────────────────────┘
Önemli yenilik: TrueTime API — Sınırlı saat belirsizliği sağlayan GPS ve atom saati senkronizasyonu. Bu, küresel olarak dağıtılmış düğümler arasında harici tutarlılığa (doğrusallaştırılabilirlik) olanak tanır.
CockroachDB — Spanner'dan Esinlenen Açık Kaynak
                     ┌─────────────────────────┐
                     │    SQL Gateway          │
                     │  (Any node can serve)   │
                     └──────────┬──────────────┘
                                │
         ┌──────────────────────┼──────────────────────┐
         │                      │                      │
   ┌─────▼─────┐          ┌─────▼─────┐          ┌─────▼─────┐
   │  Node 1   │          │  Node 2   │          │  Node 3   │
   │ ┌───────┐ │          │ ┌───────┐ │          │ ┌───────┐ │
   │ │ Range A│ │          │ │ Range A│ │          │ │ Range A│ │
   │ │ (LEADER)│          │ │(FOLLOWER│          │ │(FOLLOWER│ │
   │ └───────┘ │          │ └───────┘ │          │ └───────┘ │
   │ ┌───────┐ │          │ ┌───────┐ │          │ ┌───────┐ │
   │ │ Range B│ │          │ │ Range B│ │          │ │ Range B│ │
   │ │(FOLLOWER│          │ │ (LEADER)│          │ │(FOLLOWER│ │
   │ └───────┘ │          │ └───────┘ │          │ └───────┘ │
   └───────────┘          └───────────┘          └───────────┘
CockroachDB nasıl çalışır:
- Veriler aralıklara bölünmüştür (Spanner'ın bölmelerine benzer şekilde varsayılan olarak 64 MB).
- Her aralık, düğümler arasında 3 kat (yapılandırılabilir) çoğaltılır.
- Bir kopya kira sahibi'dir (okuma ve yazma işlemlerini yönetir).
- Raft fikir birliği kopyalar arasında tutarlılık sağlar.
- Herhangi bir düğüm sorguları sunabilir; SQL ağ geçidi doğru aralığa yönlendirir.
YugabyteDB — PostgreSQL Uyumlu
YugabyteDB, kablolu protokol düzeyinde PostgreSQL uyumluluğu için tasarlanmıştır:
-- This is standard PostgreSQL syntax — it just works
CREATE TABLE orders (
    id UUID DEFAULT gen_random_uuid(),
    customer_id UUID NOT NULL,
    total NUMERIC(10,2) NOT NULL,
    status TEXT NOT NULL DEFAULT 'pending',
    created_at TIMESTAMPTZ DEFAULT NOW(),
    PRIMARY KEY (id)
);

-- Distributed ACID transaction across nodes
BEGIN;
INSERT INTO orders (customer_id, total, status)
VALUES ($1, $2, 'pending');
UPDATE inventory SET quantity = quantity - 1
WHERE product_id = $3 AND quantity > 0;
COMMIT;

-- Full PostgreSQL ecosystem compatibility
-- Supports: pgAdmin, Prisma, DBeaver, all standard drivers
Dağıtılmış SQL Karşılaştırması
| Özellik | HamamböceğiDB | YugabyteDB | TiDB | Google Anahtarı |
|---|---|---|---|---|
| Uyumluluk | PostgreSQL (%85) | PostgreSQL (%95+) | MySQL | Tescilli |
| Tutarlılık | Serileştirilebilir | Serileştirilebilir | Anlık görüntü izolasyonu | Dış tutarlılık |
| Çoğaltma | Sal | Sal | Sal | Paxos |
| Coğrafi dağıtım | Evet | Evet | Evet | Evet |
| Otomatik parçalama | Evet (aralığa göre) | Evet (karma/aralığa göre) | Evet (aralığa göre) | Evet (bölünerek) |
| İkincil dizinler | Küresel (dağıtılmış) | Küresel + Yerel | Küresel + Yerel | Küresel |
| Yabancı anahtarlar | Evet | Evet | Evet | Evet |
| CDC | Evet (Kafka lavabo) | Evet (Kafka, Elastik) | Evet (TiCDC) | Evet (Pub/Sub) |
| Lisanslama | BSL (kaynak mevcut) | Apaçi 2.0 | Apaçi 2.0 | Tescilli |
| Bulut tarafından yönetildi | HamamböceğiDB Bulutu | YugabyteDB Yönetilen | TiDB Bulutu | Bulut Anahtarı |
| Kendi kendine barındırıcı | Evet | Evet | Evet | Hayır |
Dağıtılmış SQL Ne Zaman Kullanılmalı?
İdeal Kullanım Durumları
| Kullanım Örneği | Neden Dağıtılmış SQL | Örnek |
|---|---|---|
| Global SaaS uygulamaları | Dünya çapındaki kullanıcılar düşük gecikme süresine ve güçlü tutarlılığa ihtiyaç duyuyor | Çok bölgeli kullanıcı hesapları |
| Finansal sistemler | Parçalar arasında ACID işlemleri, veri kaybı yok | Ödeme işleme, defter |
| E-ticaret platformları | Envanter, siparişler, alışveriş sepetleri; hepsi tutarlılığa ihtiyaç duyar | Kara Cuma trafiğinde artış |
| Oyun | Oyuncu durumu, skor tabloları, işlemler | Bölgeler arası çok oyunculu |
| IoT zaman serisi + meta veriler | Dağıtılmış veriler üzerinde analiz için SQL | Birleşimlerle filo telemetrisi |
Dağıtılmış SQL Ne Zaman Kullanılmamalı?
| Senaryo | neden | Daha İyi Alternatif |
|---|---|---|
| Basit anahtar/değer aramaları | Dağıtılmış işlemlerin ek yükü haklı gösterilmiyor | Redis, DynamoDB |
| Tek bölge, küçük veriler | Karmaşıklığa gerek yok | PostgreSQL |
| Tam metin araması | Metin indeksleme için tasarlanmamıştır | Elasticsearch |
| Grafik geçişleri | Derin ilişkilerdeki JOIN'ler yavaştır | Neo4j |
| Çok yüksek yazma verimi (>100.000 yazma/sn/düğüm) | Konsensus yükü çok yüksek olabilir | Cassandra, ScyllaDB |
Veri Dağıtım Stratejileri
Menzil Tabanlı Parçalama (CockroachDB, Spanner)
-- Data is split by primary key ranges
Table: orders

Range 1: PK '00000000' to '3fffffff'  → Node 1 (LEADER) + Node 2, Node 3
Range 2: PK '40000000' to '7fffffff'  → Node 2 (LEADER) + Node 1, Node 3
Range 3: PK '80000000' to 'bfffffff'  → Node 3 (LEADER) + Node 1, Node 2
Range 4: PK 'c0000000' to 'ffffffff'  → Node 1 (LEADER) + Node 2, Node 3
Avantajları: Verimli aralık taramaları, sıralı tuşlar için iyidir. Eksileri: Sıralı anahtarlar ekleniyorsa sıcak noktaları yazın (karma parçalı dizinlerle çözülür).
Karma Tabanlı Parçalama (YugabyteDB)
-- Hash-sharded primary key
CREATE TABLE orders (
    id UUID DEFAULT gen_random_uuid(),
    customer_id UUID,
    total NUMERIC,
    PRIMARY KEY (id HASH)
);

-- Data distribution by hash
Hash('00000000-...') = 0.23 → Tablet 1 → Node 1
Hash('11111111-...') = 0.67 → Tablet 2 → Node 2
Hash('22222222-...') = 0.12 → Tablet 3 → Node 3
Avantajları: Eşit veri dağıtımı, sıcak nokta yok. Eksileri: Tablonun tamamındaki aralık taramaları verimsizdir.
Temel Dağıtılmış SQL Özellikleri
Dağıtılmış İşlemler (2PC + Raft)
-- This transaction spans multiple nodes
BEGIN;
UPDATE account_a SET balance = balance - 100 WHERE id = 'A';
UPDATE account_b SET balance = balance + 100 WHERE id = 'B';  -- Different node
COMMIT;

-- Under the hood:
-- 1. Transaction coordinator (any node) acquires locks
-- 2. Prepares both participants
-- 3. Raft commits the transaction record
-- 4. COMMIT acknowledged to client
-- All-or-nothing — guaranteed ACID
Küresel İkincil Endeksler
Dizinlerin kendileri düğümler arasında dağıtılır:
CREATE INDEX idx_orders_customer ON orders (customer_id);

-- Query that uses the distributed index:
SELECT * FROM orders WHERE customer_id = $1;
-- 1. Routes to any node
-- 2. Node looks up customer_id in distributed index
-- 3. Index returns primary keys → fetch from correct ranges
-- 4. Returns results
Çevrimiçi Şema Taşımaları
Dağıtılmış SQL, kesinti olmadan şema değişikliklerini destekler:
-- Add a column — non-blocking
ALTER TABLE orders ADD COLUMN discount NUMERIC(5,2) DEFAULT 0.00;

-- Create index — non-blocking (background build)
CREATE INDEX CONCURRENTLY idx_orders_date ON orders (created_at);
Veri Yakalamayı Değiştir (CDC)
Veritabanı değişikliklerini aşağı akış sistemlerine aktarın:
-- CockroachDB CDC
CREATE CHANGEFEED FOR TABLE orders, payments
  INTO 'kafka://kafka-cluster:9092'
  WITH updated, resolved, min_checkpoint_frequency = '5s';

-- YugabyteDB CDC connector
# Deploy to Kafka Connect
{
  "name": "yb-cdc-connector",
  "config": {
    "connector.class": "io.yugabyte.cdc.YBChangeDataCaptureConnector",
    "database.hostname": "yb-1.example.com",
    "database.port": "5433",
    "table.include.list": "public.orders"
  }
}
Operasyonel Hususlar
Dağıtım Topolojileri
Tek bölge (3 düğüm):
replication:
  factor: 3
  constraints:
    - "+region=us-east-1: 3"
  # All data in one region, 3 copies, survives 2 node failures
Çoklu bölge (bölge arızasından kurtulma):
replication:
  factor: 3
  constraints:
    - "+region=us-east-1: 1"
    - "+region=us-west-1: 1"
    - "+region=eu-west-1: 1"
  # One copy in each region, survives any single region failure
  # Write latency: round-trip to the farthest region
Yakın çoğunluklu çoklu bölge (düşük gecikmeli yazmalar için):
replication:
  factor: 5
  constraints:
    - "+region=us-east-1: 3"  # 3 copies here
    - "+region=us-west-1: 1"  # 1 copy for DR
    - "+region=eu-west-1: 1"  # 1 copy for DR
  # Write quorum = 3, achievable within us-east-1
  # Write latency = intra-region
Gecikme Beklentileri
| Topoloji | Yazma Gecikmesi (p50) | Okuma Gecikmesi (p50) |
|---|---|---|
| Tek düğüm | 1-5ms | 0,5-2ms |
| 3 düğüm, aynı bölge | 5-15ms | 1-5ms |
| 3 düğüm, 3 bölge (ABD, AB, APAC) | 100-300ms | 5-50ms (en yakın) |
| 5 düğüm, 2 bölge (yakın çoğunluk) | 5-15ms | 1-5ms |
PostgreSQL/MySQL'den geçiş
Strateji: NoSQL'den (Dağıtılmış)SQL'e
Phase 1: Evaluate
  - Identify tables that need horizontal scaling
  - Assess which queries cross shards
  - Plan sharding key

Phase 2: Migrate schema
  - Convert CREATE TABLE statements
  - Choose primary key strategy (hash vs. range)
  - Handle sequences (use UUIDs instead of SERIAL)

Phase 3: Migrate data
  - Use CDC or batch export/import
  - Verify consistency
  - Set up replication from old DB

Phase 4: Cut over
  - Point application to new DB
  - Monitor performance
  - Keep old DB as rollback target for 1 week
Yaygın Geçiş Sorunları
-- PostgreSQL → CockroachDB
-- ❌ Sequences (not distributed)
SERIAL PRIMARY KEY  →  UUID DEFAULT gen_random_uuid()

-- ❌ Array functions not supported
array_agg(DISTINCT x)  →  json_agg(DISTINCT x)  -- workaround

-- ❌ Long-running queries
-- Solution: add index or query hint

-- ❌ Cross-database queries (CockroachDB)
-- Each cluster = one database, no cross-DB queries
Sonuç
Dağıtılmış SQL, yirmi yıllık veritabanı evriminin birleşimini temsil eder; SQL'in güvenilirliğini ve ifade gücünü, dağıtılmış sistemlerin esnekliği ve esnekliği ile birleştirir.
Temel Çıkarımlar
- **SQL semantiğine ihtiyaç duyduğunuzda ancak tek bir düğümü aştığınızda Dağıtılmış SQL'i kullanın.
- Küçük dağıtımlar için değildir — Okuma replikalarına sahip PostgreSQL daha basit ve daha ucuzdur.
- Uyumluluğa göre seçim yapın — PostgreSQL için YugabyteDB, MySQL için TiDB, yeni projeler için CockroachDB.
- Gecikme planı — dağıtılmış işlemlerin ek yükü vardır. Taahhüt etmeden önce kıyaslama yapın.
- Dikkatlice izleyin; yoğun aralıkları, yavaş sorguları ve çoğaltma gecikmelerini izleyin.
Karar Çerçevesi
Q: Do you need horizontal write scaling?
  ├─ Yes
  │  Q: Do you need ACID across all data?
  │  ├─ Yes → Distributed SQL (CockroachDB, Spanner)
  │  └─ No  → NoSQL (Cassandra, DynamoDB)
  └─ No
     Q: Do you need SQL features (joins, aggregations)?
     ├─ Yes → PostgreSQL
     └─ No  → Key-value or document store
Dağıtılmış SQL, küresel, bulut tabanlı çağın veritabanı mimarisidir; uygulamalar her yerde, güçlü bir tutarlılıkla ve ödün vermeden çalışması gerekir.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
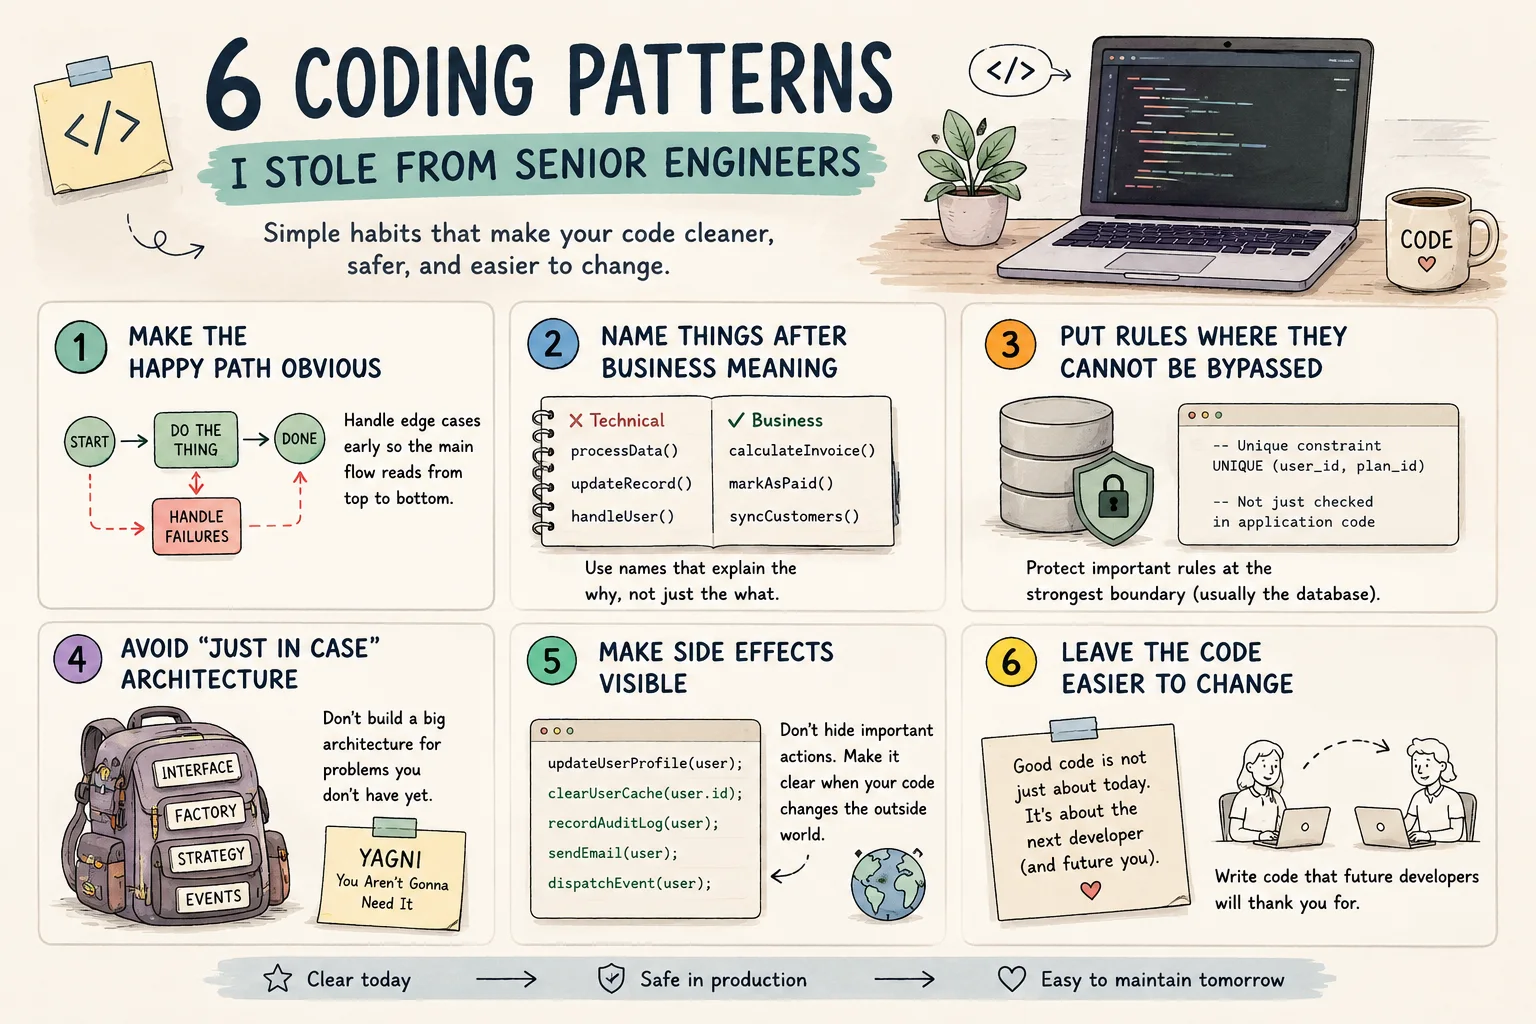
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.