Veri Mühendisliği ve Büyük Veri
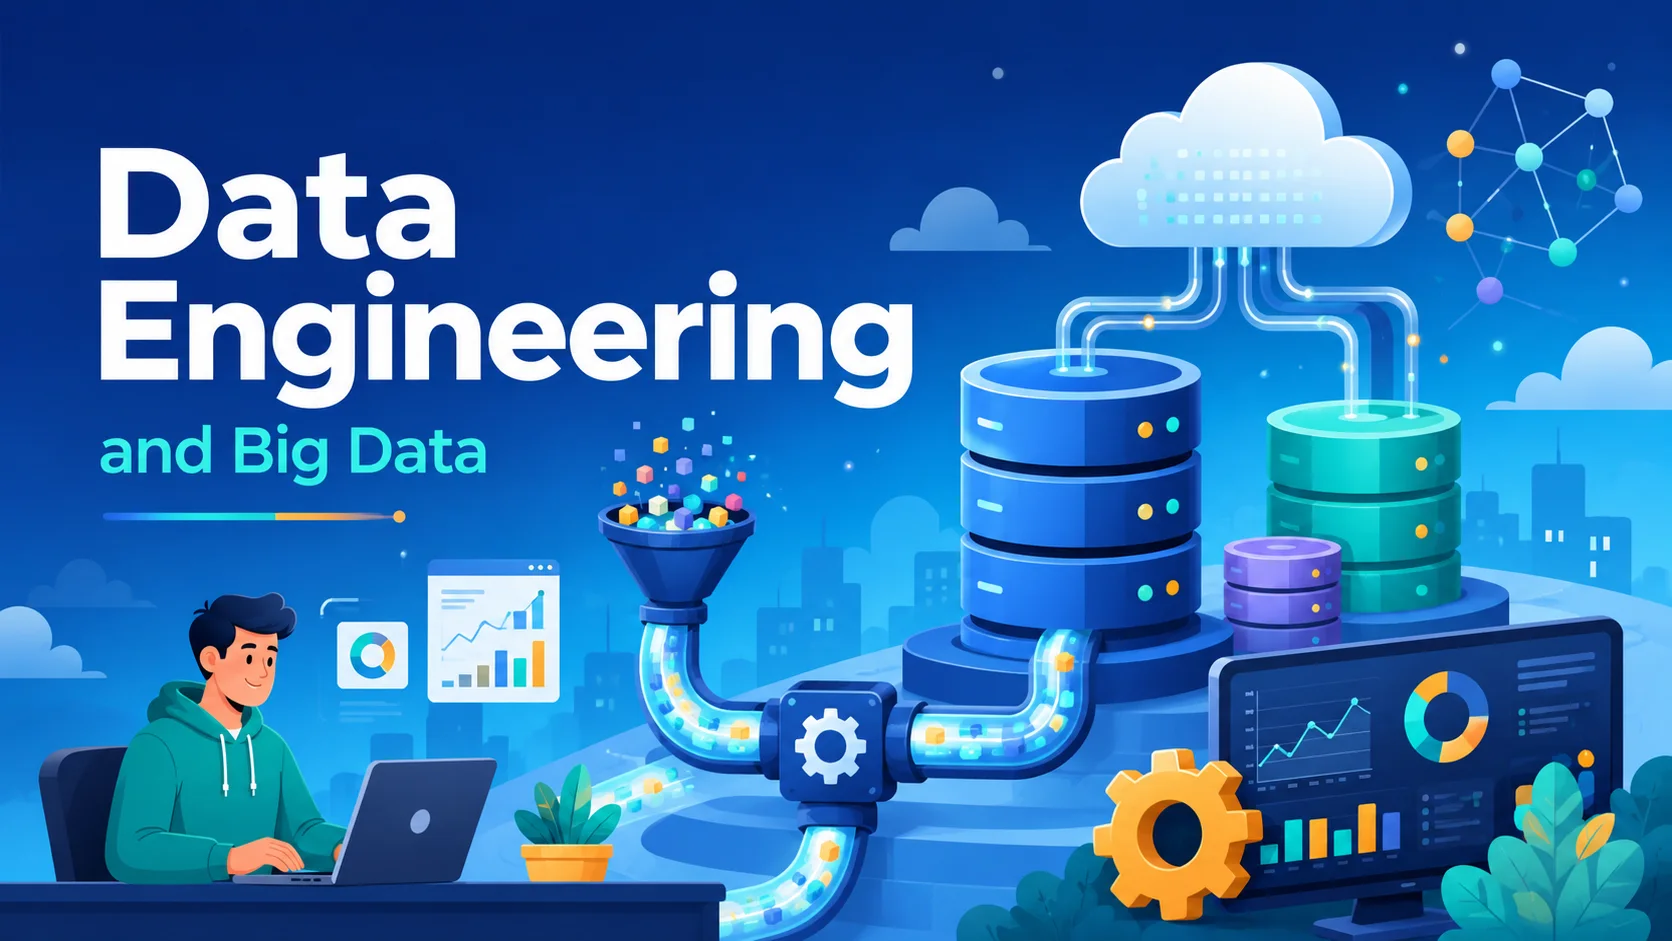
Veri mühendisliği, verileri uygun ölçekte toplayan, saklayan, işleyen ve analiz eden sistemleri tasarlama, oluşturma ve sürdürme uygulamasıdır. Veri bilimcileri içgörü elde etmeye odaklanırken veri mühendisleri bu içgörüleri mümkün kılan güvenilir, ölçeklenebilir altyapıyı oluşturur.
Giriş
Veri mühendisliği, verileri uygun ölçekte toplayan, saklayan, işleyen ve analiz eden sistemleri tasarlama, oluşturma ve sürdürme uygulamasıdır. Veri bilimcileri içgörü elde etmeye odaklanırken veri mühendisleri bu içgörüleri mümkün kılan güvenilir, ölçeklenebilir altyapıyı oluşturur.
2026'da veri mühendisleri veri odaklı kuruluşların omurgasını oluşturacak. Makine öğrenimi modellerine, iş zekası kontrol panellerine, gerçek zamanlı analizlere ve operasyonel raporlamaya güç veren boru hatlarını oluştururlar.
Veri Mühendisliği Boru Hattı
Uçtan Uca Mimari
┌─────────┐   ┌──────────┐   ┌──────────┐   ┌─────────────┐   ┌─────────┐
│  Data   │   │  Data    │   │  Data    │   │  Data       │   │  Data   │
│ Sources │──▶│ Ingest   │──▶│ Storage  │──▶│ Transform   │──▶│ Serving │
├─────────┤   ├──────────┤   ├──────────┤   ├─────────────┤   ├─────────┤
│ Apps    │   │ Kafka    │   │ Data Lake│   │ dbt, Spark  │   │ BI      │
│ DBs     │   │ Kinesis  │   │ Warehouse│   │ Airflow     │   │ ML      │
│ APIs    │   │ Airbyte  │   │ Lakehouse│   │ Flink       │   │ Reverse │
│ Logs    │   │ Fivetran │   │          │   │             │   │ ETL     │
│ IoT     │   │ Pub/Sub  │   │          │   │             │   │ API     │
└─────────┘   └──────────┘   └──────────┘   └─────────────┘   └─────────┘
1. Veri Kullanımı
Toplu Besleme
Verileri bir programa göre yükleyin (saatlik, günlük):
# Airflow DAG — Daily ETL
dag_id: daily_orders_import
schedule: "0 2 * * *"  # Daily at 2 AM
tasks:
  - extract_from_postgres:
      sql: >
        COPY orders TO '/tmp/orders_export.csv'
        WITH (FORMAT CSV, HEADER true)
        WHERE created_at >= CURRENT_DATE - 1

  - load_to_s3:
      source: /tmp/orders_export.csv
      destination: s3://data-lake/raw/orders/{{ ds }}/

  - load_to_snowflake:
      table: staging.orders
      file: s3://data-lake/raw/orders/{{ ds }}/*
      warehouse: etl_wh
Akış Beslemesi
Verileri gerçek zamanlı olarak işleyin:
# Kafka producer — Sending order events
from kafka import KafkaProducer
import json

producer = KafkaProducer(
    bootstrap_servers=['kafka:9092'],
    value_serializer=lambda v: json.dumps(v).encode('utf-8'),
    acks='all'
)

def on_order_placed(order):
    future = producer.send('orders', order)
    future.get(timeout=10)  # Wait for acknowledgment
    print(f"Order {order['id']} sent")
# Kafka consumer — Processing stream
from kafka import KafkaConsumer

consumer = KafkaConsumer(
    'orders',
    bootstrap_servers=['kafka:9092'],
    group_id='order-processors',
    auto_offset_reset='earliest',
    enable_auto_commit=False
)

for message in consumer:
    order = json.loads(message.value)
    process_order(order)
    consumer.commit()  # Manual commit for reliability
Besleme Araçları
| Araç | Tür | En İyisi |
|---|---|---|
| Apache Kafka | Akış | Yüksek verimli, olay akışı |
| Apache Airbyte | ELT | Açık kaynaklı, 200'den fazla bağlayıcı |
| Fivetran | SaaS ELT | Yönetilen, sıfır bakım gerektiren konnektörler |
| AWS Kinesis | Akış | AWS ekosistemi |
| Google Pub/Sub | Akış | GCP ekosistemi |
| Azure Etkinlik Merkezleri | Akış | Azure ekosistemi |
| Dikiş | SaaS ELT | Basit, küçük ila orta veri hacimleri |
| Debezyum | CDC | Veritabanı değişikliği veri yakalama |
2. Veri Depolama
Depolama Sistemleri Karşılaştırması
| Sistem | En İyisi | Sorgu Türü | Şema | Ölçeklendirme |
|---|---|---|---|---|
| Veri Gölü (S3, ADLS, GCS) | Ham veriler, herhangi bir formatta | Dosya düzeyinde | Okuma sırasında şema | Sonsuz |
| Veri Ambarı (Snowflake, BigQuery, Redshift) | Yapılandırılmış analitik | SQL | Yazma şeması | elastik |
| Göl Evi (Databricks, Buzdağı) | Makine Öğrenmesi + BI | SQL + Spark | Şema gelişimi | elastik |
| NoSQL (DynamoDB, MongoDB, Cassandra) | Düşük gecikme süresi, yarı yapılandırılmış | Anahtar/değer çifti, belge | Esnek | Yatay |
Doğru Depolamayı Seçmek
data_storage_strategy:
  # Raw data — never transformed
  raw_layer: s3://data-lake/raw/  (Parquet format)

  # Cleaned and validated data
  staging_layer: s3://data-lake/staging/  (Delta Lake)

  # Business-ready, modeled data
  curated_layer: snowflake.prod.*

  # Real-time operational data
  operational: dynamodb-transactions

  # ML features
  feature_store: feast-feature-store

  # Data sharing
  analytics: looker-explores
Modern Veri Yığını
┌─────────────────────────────────────────────┐
│              Data Sources                    │
│  Postgres  │  Shopify  │  Stripe  │  GA4    │
└──────┬──────────┬──────────┬────────┬───────┘
       │          │          │        │
       ▼          ▼          ▼        ▼
┌─────────────────────────────────────────────┐
│           Ingestion (Fivetran / Airbyte)     │
├─────────────────────────────────────────────┤
│         Storage (Snowflake / BigQuery)       │
├─────────────────────────────────────────────┤
│         Transformation (dbt)                 │
├─────────────────────────────────────────────┤
│         BI (Looker / Metabase)               │
├─────────────────────────────────────────────┤
│         Reverse ETL (Hightouch / Census)    │
└─────────────────────────────────────────────┘
3. Veri Dönüşümü
ETL ve ELT
| Görünüş | ETL (Geleneksel) | ELT (Modern) |
|---|---|---|
| Sipariş | Çıkart → Dönüştür → Yükle | Çıkart → Yükle → Dönüştür |
| Konumu hesapla | Ayrı ETL sunucusu | Veri ambarı/göl |
| Şema | Yüklemeden önce dönüştürün | Yüklemeden sonra dönüştür |
| Esneklik | Dönüşümleri değiştirmek zor | Yinelenmesi kolay |
| Depolama | Yalnızca yapılandırılmış | Ham veriler mevcut |
| Araçlar | Bilişim, Yetenek | dbt, Spark, SQL |
dbt (Veri Oluşturma Aracı)
dbt, modern veri yığınındaki SQL tabanlı dönüşümler için endüstri standardıdır:
-- models/staging/stg_orders.sql
-- Stage raw orders data
with source as (
    select * from {{ source('shopify', 'orders') }}
),

renamed as (
    select
        id as order_id,
        created_at,
        customer_id,
        total_price::decimal(10,2) as total_amount,
        financial_status,
        fulfillment_status,
        currency
    from source
    where _fivetran_deleted = false  -- Handle soft deletes
)

select * from renamed
-- models/marts/order_summary.sql
-- Business-ready order metrics
with orders as (
    select * from {{ ref('stg_orders') }}
),

customer_totals as (
    select
        customer_id,
        count(*) as total_orders,
        sum(total_amount) as lifetime_value,
        min(created_at) as first_order_date,
        max(created_at) as most_recent_order_date,
        datediff('month', min(created_at), current_date) as customer_tenure_months
    from orders
    group by 1
)

select
    *,
    lifetime_value / nullif(customer_tenure_months, 0) as avg_monthly_value,
    case
        when total_orders = 1 then 'new'
        when total_orders between 2 and 5 then 'regular'
        when total_orders > 5 then 'loyal'
    end as customer_segment
from customer_totals
# dbt_project.yml
name: ecommerce_analytics
version: 1.0
profile: snowflake

models:
  ecommerce_analytics:
    staging:
      +materialized: view
      +schema: staging
    marts:
      +materialized: table
      +schema: analytics
      +incremental_strategy: merge
      +unique_key: order_id
Veri Kalitesi Testleri (dbt)
# schema.yml — Data quality tests
version: 2
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - unique
          - not_null
      - name: total_amount
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0
              max_value: 1000000
      - name: financial_status
        tests:
          - accepted_values:
              values:
                - pending
                - authorized
                - paid
                - refunded
                - cancelled

  - name: order_summary
    tests:
      - dbt_utils.expression_is_true:
          expression: "total_orders >= 1"

    columns:
      - name: customer_id
        tests:
          - relationships:
              to: ref('stg_customers')
              field: customer_id
4. İş Akışı Düzenlemesi
Düzenleme araçları bağımlılıkları ve planlamayı yönetir:
Apache Hava Akışı
# dags/data_pipeline.py
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.providers.snowflake.operators.snowflake import SnowflakeOperator
from datetime import datetime, timedelta

default_args = {
    'owner': 'data_engineering',
    'depends_on_past': False,
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}

with DAG(
    'daily_data_pipeline',
    default_args=default_args,
    description='Main ETL pipeline for analytics',
    schedule_interval='0 6 * * *',  # 6 AM daily
    start_date=datetime(2024, 1, 1),
    catchup=False,
    tags=['production']
) as dag:

    # Task 1: Extract from source databases
    extract_orders = PythonOperator(
        task_id='extract_orders',
        python_callable=extract_from_postgres,
    )

    # Task 2: Load to staging
    load_raw_orders = SnowflakeOperator(
        task_id='load_raw_orders',
        sql='COPY INTO raw.orders FROM @s3_stage',
    )

    # Task 3: Transform with dbt
    run_dbt_transform = BashOperator(
        task_id='run_dbt',
        bash_command='cd /app/dbt && dbt run --models marts',
    )

    # Task 4: Data quality checks
    run_tests = BashOperator(
        task_id='run_tests',
        bash_command='cd /app/dbt && dbt test',
    )

    # Dependencies
    extract_orders >> load_raw_orders >> run_dbt_transform >> run_tests
Veri Hattı İzleme
# Data freshness monitoring
def check_freshness(table: str, max_hours: int):
    query = f"""
        SELECT MAX(loaded_at) as last_updated
        FROM monitoring.table_metadata
        WHERE table_name = '{table}'
    """
    result = run_query(query)
    hours_since_update = (datetime.now() - result['last_updated']).total_seconds() / 3600

    if hours_since_update > max_hours:
        alert_pagerduty(f"DATA FRESHNESS: {table} is {hours_since_update:.1f}h stale")
5. Veri Sunumu
İş Zekası Araçları
| Araç | Tür | En İyisi |
|---|---|---|
| Bakıcı | SaaS | Büyük işletmeler, LookML modelleme katmanı |
| Tablo | Masaüstü/SaaS | Görsel analiz, self servis |
| Power BI | Microsoft ekosistemi | Office 365 entegrasyonu |
| Metatabanı | Açık kaynak | Kendi kendine barındırılan, basit analizler |
| Süper set | Açık kaynak | Bulutta yerel, Python |
Ters ETL
Dönüştürülen verileri operasyonel sistemlere geri gönderin:
# Census reverse ETL configuration
syncs:
  - name: customer_segments_to_hubspot
    source: snowflake.analytics.customer_segments
    destination: hubspot
    mapping:
      - source_column: email
        destination_field: email
      - source_column: customer_segment
        destination_field: lifecycle_stage
      - source_column: lifetime_value
        destination_field: hsf_calculated_amount
    schedule: every 6 hours
ML için Özellik Mağazası
# Feast feature store — Define features
from datetime import timedelta
from feast import FeatureView, Entity, Field
from feast.types import Float32, Int32

customer = Entity(
    name='customer_id',
    value_type=Int32,
    description='Customer identifier'
)

customer_features = FeatureView(
    name='customer_features',
    entities=['customer_id'],
    ttl=timedelta(days=90),
    schema=[
        Field(name='total_orders', dtype=Int32),
        Field(name='lifetime_value', dtype=Float32),
        Field(name='avg_order_value', dtype=Float32),
        Field(name='days_since_last_order', dtype=Int32),
        Field(name='churn_risk_score', dtype=Float32),
    ],
    source=BigQuerySource(
        query="SELECT * FROM analytics.customer_features",
    ),
)
Büyük Veri İşleme
Apache Kıvılcımı
from pyspark.sql import SparkSession
from pyspark.sql.functions import *

spark = SparkSession.builder \
    .appName("CustomerAnalytics") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

# Read from data lake
df = spark.read.parquet("s3://data-lake/raw/orders/*/*.parquet")

# Transform
aggregated = df \
    .filter(col("created_at") >= "2024-01-01") \
    .groupBy("customer_id") \
    .agg(
        count("order_id").alias("total_orders"),
        sum("total_amount").alias("lifetime_value"),
        avg("total_amount").alias("avg_order_value"),
        max("created_at").alias("last_order_date")
    ) \
    .withColumn("segment",
        when(col("total_orders") >= 10, "VIP")
        .when(col("total_orders") >= 3, "Regular")
        .otherwise("New")
    )

# Write to warehouse
aggregated.write \
    .mode("overwrite") \
    .format("delta") \
    .save("s3://data-lake/curated/customer_segments/")
Toplu ve Akış İşleme Karşılaştırması
| Görünüş | Toplu | Akış |
|---|---|---|
| Gecikme | Dakikalardan saatlere | Saniyeden dakikaya |
| Veri hacmi | Çalıştırma başına terabayt+ | Sürekli, sınırsız |
| İşleniyor | Sonlu veri kümeleri | Sonsuz akışlar |
| Eyalet | Toplu iş başına durum bilgisi olmayan | Durum bilgisi olan (pencereleme, birleştirme) |
| Karmaşıklık | Daha düşük | Daha yüksek (tam olarak bir kez, filigranlar) |
| Maliyet | Daha düşük (patlayabilir) | Daha yüksek (her zaman koşuyor) |
| Hata toleransı | Başarısız toplu işlemi yeniden çalıştırın | Kontrol noktası belirleme, durum anlık görüntüleri |
| Kullanım durumları | Günlük raporlama | Gerçek zamanlı gösterge tabloları, uyarılar |
Veri Yönetişimi
Veri Kataloğu
# DataHub metadata
entities:
  - name: orders
    description: Customer order transactions
    ownership:
      - owner: data-engineering@company.com
        type: TECHNICAL_OWNER
      - owner: analytics@company.com
        type: BUSINESS_OWNER
    tags:
      - pii: false
      - classification: internal
      - sla: 99.9% uptime
    schema:
      - column: email
        type: string
        description: Customer email
        tags: [pii, sensitive]
Veri Kökeni
Verilerin kaynaktan kontrol paneline nasıl aktığını izleyin:
orders (Postgres)
  └─► stg_orders (dbt view)
       └─► order_summary (dbt table)
            └─► customer_360 (dbt table)
                 ├─► customer_segments (feature store)
                 └─► revenue_dashboard (Looker)
Veri Mühendisliği Becerileri
| Beceri Alanı | Teknolojiler |
|---|---|
| Programlama | Python, SQL, Java/Scala |
| Orkestrasyon | Hava Akımı, Hançer, Vali |
| Akış İşleme | Kafka, Flink, Spark Yayını |
| Veri Depolama | Kar Tanesi, BigQuery, Redshift |
| Veri Gölleri | S3, Delta Gölü, Buzdağı |
| Dönüşüm | dbt, kıvılcım |
| Altyapı | Docker, Kubernetes, Terraform |
| İzleme | Prometheus, Grafana, Datadog |
| Veri Kalitesi | Büyük Umutlar, dbt testleri |
| CI/CD | GitHub Eylemleri, GitLab CI |
Sonuç
Veri mühendisliği, veriye dayalı organizasyonun temelidir. Temel ilkeler:
- Önce güvenilirlik — Ardışık düzenlerin arızalardan otomatik olarak kurtulması gerekir.
- Veri kalitesi herkesin sorumluluğundadır — Erken test edin, sık sık test edin.
- Doğru aracı seçin — Geçmiş analiz için toplu, gerçek zamanlı akış.
- Artımlı olarak modernleştirin — Modern veri yığınını her seferinde bir bileşen olarak benimseyin.
- Her şeyi belgeleyin — Veri katalogları, köken ve sahiplik geniş ölçekte çok önemlidir.
En iyi veri mühendisleri sıkıcı, güvenilir, öngörülebilir ve bakımı kolay sistemler oluşturur. İzlemeye, test etmeye ve belgelemeye yatırım yaptığınızda veri platformunuz kuruluşunuzla birlikte ölçeklenecektir.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
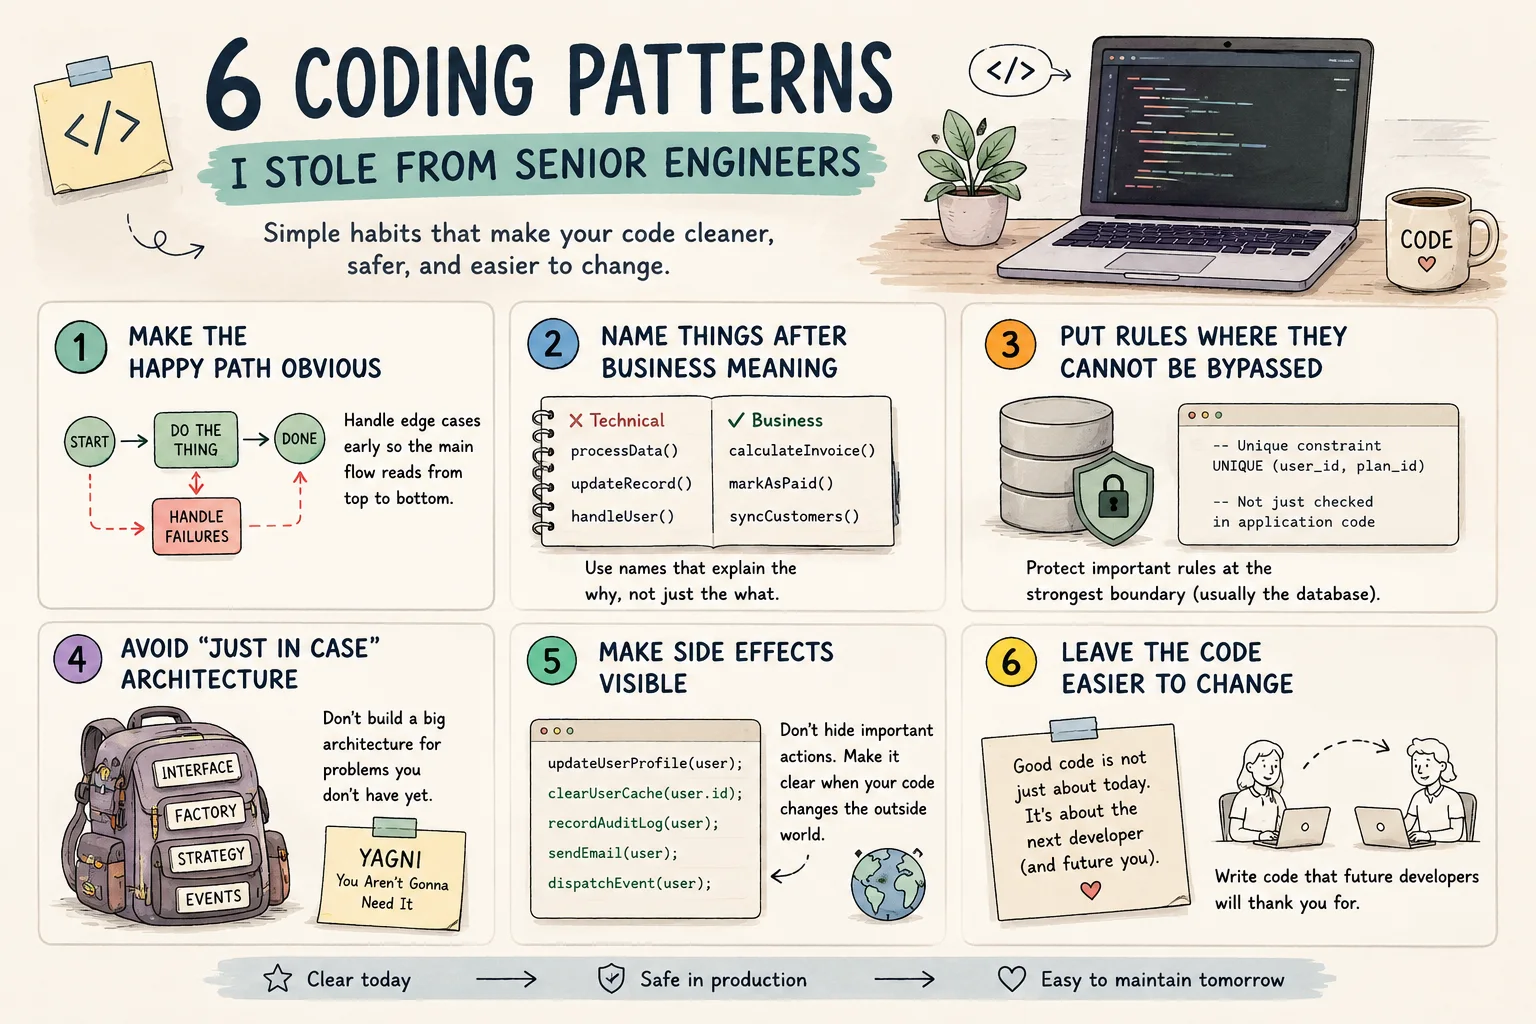
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.