Yapay Zeka Destekli Veritabanları: Otonom ve Akıllı Veri Yönetimi
Veritabanları yapay zekanın yönlendirdiği temel bir dönüşümden geçiyor. Yapay zeka, yazılım geliştirmeyi yeniden şekillendirdiği gibi, veritabanlarının tasarlanma, çalıştırılma ve sorgulanma biçiminde de devrim yaratıyor. Bu üç ana alanı kapsamaktadır:
Giriş
Veritabanları yapay zekanın yönlendirdiği temel bir dönüşümden geçiyor. Yapay zeka, yazılım geliştirmeyi yeniden şekillendirdiği gibi, veritabanlarının tasarlanma, çalıştırılma ve sorgulanma biçiminde de devrim yaratıyor. Bu üç ana alanı kapsamaktadır:
- Veritabanı Yönetimi için Yapay Zeka — Kendi kendini ayarlayan, kendi kendini iyileştiren ve kendi kendini optimize eden özerk veritabanları.
- Veritabanının İçinde Yapay Zeka — Vektör arama, yerleştirmeler ve makine öğrenimi çıkarımı için yerel destek.
- Yapay Zeka Veri Tabanı — Yapay zeka iş yükleri için oluşturulmuş özel veritabanları (özellik depoları, vektör veritabanları, makine öğrenimi meta veri depoları).
Bu makale, yapay zeka ve veritabanlarının nasıl birleşik bir akıllı veri platformuna dönüştüğünü araştırıyor.
1. Otonom Veritabanları: Veritabanı İşlemleri için Yapay Zeka
Otonom Veritabanı Nedir?
Otonom bir veritabanı, provizyon, ayarlama, yama uygulama, yedekleme, ölçeklendirme ve sorun giderme gibi rutin DBA görevlerini otomatikleştirmek için yapay zeka ve makine öğrenimini kullanır. Oracle, Kendi Kendini Yöneten Veritabanıyla buna öncülük etti ve tüm büyük satıcılar da onu takip etti.
| Görev | Geleneksel Veritabanı Yöneticisi | Otonom Veritabanı |
|---|---|---|
| Dizin yönetimi | Manuel analiz, CREATE INDEX | Sorgu modellerine dayalı otomatik dizin oluşturma |
| Sorgu optimizasyonu | EXPLAIN planlarını ve ipuçlarını analiz edin | Yapay zeka, optimum birleştirme siparişlerini ve dizinleri tahmin ediyor |
| Bellek ayarlama | Paylaşılan_buffer'ları, iş_mem'i ayarlayın | İş yükü başına dinamik bellek ayırma |
| Depolama alanı ölçeklendirmesi | Disk ekleme, yeniden bölümleme | Otomatik parça yeniden dengeleme |
| Yama uygulama | Bakım aralıklarını zamanlayın | Sürekli yükseltmeler, sıfır kesinti süresi |
| Yedekleme/kurtarma | Cron'u yapılandırın, yedeklemeleri doğrulayın | Sürekli yedekleme, anında geri yükleme |
| Anormallik tespiti | Performans kontrol panellerini sorgulayın | Yapay zeka yavaş sorguları tespit eder, hataları tahmin eder |
| Güvenlik | Manuel denetim kuralı oluşturma | Yapay zeka anormal erişim modellerini tespit ediyor |
Oracle Kendi Kendini Yöneten Veritabanı
-- Oracle Autonomous Database — self-tuning SQL
SELECT /*+ MONITOR */
       o.customer_id, SUM(o.total) as revenue
FROM orders o
WHERE o.created_at > SYSDATE - 30
GROUP BY o.customer_id
HAVING SUM(o.total) > 1000;

-- Behind the scenes, the autonomous engine:
-- 1. Creates partial indexes if beneficial
-- 2. Adjusts parallel execution degree automatically
-- 3. Caches frequently accessed data
-- 4. Compresses data based on access patterns
-- 5. Monitors for SQL injection attempts
Otomatik İndeksleme
Yapay zeka destekli otomatik dizin yönetimi:
-- Oracle: automatic indexing report
SELECT
    dbms_auto_index.report_last_activity() as report
FROM dual;

-- Sample output:
-- Recommended: idx_orders_customer_date ON orders(customer_id, created_at)
-- Estimated benefit: 85% reduction in query time
-- Action: Created (validated, then made visible)
-- Rejected: idx_orders_total ON orders(total) — never used
SQL Sorgu Performansı Tahmini
class QueryPerformancePredictor:
    """AI model that predicts query runtime before execution"""

    def __init__(self):
        self.model = load_model('query_predictor_v2.pkl')
        self.features = [
            'table_scan_type',      # sequential, index, bitmap
            'join_count',           # number of JOINs
            'join_type',            # hash, nested loop, merge
            'filter_selectivity',   # estimated filter fraction
            'sort_required',
            'group_by_columns',
            'result_rows_estimate',
            'concurrent_queries',
            'buffer_cache_hit_ratio',
        ]

    def predict_runtime(self, query_plan: dict) -> float:
        features = self.extract_features(query_plan)
        predicted_ms = self.model.predict([features])[0]
        confidence = self.model.predict_proba([features]).max()

        if predicted_ms > 5000:
            alert_team(f"Slow query predicted ({predicted_ms:.0f}ms, "
                       f"confidence: {confidence:.1%})")
            return self.suggest_optimization(query_plan)

        return predicted_ms
2. Veritabanının İçinde Yapay Zeka: Yerel Yapay Zeka Yetenekleri
SQL Veritabanlarında Vektör Arama
Modern veritabanları artık vektör aramasını yerel olarak içeriyor:
Pgvector ile PostgreSQL:
CREATE EXTENSION vector;

-- Create table with vector column
CREATE TABLE documents (
    id UUID PRIMARY KEY,
    title TEXT,
    content TEXT,
    embedding vector(1536)  -- OpenAI embedding dimension
);

-- Create IVFFlat index for fast ANN search
CREATE INDEX ON documents
  USING ivfflat (embedding vector_cosine_ops)
  WITH (lists = 100);

-- Create HNSW index (pgvector 0.7+)
CREATE INDEX ON documents
  USING hnsw (embedding vector_cosine_ops);

-- Semantic search query
SELECT title, content,
       1 - (embedding <=> $1) as similarity
FROM documents
ORDER BY embedding <=> $1  -- Cosine distance
LIMIT 10;
SQL Server — Vektör desteği:
-- SQL Server 2026+ vector support
CREATE TABLE documents (
    id INT PRIMARY KEY,
    content NVARCHAR(MAX),
    embedding VECTOR(1536)
);

-- Create vector index
CREATE VECTOR INDEX idx_doc_embeddings
  ON documents (embedding)
  WITH (DISTANCE = COSINE, ALGORITHM = HNSW);

-- Semantic search
SELECT id, content,
       VECTOR_DISTANCE(embedding, @query_vector) as distance
FROM documents
ORDER BY VECTOR_DISTANCE(embedding, @query_vector)
OFFSET 0 ROWS FETCH NEXT 10 ROWS ONLY;
SQL + Vektör Hibrit Arama
Geleneksel SQL filtrelerini anlamsal aramayla birleştirin:
-- Hybrid: filter by category, search by meaning
SELECT d.title, d.content,
       1 - (d.embedding <=> $query_embedding) as relevance
FROM documents d
JOIN document_categories c ON d.category_id = c.id
WHERE c.name IN ('Engineering', 'Product')
  AND d.created_at > '2025-01-01'
  AND d.status = 'published'
ORDER BY relevance DESC
LIMIT 20;
Veritabanı İçinde ML Çıkarımı
ML modellerini doğrudan veritabanı motorunda çalıştırın:
ONNX çalışma zamanı ile PostgreSQL:
-- Load a trained model into PostgreSQL
CREATE MODEL churn_predictor
FROM 's3://models/churn/v3/churn.onnx'
WITH (task = 'classification',
      labels = '{not_churned, churned}');

-- Run inference in SQL
SELECT customer_id,
       name,
       predict(churn_predictor,
               ARRAY[age, tenure, total_orders, avg_order_value, support_tickets]
       ) as churn_probability
FROM customers
WHERE last_login > NOW() - INTERVAL '30 days'
ORDER BY churn_probability DESC
LIMIT 100;
BigQuery ML:
-- Train a model directly on your data
CREATE OR REPLACE MODEL `project.dataset.churn_model`
OPTIONS (
  model_type='LOGISTIC_REG',
  input_label_cols=['churned'],
  regularization=0.01
) AS
SELECT
  age, tenure, total_orders,
  avg_order_value, support_tickets,
  churned
FROM `project.dataset.training_data`;

-- Use the model for predictions
SELECT
  customer_id,
  predicted_churned_probs[OFFSET(1)] as churn_risk
FROM ML.PREDICT(
  MODEL `project.dataset.churn_model`,
  (SELECT * FROM `project.dataset.customers_to_score`)
)
WHERE predicted_churned_probs[OFFSET(1)] > 0.7;
Doğal Dilden SQL'e (NL2SQL)
Veritabanınızla doğal dilde konuşun:
-- What AI translates your question to:
-- User: "Show me the top 5 customers by revenue this month"

SELECT c.name,
       SUM(o.total) as revenue
FROM customers c
JOIN orders o ON c.id = o.customer_id
WHERE DATE_TRUNC('month', o.created_at) = DATE_TRUNC('month', CURRENT_DATE)
GROUP BY c.id, c.name
ORDER BY revenue DESC
LIMIT 5;

-- User: "Which products have not sold in the last 90 days?"
SELECT p.name, p.sku,
       p.quantity_in_stock,
       MAX(o.created_at) as last_sold
FROM products p
LEFT JOIN order_items oi ON p.id = oi.product_id
LEFT JOIN orders o ON oi.order_id = o.id
GROUP BY p.id, p.name, p.sku, p.quantity_in_stock
HAVING MAX(o.created_at) IS NULL
    OR MAX(o.created_at) < CURRENT_DATE - INTERVAL '90 days'
ORDER BY p.name;
3. Yapay Zeka Veritabanı Altyapısı
Özellik Mağazası
Özellik deposu, veri mühendisliği ile MLOps arasında köprü kuran ML özellikleri için merkezi bir depodur:
┌──────────┐   ┌──────────┐   ┌──────────┐
│ Raw Data │   │ Feature  │   │ ML Model │
│ (OLTP)   │──▶│ Store    │──▶│ Training │
└──────────┘   └──────────┘   └──────────┘
                    │
                    ├─► Online serving (Redis)
                    ├─► Offline training (Parquet)
                    └─► Point-in-time joins (Spark)
Bayram Özellik Mağazası:
from feast import FeatureView, Entity, Field
from feast.types import Float32, Int32

# Define features
customer_features = FeatureView(
    name="customer_features",
    entities=["customer_id"],
    ttl=timedelta(days=30),
    schema=[
        Field(name="total_orders", dtype=Int32),
        Field(name="lifetime_value", dtype=Float32),
        Field(name="days_since_last_order", dtype=Int32),
        Field(name="avg_order_value", dtype=Float32),
    ],
    source=BigQuerySource(
        query="SELECT * FROM analytics.customer_features"
    ),
)

# Retrieve features for training
training_df = store.get_historical_features(
    entity_df=entity_df,
    features=[
        "customer_features:total_orders",
        "customer_features:lifetime_value",
        "customer_features:days_since_last_order",
    ]
).to_df()

# Retrieve features for online inference
feature_vector = store.get_online_features(
    features=[
        "customer_features:total_orders",
        "customer_features:lifetime_value",
    ],
    entity_rows=[{"customer_id": customer_id}]
).to_dict()
ML Meta Veri Deposu (MLMD)
ML denemelerini ve yapıtlarını izleyin:
# MLMD — ML Metadata
pipeline:
  - pipeline_name: "churn_prediction"
    run_id: "run_2026_05_24_001"

    steps:
      - step_name: "data_extraction"
        artifacts:
          - type: "dataset"
            uri: "s3://data/raw/orders_2026_05.parquet"
            size: "2.3 GB"

      - step_name: "feature_engineering"
        artifacts:
          - type: "feature_set"
            uri: "s3://features/churn_v3/train.parquet"
            columns: 24
            rows: 500000

      - step_name: "training"
        parameters:
          model_type: "XGBoost"
          n_estimators: 500
          learning_rate: 0.05
          max_depth: 8
        metrics:
          f1_score: 0.87
          accuracy: 0.91
          auc_roc: 0.94
        artifacts:
          - type: "model"
            uri: "s3://models/churn/v3/model.pkl"
            format: "pickle"
Model Kaydı
# MLflow model registry — version and stage management
from mlflow.tracking import MlflowClient

client = MlflowClient()

# Register model version
client.create_model_version(
    name="churn_predictor",
    source="runs:/abc123/model",
    run_id="abc123",
    description="XGBoost with engineered features v3"
)

# Promote to production
client.transition_model_version_stage(
    name="churn_predictor",
    version=3,
    stage="Production"
)

# Stage = "Staging" | "Production" | "Archived"
4. Sorgu Optimizasyonu için Yapay Zeka
Öğrenilmiş Dizin Yapıları
Geleneksel indekslerin (B-Tree, LSM) yerini veri konumunu tahmin eden öğrenilmiş modeller almıştır:
Learned Index:
  Input: search key (e.g., "Alice")
  Model: neural network → predicts page location
  Output: "Page 42, offset 128"

Instead of: B-Tree traversal (O(log N))
AI does: Single model inference (O(1))
Performans karşılaştırması:
| Dizin Türü | Arama Süresi | Bellek | Oluşturma Süresi |
|---|---|---|---|
| B-Ağaç | O(log N) ~50ns | 1x | 1x |
| Öğrenildi (RMI) | O(1) ~10ns | 0,5-2x | 2-10x |
| karma | O(1) ~20ns | 1,5x | 1x |
Kardinalite Tahmini
Yapay zeka, bir sorgunun döndüreceği satır sayısını tahmin eder; bu, sorgu planı optimizasyonu için kritik öneme sahiptir:
-- PostgreSQL classic (statistics-based)
EXPLAIN SELECT * FROM orders WHERE status = 'shipped';
-- Estimated: 50,000 rows  (often wrong)
-- Actual:    125,000 rows

-- AI-enhanced estimation:
-- Model considers: column correlations, data drift, join patterns
-- Estimated: 127,000 rows  (within 2% accuracy)
| Tahminci | Doğruluk (ortalama hata) | Sorgu Planlama İyileştirmesi |
|---|---|---|
| Geleneksel (histogramlar) | %40-200 | Temel |
| Örneklemeye dayalı | %10-50 | +15% |
| ML tabanlı (XGBoost, NN) | %5-15 | +30% |
| Derin öğrenme (sorgu grafiği) | %3-8 | +40% |
5. Geleceğin Veritabanı: Akıllı Veri Platformu
Birleşik Veritabanı
┌─────────────────────────────────────────────────────┐
│               Intelligent Data Platform             │
├────────────┬───────────┬──────────┬──────────┬──────┤
│  Relational│ Document  │ Graph    │ Vector   │ Time │
│  Tables    │ (JSON)    │ (Nodes)  │ (EMBED)  │Series│
├────────────┴───────────┴──────────┴──────────┴──────┤
│              AI-Powered Query Engine                 │
│  ┌──────────────────────────────────────────────┐   │
│  │  Learned Indexes  │  AI Cardinality Est.    │   │
│  │  Auto Tuning      │  Query Pattern Analysis │   │
│  │  Auto Indexing    │  Anomaly Detection      │   │
│  └──────────────────────────────────────────────┘   │
├─────────────────────────────────────────────────────┤
│              ML Execution Engine                      │
│  │  Model Inference │ Embedding Gen. │ NL2SQL       │
├─────────────────────────────────────────────────────┤
│              Storage Layer                            │
│  │ Row Store │ Column Store │ Blob │ Vector Index   │
└─────────────────────────────────────────────────────┘
Bu Geliştiriciler İçin Ne İfade Ediyor?
| Bugün | Yarın |
|---|---|
| Ayrı DB + ML sistemi | Birleşik sorgu: SQL + vektörler + ML |
| Manuel indeks ayarlama | Otomatik indeks oluşturma/silme |
| Uzmanlar tarafından sorgu ayarlama | Yapay zekayla optimize edilmiş sorgu planları |
| Ayrı özellik mühendisliği | Yerleşik özellik hesaplaması |
| ETL işlem hatlarını yazın | Bildirime dayalı veri dönüşümü |
| Toplu model çıkarımı | Gerçek zamanlı, veritabanı içi çıkarım |
Yapay Zeka Destekli Veritabanlarına Başlarken
Pratik Adımlar
- PostgreSQL kullanıyorsanız: Vektör araması için "pgvector"u, veritabanı içi ML için "pg_onnx"i yükleyin.
- Oracle kullanılıyorsa: Otonom Veritabanı seçeneklerini etkinleştirin - otomatik indeksleme, SQL ayarlama.
- Bulut üzerindeyse (BigQuery, Redshift): Yerleşik ML özelliklerini (BigQuery ML, Redshift ML) kullanın.
- Yeni projeler için: Yerel yapay zeka destekli veritabanlarını (SingleStore, Databricks) düşünün.
Örnek: Yapay Zekayla Geliştirilmiş Bir Uygulama Oluşturma
-- Step 1: Create table with vector + text + structured columns
CREATE TABLE products (
    id UUID PRIMARY KEY,
    name TEXT,
    description TEXT,
    price NUMERIC(10,2),
    category TEXT,
    embedding vector(1536),
    -- AI-generated embedding stored here
    created_at TIMESTAMPTZ DEFAULT NOW()
);

-- Step 2: AI creates embeddings automatically (trigger)
CREATE OR REPLACE FUNCTION update_embedding()
RETURNS TRIGGER AS $$
BEGIN
    NEW.embedding := ai_embedding(
        CONCAT(NEW.name, ': ', NEW.description),
        model => 'text-embedding-3-small'
    );
    RETURN NEW;
END;
$$ LANGUAGE plpgsql;

CREATE TRIGGER auto_embed_products
    BEFORE INSERT OR UPDATE OF name, description
    ON products
    FOR EACH ROW
    EXECUTE FUNCTION update_embedding();

-- Step 3: Query with AI
-- "Find affordable wireless headphones similar to AirPods"
SELECT name, price,
       1 - (embedding <=> $query_embedding) as similarity
FROM products
WHERE price < 200
  AND category = 'Electronics'
ORDER BY similarity DESC
LIMIT 10;
Sonuç
Veritabanları ve yapay zeka arasındaki sınır ortadan kalkıyor. Modern veritabanları aşağıdaki özelliklere sahip akıllı platformlar haline geliyor:
- Kendilerini yönet — Otonom operasyonlar, kendi kendini ayarlama, kendi kendini iyileştirme.
- Verileri anlamsal olarak anlayın — Vektör arama, yerleştirmeler, anlamsal SQL.
- ML'yi yerel olarak çalıştırın — Veritabanı içi çıkarım, özellik hesaplama, model eğitimi.
- Kendilerini optimize edin — Öğrenilmiş indeksler, AI önem tahmini, Otomatik Vakum ayarı.
- Yapay zeka iş akışlarını destekleyin — Özellik depoları, makine öğrenimi meta verileri, deneme izleme.
Temel Çıkarımlar
- Yapay zeka destekli veritabanları bilim kurgu değildir — PostgreSQL, Oracle, SQL Server ve BigQuery'nin tümü günümüzde yapay zeka yeteneklerine sahiptir.
- Vektör araması standart bir veritabanı özelliği haline geliyor — ikincil dizinlerin 1990'larda olduğu gibi.
- Otonom operasyonlar DBA'nın iş yükünü azaltır — ancak insan gözetimi hâlâ önemlidir.
- Veritabanı içi ML, veri hareketini ortadan kaldırır — modelleri verilerin bulunduğu yerde eğitin ve çalıştırın.
- Tek bir yetenekle başlayın - önce vektör aramayı ekleyin, ardından otomatik ayarlamayı ve veritabanı içi makine öğrenimini keşfedin.
Geleceğin veritabanı özerk, akıllı ve yapay zekaya özgüdür. Bu yetenekleri benimseyen geliştiriciler, daha az operasyonel ek yük ile daha güçlü uygulamalar geliştireceklerdir.
Öne Çıkan Makaleler
2026’da Oluşturmaya Değer 50 Claude Skill
Claude Skills, tekrarlanan promptları yeniden kullanılabilir workflow’lara dönüştürebilir. İşte yazma, kodlama, araştırma, iş, üretkenlik, tasarım, analiz ve destek için 50 pratik Claude Skill.
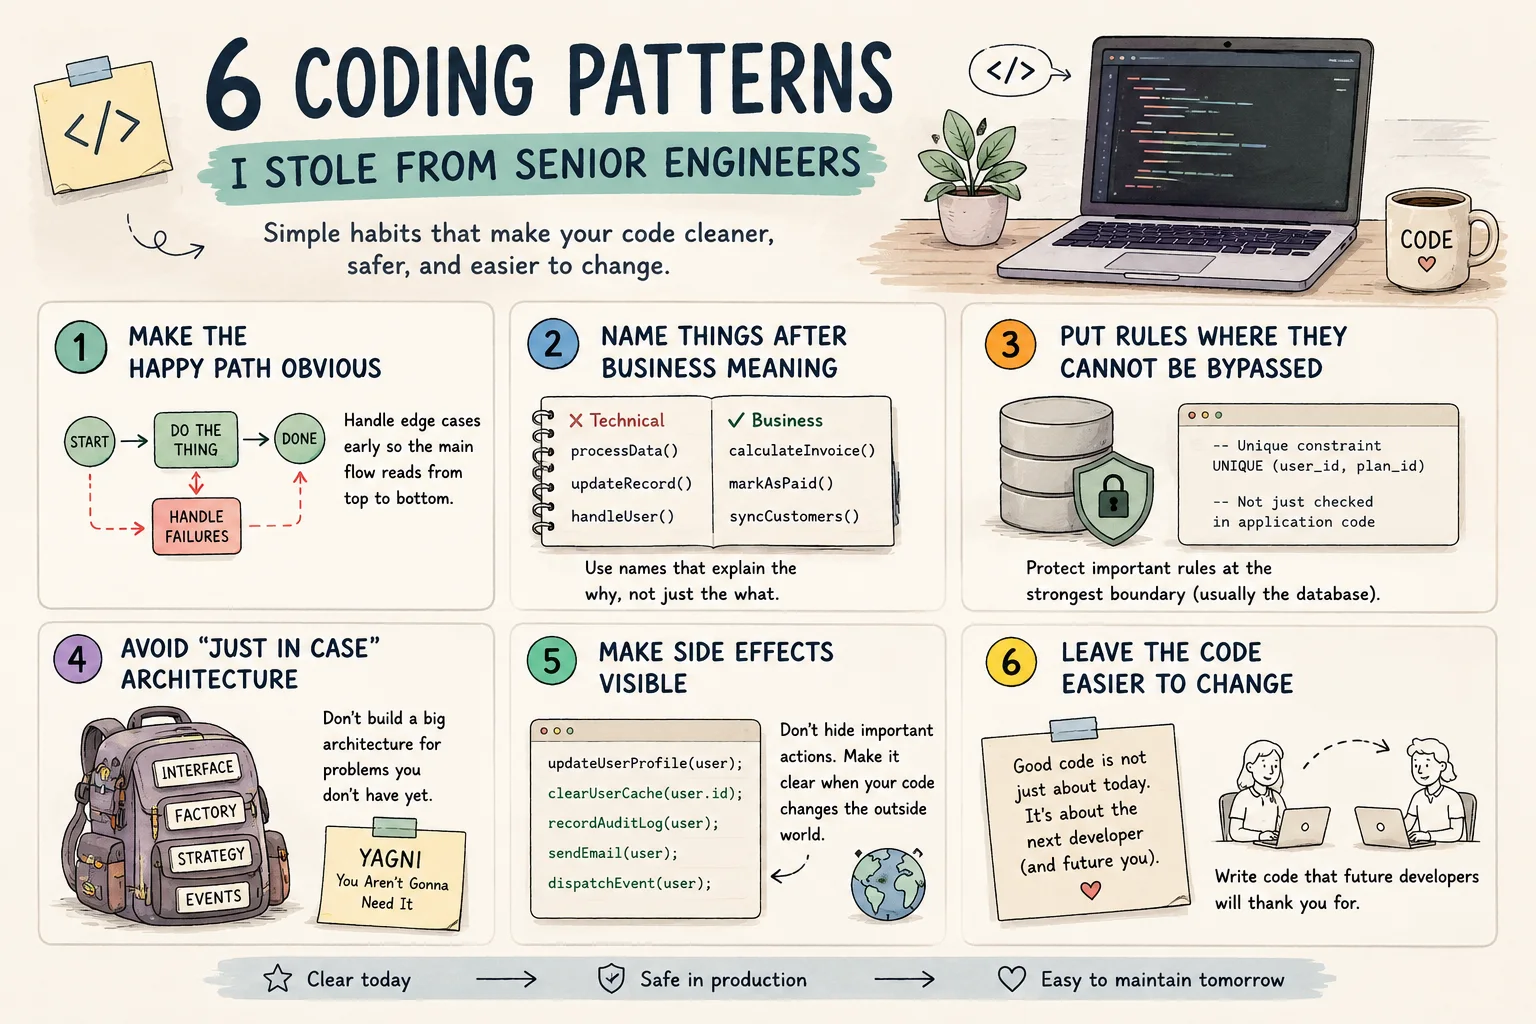
Senior Engineer’lardan Öğrendiğim 6 Kodlama Pattern’i
Özel Bir Yapay Zeka Not Asistanı Kurun
Markdown notlarını özel taslakları açığa çıkarmadan aranabilir bir asistana dönüştürün.
Yorumlar
0 yorumHenüz onaylı yorum yok. Yeni yanıtlar moderasyon bekleyebilir.