Vektordatenbanken: Der Motor hinter semantischer Suche und KI
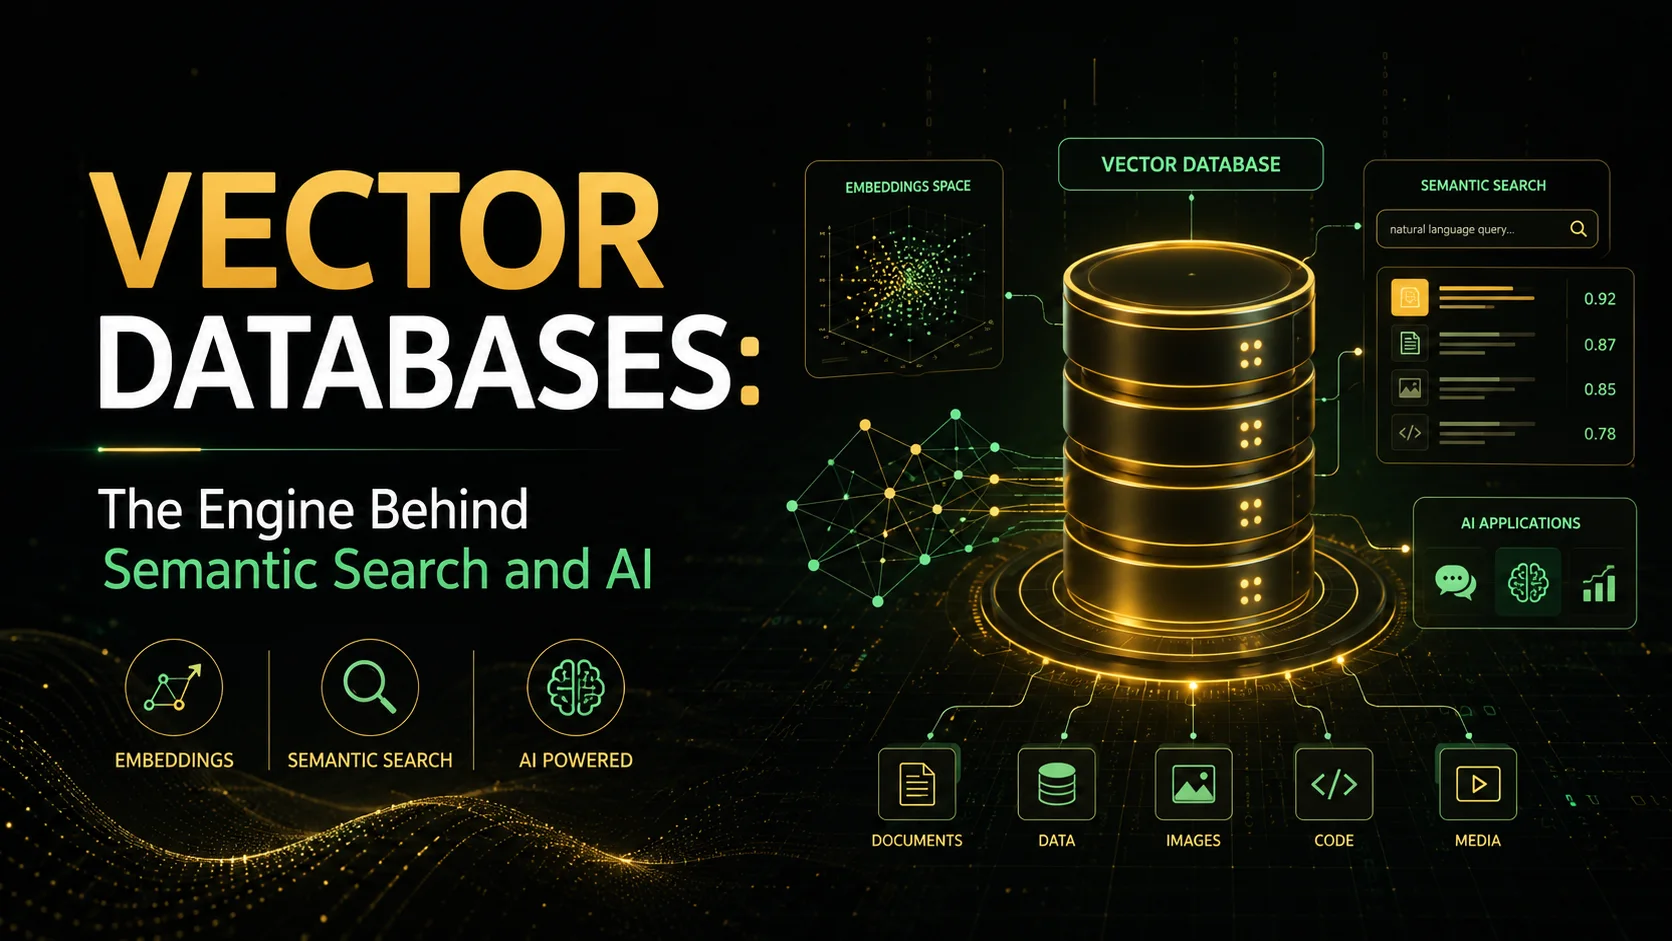
Eine Vektordatenbank ist eine spezielle Datenbank zum Speichern, Indizieren und Abfragen hochdimensionaler Vektoreinbettungen. Unlike traditional databases that search by exact keyword matches or structured queries, vector databases search by semantic similarity — finding data that is conceptually related even if it uses different words.
Einführung
Eine Vektordatenbank ist eine spezielle Datenbank zum Speichern, Indizieren und Abfragen hochdimensionaler Vektoreinbettungen. Unlike traditional databases that search by exact keyword matches or structured queries, vector databases search by semantic similarity — finding data that is conceptually related even if it uses different words.
Vektordatenbanken sind zu einer wesentlichen Infrastruktur für KI-Anwendungen geworden: Sie unterstützen Retrieval-Augmented Generation (RAG), semantische Suche, Empfehlungssysteme, Anomalieerkennung und multimodale KI (Text, Bild, Audio).
Was sind Vektoreinbettungen?
Von Wörtern zu Zahlen
Einbettungen sind numerische Darstellungen von Daten – Text, Bilder, Audio oder andere Modalitäten – die von Modellen des maschinellen Lernens erstellt werden. Der Zauber besteht darin, dass ähnliche Elemente im Vektorraum nahe beieinander landen:
"king" ──► [0.23, -0.45, 0.78, ..., 0.12]  (768 dimensions)
"queen" ──► [0.25, -0.42, 0.76, ..., 0.15]  (close to king)
"apple" ──► [-0.12, 0.65, 0.33, ..., -0.28]  (far from king)
Wie Einbettungen die Bedeutung erfassen
                   ┌───────┐
                   │  man  │
                   └───┬───┘
                       │
       ┌───────────────┼───────────────┐
       │               │               │
   ┌───▼───┐       ┌───▼───┐       ┌───▼───┐
   │  king  │───────│ woman │───────│ queen │
   └───┬───┘       └───┬───┘       └───┬───┘
       │               │               │
       └───────────────┼───────────────┘
                       │
                   ┌───▼───┐
                   │  girl  │
                   └───────┘

Vector arithmetic: king - man + woman = queen
Beliebte Einbettungsmodelle
| Modell | Abmessungen | Am besten für | Anbieter |
|---|---|---|---|
| Texteinbettung-3-klein | 512-1536 | Universell einsetzbar, kostengünstig | OpenAI |
| Texteinbettung-3-groß | 256-3072 | Hohe Genauigkeit, semantische Suche | OpenAI |
| Cohere Embed v3 | 1024 | Mehrsprachig, Klassifizierung | Kohärent |
| BAAI/bge-large-en-v1.5 | 1024 | Open Source, hohe Qualität | Umarmendes Gesicht |
| Satztransformatoren/all-MiniLM-L6-v2 | 384 | Leicht, schnell | Umarmendes Gesicht |
| Bildbinden | 1024 | Multimodal (Text, Bild, Audio) | Meta |
Wie Vektordatenbanken funktionieren
Kernoperationen
- Indizierung – Erstellen Sie eine effiziente Datenstruktur (ANN-Index) über Vektoren.
- Aufnahme – Vektoren mit Metadaten in den Index einfügen.
- Abfragen – Finden Sie anhand eines Abfragevektors die K nächsten Nachbarn (KNN).
- Filtern – Kombinieren Sie Vektorähnlichkeit mit Metadatenfiltern (Hybridsuche).
Das Suchproblem
Die Brute-Force-Suche nach dem nächsten Nachbarn ist O(N) – zu langsam für Millionen von Vektoren:
# Brute force — O(N), not scalable
def brute_force_search(query_vector, all_vectors, k=10):
    distances = []
    for i, vec in enumerate(all_vectors):
        dist = cosine_distance(query_vector, vec)
        distances.append((dist, i))
    return sorted(distances)[:k]
Ungefähre Nearest Neighbor (ANN)-Indizes
Vektordatenbanken verwenden ANN-Algorithmen, um eine sublineare Suchzeit zu erreichen:
| Algorithmus | Geschwindigkeit | Rückruf | Erinnerung | Bauzeit |
|---|---|---|---|---|
| HNSW (Hierarchical Navigable Small World) | ⚡ Schnell | 95-99 % | Hoch | Langsam |
| IVF (Invertierter Dateiindex) | 🐢 Langsam | 90-95 % | Mittel | Schnell |
| IVF + PQ (Produktquantisierung) | ⚡ Schnell | 85-95 % | Niedrig | Mittel |
| DiskANN | ⚡ Schnell | 90-95 % | Niedrig (Festplatte) | Mittel |
| LSH (Ortssensitives Hashing) | 🐢 Langsam | 80-90 % | Hoch | Schnell |
HNSW – Der beliebteste Algorithmus
HNSW erstellt eine mehrschichtige Diagrammstruktur:
Layer 3:  ────────●────────  (sparse, long-range connections)
                   │
Layer 2:  ────●────────●───  (medium density)
               │       │
Layer 1:  ──●──●──●──●──●──  (dense, short-range connections)

Search starts at top layer (coarse) and descends to bottom layer (fine).
Vergleich der Vektordatenbank
| Funktion | Tannenzapfen | Weben | Qdrant | Milvus | Chroma | pgvector |
|---|---|---|---|---|---|---|
| Architektur | Verwaltetes SaaS | Hybrid | Standalone | Verteilt | Eingebettet | PostgreSQL-Erweiterung |
| Beharrlichkeit | Wolke | Cloud/On-Prem | Cloud/On-Prem | Cloud/On-Prem | Lokale Datei | PostgreSQL |
| Index | HNSW | HNSW | HNSW | IVF/HNSW | HNSW | IVFFlat/HNSW |
| Hybridsuche | Ja | Ja | Ja | Ja | Begrenzt | Ja (über SQL) |
| Mehrmandantenfähigkeit | Ja | Ja | Ja | Ja | Handbuch | Über Schemata |
| Filtern | Vorfilter | Vor-/Nachfilter | Vorfilter | Nachfilter | Begrenzt | Filter + Index |
| Metadaten | JSON | JSON | JSON | JSON | JSON | JSONB |
| Open Source | Nein | Ja (BSL) | Ja (Apache 2.0) | Ja (Apache 2.0) | Ja (Apache 2.0) | Ja (PostgreSQL) |
| Selbstveranstalter | Nein | Ja | Ja | Ja | Ja | Ja |
Anwendungsfälle
1. Retrieval-Augmented Generation (RAG)
Der beliebteste Anwendungsfall für Vektordatenbanken – die Erweiterung von LLMs mit privaten Daten:
User Query: "What is our company policy on remote work?"

                ┌─────────────────────────┐
                │   Embedding Model       │
                │  text-embedding-3-small │
                └────────────┬────────────┘
                             │ (query vector)
                             ▼
                ┌─────────────────────────┐
                │   Vector Database       │
                │  (company policies)     │
                └────────────┬────────────┘
                             │ (relevant chunks)
                             ▼
                ┌─────────────────────────┐
                │   LLM (GPT-4 / Claude)  │
                │  "Based on our policy   │
                │   document X, remote    │
                │   work is allowed 3     │
                │   days per week..."    │
                └─────────────────────────┘
Python-Implementierung:
import openai
from qdrant_client import QdrantClient

client = QdrantClient("localhost", port=6333)

def rag_query(question: str) -> str:
    # 1. Embed the question
    query_vector = openai.embeddings.create(
        input=question, model="text-embedding-3-small"
    ).data[0].embedding

    # 2. Search vector database
    results = client.query_points(
        collection_name="company_policies",
        query=query_vector,
        limit=5
    )

    # 3. Build context from retrieved chunks
    context = "\n\n".join([r.payload["text"] for r in results.points])

    # 4. Generate answer with context
    response = openai.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "Answer based on the provided context only."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {question}"}
        ]
    )
    return response.choices[0].message.content
2. Semantische Suche
Suchen Sie nach Bedeutung, nicht nach Schlüsselwörtern:
# Traditional keyword search — misses synonyms
SELECT * FROM products WHERE description LIKE '%cheap laptop%'
# May miss: "affordable notebook" or "budget computer"

# Vector semantic search — finds conceptually related items
results = vector_db.search(
    query="budget-friendly portable computer",
    collection="products",
    limit=10
)
# Finds: "cheap laptop", "affordable notebook", "budget desktop", "entry-level PC"
Leistungsvergleich:
| Suchtyp | Rückruf | Benutzerzufriedenheit | Komplexität der Implementierung |
|---|---|---|---|
| Schlüsselwort (BM25) | 40-60 % | Niedrig | Niedrig |
| Semantik (Vektor) | 70-90 % | Hoch | Mittel |
| Hybrid (BM25 + Vector) | 85-95 % | Sehr hoch | Hoch |
3. Multimodale Suche
Durchsuchen Sie verschiedene Datentypen:
# Text-to-image search
text_vector = embed_text("sunset over mountains")
image_results = vector_db.search(text_vector, collection="images")

# Image-to-text search
image_vector = embed_image(uploaded_photo)
text_results = vector_db.search(image_vector, collection="descriptions")

# Image-to-image search (visual similarity)
product_image_vector = embed_image(product_photo)
similar_products = vector_db.search(product_image_vector, collection="products")
4. Empfehlungssysteme
def recommend_items(user_id: str, n: int = 10):
    # Get user's embedding (from past behavior)
    user_vector = get_user_embedding(user_id)

    # Find similar items in vector space
    recs = vector_db.search(
        query=user_vector,
        collection="items",
        limit=n,
        with_payload=True
    )

    # Diversity re-ranking
    return diversify(recs, diversity_factor=0.3)
Vektordatenbankoperationen
Erstellen einer Sammlung und Einfügen von Vektoren
Qdrant-Beispiel:
from qdrant_client import QdrantClient
from qdrant_client.models import VectorParams, Distance

client = QdrantClient("localhost", port=6333)

# Create collection with specific vector config
client.create_collection(
    collection_name="documents",
    vectors_config=VectorParams(
        size=1536,  # Matches text-embedding-3-small
        distance=Distance.COSINE  # or DOT, EUCLIDEAN
    ),
)

# Insert vectors with payload (metadata)
client.upsert(
    collection_name="documents",
    points=[
        {
            "id": "doc_001",
            "vector": [0.12, -0.45, ..., 0.78],  # 1536-dimensional
            "payload": {
                "title": "Remote Work Policy",
                "category": "HR",
                "author": "HR Team",
                "date": "2026-01-15",
                "chunk_index": 0,
                "text": "Employees may work remotely up to 3 days per week..."
            }
        },
        # ... more points
    ]
)
Hybridsuche mit Filtern
# Semantic search with metadata filters
results = client.query_points(
    collection_name="documents",
    query=query_vector,
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="category",
                match=models.MatchValue(value="Engineering")
            ),
            models.FieldCondition(
                key="date",
                range=models.Range(gte="2025-01-01")
            ),
        ],
        should=[
            models.FieldCondition(
                key="author",
                match=models.MatchValue(value="Alice")
            ),
        ]
    ),
    limit=20,
    score_threshold=0.75  # Minimum similarity score
)
Vektordatenbank vs. traditionelle Datenbank
| Betrieb | PostgreSQL | pgvector | Dedizierte Vektor-DB |
|---|---|---|---|
| Genaue KNN | ❌ (vollständiger Scan) | ❌ (langsam) | ✅ (mittels roher Gewalt) |
| ANN-Suche | ❌ | ✅ (IVFFlat, HNSW) | ✅ (optimiert) |
| Über 10 Millionen Vektoren | ✅ | ⚠️ Die Leistung nimmt ab | ✅ |
| Echtzeit-Streaming | ✅ | ⚠️ | ✅ |
| Hybridsuche | ✅ (SQL-Filter) | ✅ | ✅ |
| Multi-Tenant | ✅ (Schemata) | ✅ | ✅ (Muttersprache) |
| ACID-Transaktionen | ✅ | ✅ | ⚠️ (begrenzt) |
| Zeitreise-Abfragen | ❌ | ❌ | ✅ (WAL) |
Herausforderungen und Überlegungen
Dimensionalitätsfluch
- Höhere Dimensionen machen Entfernungsmetriken weniger aussagekräftig.
- Die meisten Einbettungsmodelle verwenden die Dimensionen 384–1536 – das ist überschaubar.
- Über 2000 Dimensionen hinaus sollten Sie eine Dimensionsreduktion (PCA, UMAP) in Betracht ziehen.
Indexpflege
- HNSW erfordert erheblichen Speicher (Vektoren + Diagrammstruktur).
- IVF erfordert regelmäßige Umschulungen, da die Datenmenge wächst.
- DiskANN tauscht etwas Geschwindigkeit gegen weniger Speicher.
Kosten
vector_database_pricing:
  pinecone:
    starter: "$70/month for 100K vectors"
    enterprise: "$2,000+/month for 10M+ vectors"
  self_hosted_qdrant:
    infrastructure: "$50-500/month (cloud VMs)"
    maintenance: "Operational overhead"
Datenfrische
- Konflikte zwischen der Echtzeitaufnahme und der Indexoptimierung.
- Stapelindizierung für neue Vektoren, inkrementelle Indexierung für Aktualisierungen.
- Kompromiss zwischen Aktualität und Suchqualität.
Fazit
Vektordatenbanken sind eine kritische Infrastrukturkomponente für KI-Anwendungen:
- Verwenden Sie sie, wenn Sie semantisches Verständnis und keine Schlüsselwortübereinstimmung benötigen.
- Die Killer-App ist RAG – sie erweitert LLMs mit privaten, aktuellen Daten.
- Wählen Sie je nach Maßstab – pgvector für kleine Projekte, Pinecone/Qdrant für die Produktion, Milvus für großen Maßstab.
- Hybridsuche (Vektor + Schlüsselwort + Metadaten) liefert die besten Ergebnisse.
- Die Auswahl des Einbettungsmodells ist wichtig – testen Sie verschiedene Modelle für Ihren spezifischen Anwendungsfall.
Die Vektordatenbanklandschaft entwickelt sich rasant weiter. Beginnen Sie einfach (pgvector oder Open-Source-Qdrant), vergleichen Sie es mit Ihren Daten und skalieren Sie es nach Bedarf.
Empfohlene Artikel

6 Coding-Patterns, die ich von Senior Engineers gelernt habe

Einen privaten KI-Assistenten für Notizen bauen
Mache aus Markdown-Notizen einen durchsuchbaren Assistenten, ohne private Entwürfe offenzulegen.

Rechnungsdaten mit OCR automatisiert auslesen
Baue eine Pipeline, die Rechnungen liest, Felder extrahiert und unsichere Werte markiert.
Kommentare
0 KommentareNoch keine freigegebenen Kommentare sichtbar. Neue Antworten können moderiert werden.