Serverlose Architektur
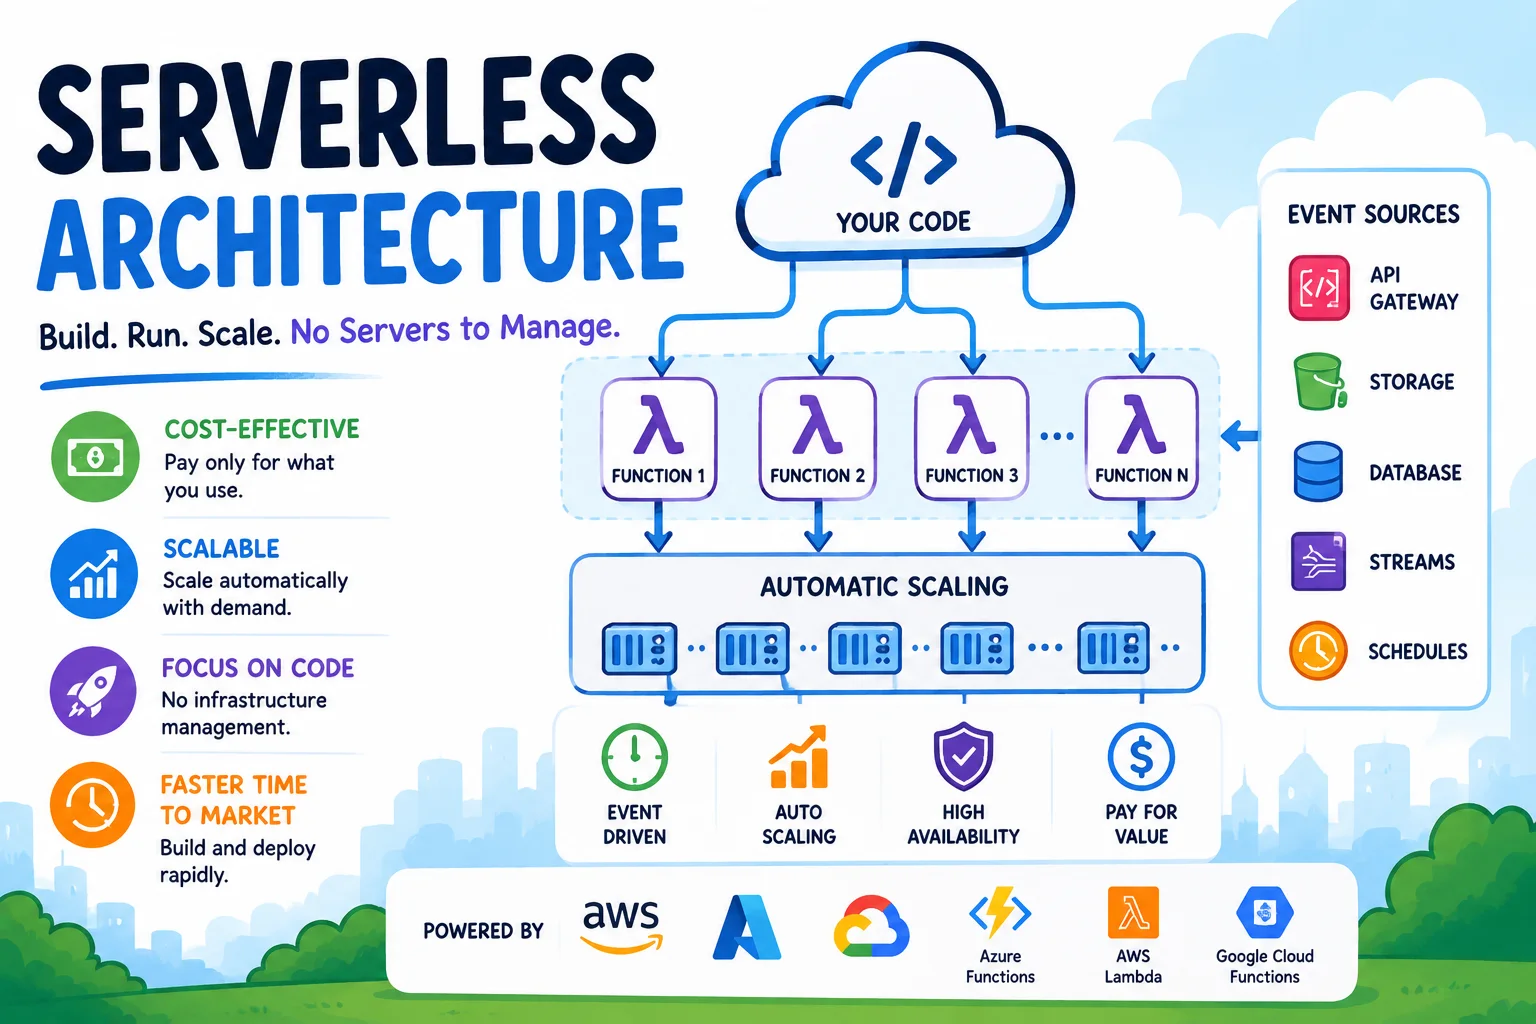
Serverloses Computing ermöglicht es Entwicklern, Anwendungen zu erstellen und auszuführen, ohne Server verwalten zu müssen. Der Cloud-Anbieter kümmert sich um die gesamte Infrastruktur – Bereitstellung, Skalierung, Patching und Wartung. Entwickler schreiben Funktionen, konfigurieren Trigger und die Plattform kümmert sich um den Rest.
Einführung
Serverloses Computing ermöglicht es Entwicklern, Anwendungen zu erstellen und auszuführen, ohne Server verwalten zu müssen. Der Cloud-Anbieter kümmert sich um die gesamte Infrastruktur – Bereitstellung, Skalierung, Patching und Wartung. Entwickler schreiben Funktionen, konfigurieren Trigger und die Plattform kümmert sich um den Rest.
Der Name „serverlos“ ist irreführend – Server sind immer noch beteiligt. Aber der Entwickler denkt nie darüber nach. Dieser Wandel vom Infrastrukturmanagement zur reinen Anwendungslogik verändert die Art und Weise, wie Anwendungen erstellt und bereitgestellt werden.
Wie serverlos funktioniert
Das Ausführungsmodell
                     ┌─────────────────────┐
                     │   Event Source      │
                     │ (HTTP, Queue, Timer,│
                     │  Storage, etc.)     │
                     └──────────┬──────────┘
                                │ Trigger
                                ▼
┌──────────────────────────────────────────────────┐
│              Serverless Function                 │
│  ┌────────────────────────────────────────────┐  │
│  │   1. Cold Start (if needed)               │  │
│  │      - Provision sandbox                  │  │
│  │      - Initialize runtime (Node, Python)  │  │
│  │      - Load dependencies                  │  │
│  ├────────────────────────────────────────────┤  │
│  │   2. Execute handler function              │  │
│  │   3. Return response                       │  │
│  └────────────────────────────────────────────┘  │
│              Auto-scales horizontally             │
│              from 0 to N concurrent executions    │
└──────────────────────────────────────────────────┘
Einfache serverlose Funktion
// AWS Lambda handler
exports.handler = async (event) => {
  const { name } = JSON.parse(event.body);

  const response = {
    statusCode: 200,
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify({
      message: `Hello, ${name}!`,
      timestamp: new Date().toISOString()
    })
  };

  return response;
};
Serverlose vs. traditionelle Architektur
| Aspekt | Traditionell (Server) | Serverlos |
|---|---|---|
| Serververwaltung | Erforderlich (Patches, Updates) | Keine |
| Skalierung | Manuelle oder automatisch skalierende Gruppen | Automatisch, von 0 bis 1000s |
| Abrechnung | Pro Stunde/Instanz (Leerlaufkosten) | Pro Ausführung + pro Speicher (keine Leerlaufkosten) |
| Kaltstarts | N/A (immer an) | 100 ms bis 1 s für den ersten Aufruf |
| Maximale Ausführung | Unbegrenzt | Zeitüberschreitung (15 Minuten Lambda, 10 Minuten Cloud-Funktionen) |
| Staat | Persistent (im Speicher befindlicher Zustand) | Von Natur aus staatenlos |
| Bereitstellung | Vollständiger Server oder Container | Einzelfunktion |
| Granularität | Monolith oder Dienst | Einzelfunktion |
Serverlose Ereignisquellen
Häufige Auslöser
| Ereignisquelle | Anbieter | Anwendungsfall |
|---|---|---|
| HTTP (API-Gateway) | AWS, Azure, GCP | REST-APIs, Webhooks |
| Datenbankänderung (CDC) | DynamoDB-Streams, CosmosDB-Änderungsfeed, Firestore | Daten synchronisieren, Workflows auslösen |
| Datei-Upload | S3, Blob-Speicher, Cloud-Speicher | Bildverarbeitung, Dateivalidierung |
| Nachrichtenwarteschlange | SQS, Warteschlangenspeicher, Pub/Sub | Entkoppelte asynchrone Verarbeitung |
| Stream | Kinesis, Event Hubs, Pub/Sub | Datenverarbeitung in Echtzeit |
| Zeitplan | CloudWatch-Ereignisse, Timer, Planer | Cron-Jobs, Stapelverarbeitung |
| SES, SendGrid | E-Mail-Verarbeitung | |
| IoT | IoT Core, Event Grid | Gerätetelemetrieverarbeitung |
Multi-Event-Funktion
# AWS SAM template — Function triggered by multiple events
AWSTemplateFormatVersion: '2010-09-09'
Transform: AWS::Serverless-2016-10-31

Resources:
  OrderProcessor:
    Type: AWS::Serverless::Function
    Properties:
      CodeUri: src/
      Handler: orders.handler
      Runtime: nodejs20.x
      Events:
        HttpPost:
          Type: Api
          Properties:
            Path: /orders
            Method: POST
        QueueConsumer:
          Type: SQS
          Properties:
            Queue: !GetAtt OrderQueue.Arn
            BatchSize: 10
        StreamProcessor:
          Type: DynamoDB
          Properties:
            Stream: !GetAtt OrdersTable.StreamArn
            StartingPosition: TRIM_HORIZON
Erstellen einer serverlosen Anwendung
Beispiel: Bildverarbeitungspipeline
                  ┌──────────┐
                  │ User     │
                  │ Uploads  │
                  └────┬─────┘
                       ▼
              ┌─────────────────┐
              │  S3 Bucket      │
              │  (upload/raw)   │
              └────────┬────────┘
                       │ trigger
                       ▼
              ┌─────────────────┐
              │  Lambda         │
              │  (process.ts)   │
              │                 │
              │   1. Read image │
              │   2. Resize     │
              │   3. Compress   │
              │   4. Extract    │
              │      metadata   │
              └────────┬────────┘
                       │
               ┌───────┴───────┐
               ▼               ▼
        ┌────────────┐  ┌──────────────┐
        │ S3 Bucket  │  │ DynamoDB    │
        │ (processed)│  │ (metadata)  │
        └────────────┘  └──────────────┘
// process.ts — Image processing Lambda
import { S3 } from '@aws-sdk/client-s3';
import { DynamoDB } from '@aws-sdk/client-dynamodb';
import sharp from 'sharp';

const s3 = new S3();
const dynamo = new DynamoDB();

const SUPPORTED_FORMATS = ['image/jpeg', 'image/png', 'image/webp'];

export const handler = async (event: S3Event) => {
  const results = await Promise.allSettled(
    event.Records.map(async (record) => {
      const bucket = record.s3.bucket.name;
      const key = decodeURIComponent(record.s3.object.key.replace(/\+/g, ' '));

      // Validate file type
      const headResult = await s3.headObject({ Bucket: bucket, Key: key });
      if (!SUPPORTED_FORMATS.includes(headResult.ContentType!)) {
        console.log(`Unsupported format: ${headResult.ContentType}`);
        return;
      }

      // Read original
      const { Body } = await s3.getObject({ Bucket: bucket, Key: key });
      const buffer = await Body!.transformToByteArray();

      // Process: resize to multiple sizes
      const sizes = [
        { suffix: 'thumbnail', width: 150, height: 150 },
        { suffix: 'medium', width: 800, height: 600 },
        { suffix: 'large', width: 1920, height: 1080 },
      ];

      for (const size of sizes) {
        const processed = await sharp(buffer)
          .resize(size.width, size.height, { fit: 'cover' })
          .webp({ quality: 80 })
          .toBuffer();

        const outputKey = key.replace('raw', `processed/${size.suffix}`);
        await s3.putObject({
          Bucket: bucket.replace('-raw', '-processed'),
          Key: outputKey,
          Body: processed,
          ContentType: 'image/webp',
        });
      }

      // Store metadata
      await dynamo.putItem({
        TableName: 'ImageMetadata',
        Item: {
          imageId: { S: key },
          originalSize: { N: buffer.byteLength.toString() },
          formats: { SS: ['thumbnail', 'medium', 'large'] },
          uploadedAt: { S: new Date().toISOString() },
        },
      });
    })
  );

  const failed = results.filter(r => r.status === 'rejected');
  if (failed.length > 0) {
    throw new Error(`${failed.length} images failed processing`);
  }

  return { processed: results.length - failed.length, failed: failed.length };
};
Kaltstarts und Schadensbegrenzung
Was verursacht Kaltstarts?
Wenn eine Funktion inaktiv ist, fordert die Plattform ihre Ressourcen zurück. Der nächste Aufruf erfordert:
- Bereitstellungslaufzeit (~50 ms – Node.js, Python; ~500 ms – Java, C#)
- Abhängigkeiten initialisieren (~50–500 ms je nach Paketgröße)
- Handlercode ausführen (~10–50 ms außerhalb des Handlers)
Gesamtkaltstart: 100 ms bis 2 s, abhängig von Laufzeit und Paketgröße.
Kaltstartzeiten nach Laufzeit
| Laufzeit | Kaltstart (Median) | Kaltstart (S. 99) |
|---|---|---|
| Python | 200 ms | 500 ms |
| Node.js | 250 ms | 600 ms |
| Geh | 100 ms | 300ms |
| .NET | 500 ms | 2s |
| Java | 800 ms | 3s |
| Rost | 100 ms | 250 ms |
Minderungsstrategien
| Strategie | Wie es funktioniert | Kostenauswirkungen |
|---|---|---|
| Bereitgestellte Parallelität (Lambda) | Halten Sie N-Instanzen immer warm | Bezahlen Sie für warme Zeiten |
| SnapStart (Lambda) | Vorinitialisierung und Snapshot der Laufzeit | Minimale zusätzliche Kosten |
| Warmhalte-Pings | Regelmäßige Aufrufe alle 5 Minuten | Vernachlässigbar |
| Geringere Laufzeit | Verwenden Sie Node.js/Python/Go anstelle von Java | Keine zusätzlichen Kosten |
| Abhängigkeiten minimieren | Kleinere Bereitstellungspakete | Keine zusätzlichen Kosten |
Serverlose Kosten
Preismodell
Die Kosten für die meisten serverlosen Plattformen basieren auf:
- Anfragen – Anzahl der Funktionsaufrufe.
- Dauer – Ausführungszeit (auf die nächsten 1 ms oder 100 ms gerundet).
- Speicher – Konfigurierter Speicher pro Aufruf.
Beispiel für einen Kostenvergleich
Scenario: API handling 1M requests/month, 200ms avg execution, 512MB memory

Traditional (t3.small, $0.0208/hr):
  $0.0208 × 730 hours = $15.18/month (always on)

Serverless (Lambda):
  Requests: 1M × $0.20/1M = $0.20
  Duration: 1M × 0.2s × 512MB/1024MB × $0.0000166667/GB-s = $1.67
  Total: $1.87/month

Savings: ~87% at low traffic

Breakeven point: At ~45M requests/month, traditional becomes cheaper
Kostenoptimierung
# Serverless cost optimization checklist
cost_optimization:
  - "Right-size memory: 128MB may be sufficient, but 1769MB costs 14x more"
  - "Use AWS Compute Optimizer for memory recommendations"
  - "Minimize function duration (optimize code, use async where possible)"
  - "Use reserved concurrency only when needed"
  - "Delete unused functions and resources"
  - "Use Lambda SnapStart for Java/.NET to reduce duration"
  - "Leverage Lambda@Edge or CloudFront Functions for edge processing"
Serverloses Ökosystem
Berechnen
| Service | Anbieter | Hauptmerkmal |
|---|---|---|
| AWS Lambda | AWS | Größtes Ökosystem, 15 Minuten Timeout |
| Azure-Funktionen | Microsoft | Tiefe Office 365/Teams-Integration |
| Cloud-Funktionen | Python-first, Eventarc-Integration | |
| Cloudflare-Mitarbeiter | Wolkenflare | Edge-basiert, <1 ms Kaltstarts, 30 MB Skripte |
Datenbanken
| Service | Typ | Serverlose Funktion |
|---|---|---|
| DynamoDB | Schlüsselwert + Dokument | Kapazität nach Bedarf, automatische Skalierung |
| Aurora Serverless | Relational (MySQL/PostgreSQL) | Automatische Skalierung der Rechenkapazität |
| Cosmos DB | Multi-Modell | Serverloser Durchsatzmodus |
| Feuerladen | Dokument | Automatische Skalierung, Echtzeitsynchronisierung |
| Neon | Serverloses PostgreSQL | Verzweigung, automatische Suspendierung |
Lagerung
| Service | Anwendungsfall |
|---|---|
| S3 / Blob / Cloud-Speicher | Dateispeicherung, Ereignisauslöser |
| ElastiCache Serverlos | In-Memory-Caching |
| SQS/Warteschlangenspeicher | Nachrichtenwarteschlange |
| EventBridge / Event Grid | Veranstaltungsbus |
Designmuster
1. Fan-Out-Muster
Mehrere Artikel parallel verarbeiten:
SQS Queue → Lambda → SNS Topic → Lambda (email)
                                 → Lambda (SMS)
                                 → Lambda (push)
                                 → Lambda (logging)
2. Saga-Muster (verteilte Transaktionen)
// Order saga with compensation
async function createOrder(event) {
  const { orderId, userId, items, total } = event;

  try {
    await reserveInventory(items);
    await processPayment(userId, total);
    await createShipment(orderId);
    await sendConfirmation(userId);

    return { status: 'completed', orderId };
  } catch (error) {
    // Compensating transactions (undo)
    await cancelShipment(orderId);
    await refundPayment(userId, total);
    await releaseInventory(items);

    throw error;
  }
}
3. Muster der Drosselungswarteschlange
Behandeln Sie Traffic-Spitzen durch Puffern von Anfragen:
API Gateway → SQS (buffer) → Lambda (process)
                              ↑
                     Process at your own pace
4. Muster der Ereignisbeschaffung
// Store events, derive current state
interface OrderEvent {
  type: 'CREATED' | 'ITEM_ADDED' | 'PAID' | 'SHIPPED' | 'CANCELLED';
  orderId: string;
  timestamp: string;
  data: Record<string, any>;
}

// Function: store event
exports.recordEvent = async (event: OrderEvent) => {
  await dynamo.putItem({
    TableName: 'OrderEvents',
    Item: marshal(event)
  });
  // Don't modify order state directly
};

// Function: rebuild state from events
exports.getOrderState = async (orderId: string) => {
  const events = await queryEvents(orderId);
  return events.reduce((state, event) => applyEvent(state, event), initialState);
};
Serverlose Überwachung und Beobachtbarkeit
Strukturierte Protokollierung
// Structured logging for serverless
const logger = {
  info: (message: string, context?: object) => {
    console.log(JSON.stringify({
      timestamp: new Date().toISOString(),
      level: 'INFO',
      message,
      aws_request_id: context.awsRequestId,
      function_name: context.functionName,
      ...context
    }));
  },
  error: (message: string, error?: Error) => {
    console.error(JSON.stringify({
      timestamp: new Date().toISOString(),
      level: 'ERROR',
      message,
      error_name: error?.name,
      error_message: error?.message,
      stack: error?.stack,
    }));
  }
};
Verteilte Ablaufverfolgung
// X-Ray tracing
import { AWS } from '@aws-sdk/client-lambda';
import { captureAWS } from 'aws-xray-sdk-core';

const lambda = captureAWS(new AWS.Lambda());

exports.handler = async (event) => {
  const segment = new Segment('process_order');
  // ... function logic with automatic subsegment tracking
};
Dashboards
Wichtige zu überwachende Kennzahlen:
- Anzahl der Aufrufe und Fehlerrate.
- Dauer (S. 50, S. 95, S. 99).
- Drosselungen (Parallelitätsgrenzen überschritten).
- Kaltstartrate.
- Kosten pro Funktion.
Wann Sie Serverless NICHT verwenden sollten
| Szenario | Warum serverlos nicht ideal ist | Alternative |
|---|---|---|
| Lang laufende Prozesse (>15 Min.) | Ausführungszeitüberschreitung | Container, VMs |
| Zustandsbehaftete Anwendungen | Von Natur aus staatenlos | Zustandsbehaftete Dienste (WebSocket API, Redis) |
| Konstant hoher Datenverkehr (>100 Anforderungen/s anhaltend) | Die Kosten übersteigen die bereitgestellte Kapazität | Automatisch skalierende Container |
| Anforderungen an niedrige Latenz (<10 ms) | Kaltstart über Kopf | Bereitgestellte Parallelität, Edge-Funktionen |
| Komplexe Orchestrierung | Die Funktionskomposition ist schwierig | Schrittfunktionen, Arbeitsabläufe |
| Plattformspezifische Funktionen | Begrenzte Laufzeitfunktionen | Vollständiger Betriebssystemzugriff (Container) |
Fazit
Serverlose Architektur ist ideal für:
- Ereignisgesteuerte Workloads – Dateiverarbeitung, Webhooks, Benachrichtigungen.
- Variable Verkehrsmuster – APIs mit unvorhersehbarer Auslastung.
- Rapid Prototyping – Es muss keine Infrastruktur eingerichtet werden.
- Hintergrundverarbeitung – Warteschlangen, Streams, geplante Aufgaben.
- Microservice-Komponenten – Isolieren Sie bestimmte Funktionen.
Beginnen Sie mit Serverless für:
- Ein neuer API-Endpunkt.
- Eine Bildverarbeitungspipeline.
- Ein geplanter Datenaggregationsauftrag.
- Ein Webhook-Empfänger.
Migrieren Sie zu Containern, wenn:
- Der Verkehr wird stetig und hochvolumig.
- Die Ausführungsdauer überschreitet ständig die Grenzwerte.
- Sie benötigen bestimmte Funktionen auf Betriebssystemebene.
- Die Kostenanalyse zeigt, dass Container günstiger sind.
Serverlos ist nicht die Antwort auf alles – aber bei den richtigen Workloads reduziert es den Betriebsaufwand und die Entwicklungszeit drastisch.
Empfohlene Artikel

6 Coding-Patterns, die ich von Senior Engineers gelernt habe

Einen privaten KI-Assistenten für Notizen bauen
Mache aus Markdown-Notizen einen durchsuchbaren Assistenten, ohne private Entwürfe offenzulegen.

Rechnungsdaten mit OCR automatisiert auslesen
Baue eine Pipeline, die Rechnungen liest, Felder extrahiert und unsichere Werte markiert.
Kommentare
0 KommentareNoch keine freigegebenen Kommentare sichtbar. Neue Antworten können moderiert werden.