Build-Timeout vs. API-Timeout: Warum ein 700-Sekunden-Fetch nicht in einen 600-Sekunden-Build passt
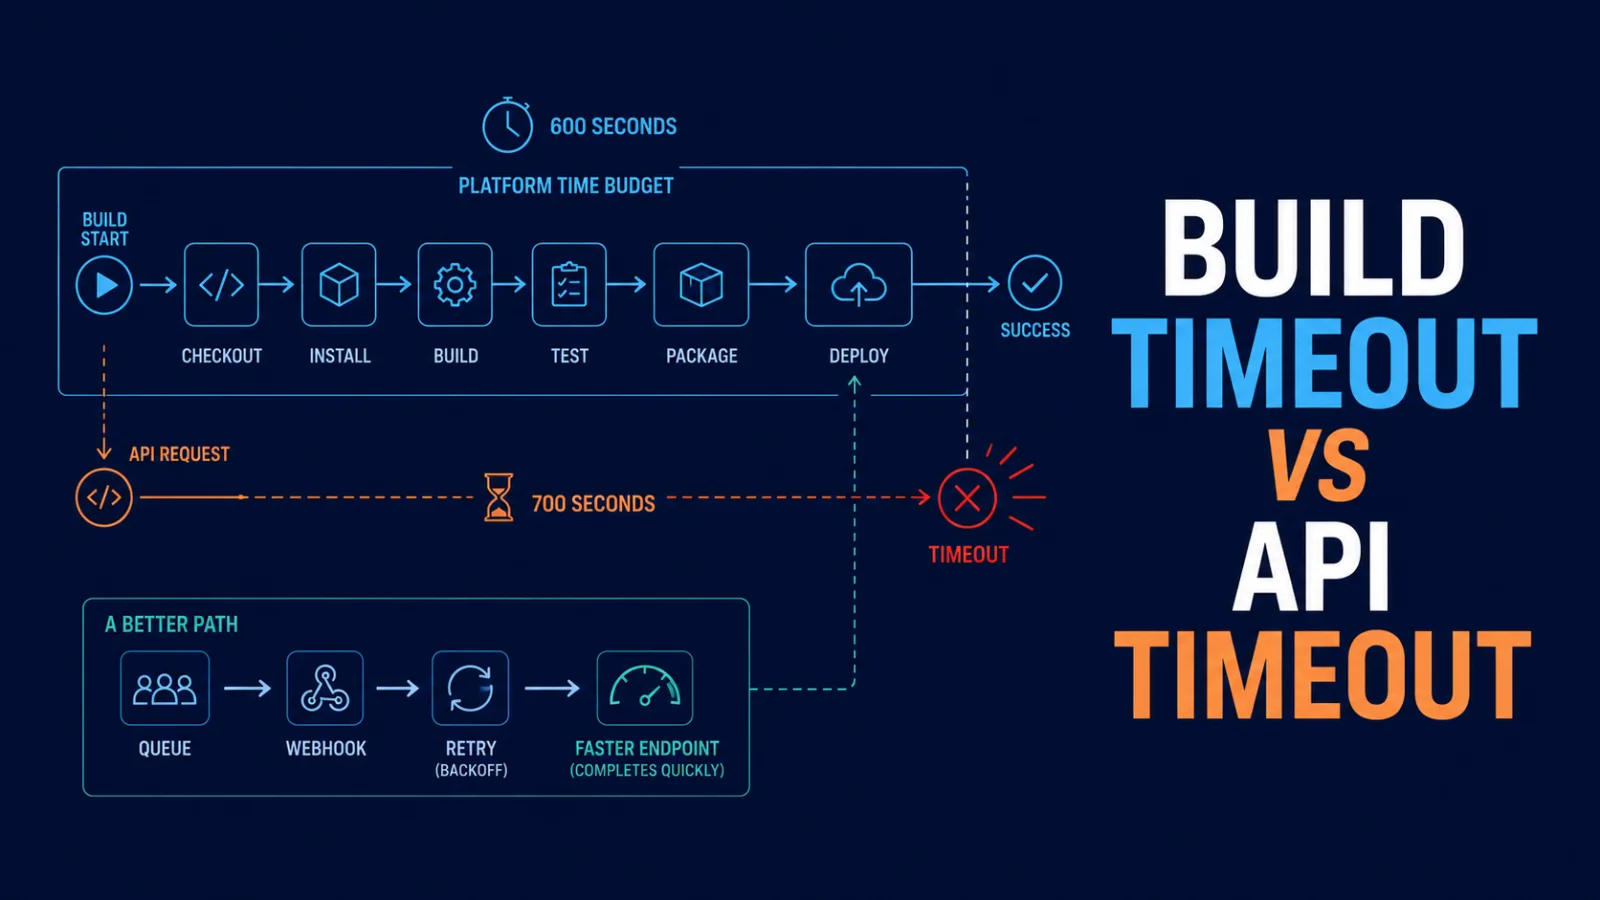
Ein API-Aufruf mit 700 Sekunden Laufzeit kann in einer 600-Sekunden-Build-Umgebung nicht zuverlässig enden. So findest du das echte Deadline-Limit, setzt Budgets und verlegst lange Arbeit aus dem Deployment.
Ein langsamer Request ist nicht das eigentliche Problem
Ein Build lädt Daten über eine API, verarbeitet sie und erzeugt statische Seiten. Darf der Request 700 Sekunden warten, die Plattform beendet den Build aber nach 600 Sekunden, ist das Ergebnis unvermeidbar.
Das ist keine zufällige Störung, sondern ein Konflikt von Deadlines. Außerdem teilt sich der Request das Zeitfenster mit Installation, Kompilierung, Schreiben und Upload der Build-Artefakte.
Die früheste Deadline gewinnt
In Produktionssystemen wirken mehrere Timer gleichzeitig:
| Ebene | Beispiel |
|---|---|
| Build-Limit der Plattform | 600 Sekunden |
| CI-Job | 15 Minuten |
| Framework-Datenabruf | 60 Sekunden |
| HTTP-Client | 700 Sekunden |
| Proxy oder Upstream-API | 30 Sekunden |
Die kleinste gültige Deadline beendet die Arbeit. Ein 700-Sekunden-Timeout im Client verlängert keine Plattform, die den Prozess nach 600 Sekunden beendet.
Erstelle zuerst eine Zeitleiste
Miss den Beginn des Builds und des Fetches, DNS/Verbindung/Time-to-first-byte, Statuscode, Antwortgröße, Request-ID, Retries und die Komponente, die den finalen Fehler ausgibt. Nutze eine Korrelations-ID, aber protokolliere keine Tokens, Autorisierungsheader oder sensiblen Nutzdaten.
Verteile ein Zeitbudget
Ein einzelner API-Aufruf darf nicht das gesamte Build-Limit erhalten. Reserviere Zeit für Installation, Ausgabe und Fehlerbehandlung und gib jedem externen Aufruf ein kleineres, bewusstes Budget.
async function fetchJson(url, { timeoutMs = 15_000, ...options } = {}) {
  const response = await fetch(url, {
    ...options,
    signal: AbortSignal.timeout(timeoutMs),
  });

  if (!response.ok) throw new Error(`Request failed: ${response.status}`);
  return response.json();
}
Wenn der Aufrufer bereits ein Abbruchsignal besitzt, kombiniere es mit AbortSignal.any() und dem Timeout-Signal.
Retries brauchen ebenfalls eine Deadline
Wiederholungen helfen bei temporären Netzwerkfehlern, Drosselung und manchen Serverfehlern. Sie schaden, wenn sie einen sicher scheiternden Request nur vervielfachen. Wiederhole nur idempotente Arbeit, nur plausible temporäre Fehler und nur solange das gesamte Zeitbudget reicht. Verwende exponentielles Backoff und Jitter.
Behebe die Architektur statt nur die Zahl
Ist ein API-Aufruf länger als das Deployment-Fenster, löst ein höherer Client-Timeout nichts. Entferne lange Arbeit aus dem kritischen Pfad:
- Übertrage weniger Felder, nutze Pagination, Indizes oder einen Export-Endpunkt.
- Baue aus einem Cache oder Snapshot und veröffentliche bei Fehlern den letzten gültigen Stand.
- Starte Berichte und große Verarbeitung als Hintergrundjob und verwende anschließend das Ergebnis.
- Nutze inkrementelle Regenerierung, Caching oder Server-Rendering, wenn Aktualität wichtig ist.
- Parallelisiere unabhängige Requests nur mit einer kleinen Obergrenze.
Wann ein höheres Timeout sinnvoll ist
Bei einer seltenen, klar begrenzten Aufgabe kann es sinnvoll sein, wenn alle äußeren Limits es erlauben. Für eine in jedem Build langsame externe Quelle, einen Nutzerpfad oder ein festes Plattformlimit ist es keine Lösung.
Checkliste
- Ermittle die früheste Deadline in Plattform, CI, Proxy, Client und Upstream.
- Reserviere Zeit nach dem Fetch für den Rest des Builds.
- Setze für jeden externen Aufruf ein explizites kleineres Timeout.
- Begrenze Retries mit Gesamtdauer, Backoff und Jitter.
- Cache oder Snapshots für langsame Build-Eingaben verwenden.
- Lange Verarbeitung in Hintergrundjobs verlagern.
- Zeiten, Status und Request-IDs ohne Geheimnisse protokollieren.
Fazit
Ein 700-Sekunden-Fetch in einer 600-Sekunden-Umgebung ist ein Architekturhinweis, kein Tuning-Problem. Mache Daten schneller verfügbar, verwende einen Snapshot oder führe die lange Arbeit außerhalb des Deployments aus.
Empfohlene Artikel
Kafka im Produktivbetrieb: Partitionen, Consumer Lag und sichere Wiederherstellung
Von der Wahl des Partition Keys bis zum Incident Runbook: Dieser Leitfaden verbindet Kafka Kennzahlen mit den tatsächlichen Geschäftsergebnissen.
Laravel und Kafka ohne verlorene Events: Transactional Outbox und idempotente Consumer mit PostgreSQL
Ein Datenbank-Commit und eine Kafka-Veröffentlichung sind keine normale gemeinsame Transaktion. Outbox und Duplikatschutz schließen die wichtigsten Fehlerfenster.
Apache Kafka verstehen: Topics, Partitionen, Consumer Groups und deine erste Event-Pipeline
Verfolge ein Bestellereignis vom Producer zu mehreren Consumern und probiere Partitionen, Reihenfolge und Replay lokal aus.
Kommentare
0 KommentareNoch keine freigegebenen Kommentare sichtbar. Neue Antworten können moderiert werden.