Apache Kafka verstehen: Topics, Partitionen, Consumer Groups und deine erste Event-Pipeline
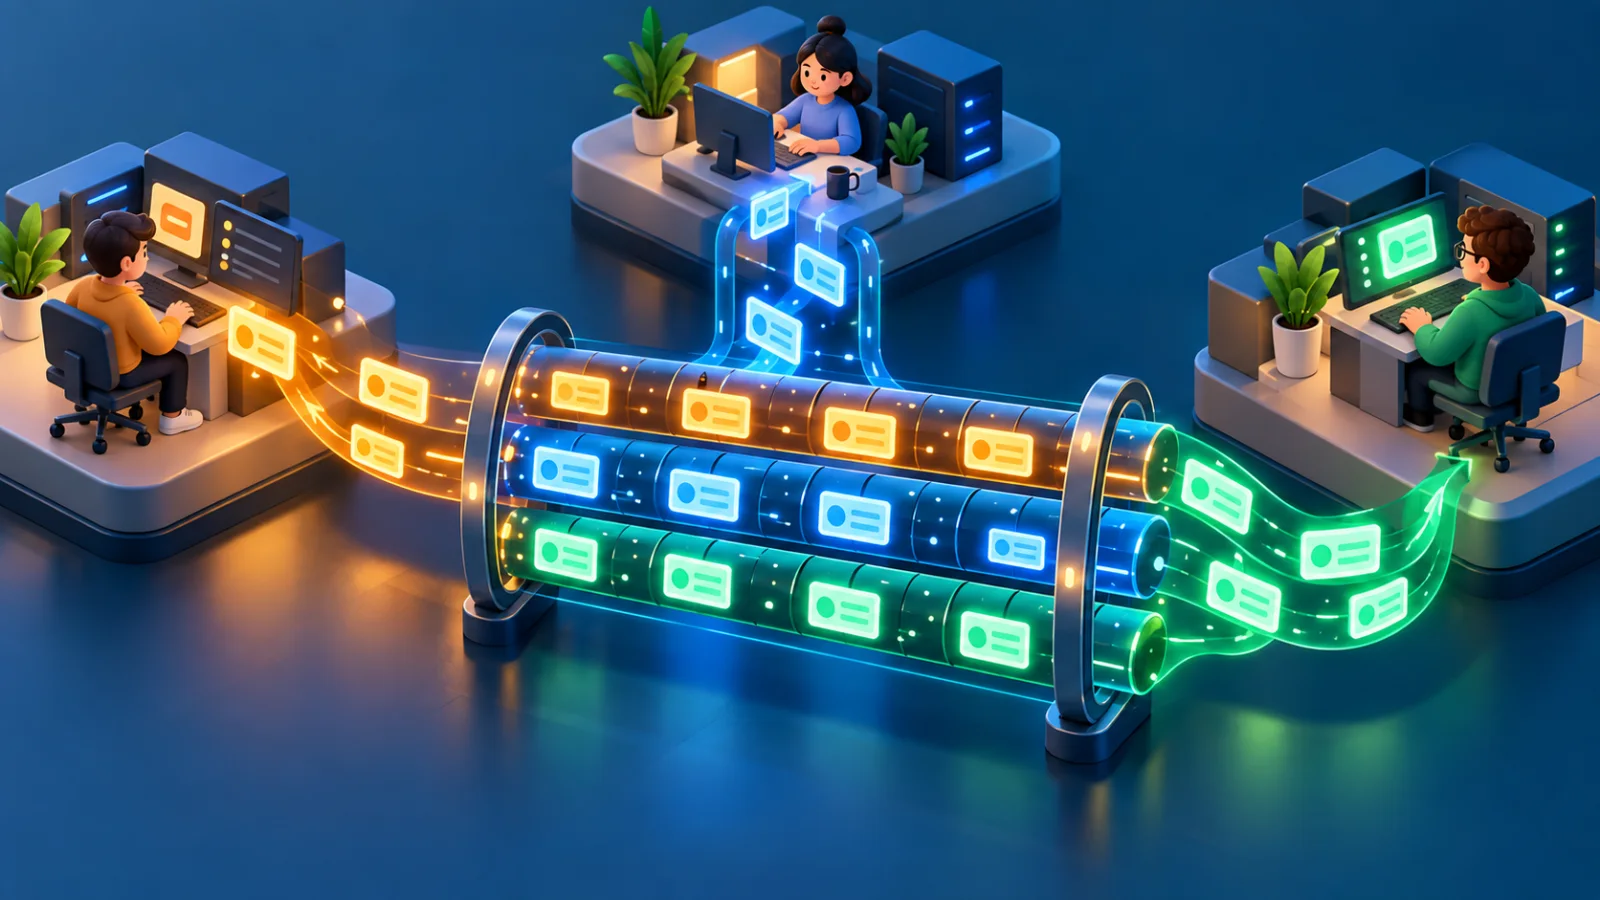
Verfolge ein Bestellereignis vom Producer zu mehreren Consumern und probiere Partitionen, Reihenfolge und Replay lokal aus.
Kafka kann Hintergrundarbeit verteilen. Das hilfreichere Bild ist jedoch ein verteiltes, fortlaufend ergänztes Event-Log, das mehrere Anwendungen unabhängig lesen. Ein Bestelldienst meldet eine aufgegebene Bestellung. Lagerbestand, Analyse und Benachrichtigung reagieren im eigenen Tempo, ohne dass der Bestelldienst alle drei während der Kundenanfrage aufrufen muss.
Damit das zuverlässig funktioniert, musst du Key, Reihenfolge, Aufbewahrung und Verhalten bei Consumer-Ausfällen festlegen. Wir folgen einem Event durch Kafka und führen anschließend einen lokalen Versuch durch.
Die wichtigsten Begriffe
Ein Producer schreibt einen Datensatz in ein Topic. Ein Topic besteht aus Partitionen, jeweils einem geordneten, erweiterten Log. Ein Broker speichert Partitionen und beantwortet Client-Anfragen. Ein Consumer liest Datensätze; Consumer derselben Group teilen die Partitionen untereinander auf.
Ein Datensatz hat einen Wert, einen optionalen Key, Header und einen Zeitstempel. Kafka vergibt einen Offset innerhalb der Partition. (Topic, Partition, Offset) bezeichnet seine Position. Offset 42 in Partition 0 steht in keiner globalen Reihenfolge zu Offset 42 in Partition 1.
Hat orders.placed.v1 vier Partitionen und der Key ist orderId, landen Events derselben Bestellung bei stabiler Partitionierungsregel in derselben Partition. Kafka garantiert Reihenfolge innerhalb einer Partition, nicht über das gesamte Topic. Eine spätere Änderung der Partitionszahl kann die Zuordnung künftiger Events ändern; beachte das bei langfristigen Reihenfolge-Anforderungen.
Ein verständlicher Event-Vertrag
{
  "eventId": "evt_01JQ8X8F",
  "eventType": "OrderPlaced",
  "schemaVersion": 1,
  "occurredAt": "2026-09-29T10:30:00Z",
  "orderId": "ord_782",
  "customerId": "cus_17",
  "totalMinor": 12900,
  "currency": "USD"
}
eventId ermöglicht Duplikaterkennung. Der Kafka-Key ist orderId. totalMinor beschreibt Geld in der kleinsten Währungseinheit. Sende nur nötige Daten: Events können lange gespeichert und erneut gelesen werden. OrderPlaced bezeichnet eine bereits geschehene Tatsache; ReserveInventory wäre ein Befehl mit anderer Verantwortung und Fehlersemantik.
Vom Schreiben zum Lesen
Der Producer holt Cluster-Metadaten, wählt eine Partition und sendet an deren führenden Broker. Replikate können Kopien auf anderen Brokern halten. Acknowledgement-Einstellungen bestimmen, wann der Producer einen Versand als erfolgreich ansieht. Consumer lesen von zugewiesenen Partitionen.
Eine Consumer Group speichert ihren Fortschritt als committete Offsets. Ein Offset-Commit löscht das Event nicht. inventory-reservation und sales-analytics sind unabhängige Gruppen, die beide OrderPlaced lesen. Solange Daten erhalten bleiben, kann eine Gruppe ihren Offset auch zurücksetzen und erneut lesen.
Bei vier Partitionen und drei Instanzen derselben Gruppe verteilen sich die Partitionen. Eine fünfte Instanz erhält aus diesem Topic keine zusätzliche aktive Partition. Tritt ein Consumer bei oder fällt aus, kann ein Rebalance die Zuordnung ändern. Dein Code darf nicht von dauerhaftem Partitionsbesitz ausgehen.
Kafka lokal ausprobieren
Der offizielle Quickstart zeigt ein Apache-Docker-Image:
docker run -d --name kafka-demo -p 9092:9092 apache/kafka:4.3.1
Führe die folgenden Befehle in einer Umgebung mit Kafka-Binärdateien unter bin/ und erreichbarem Broker localhost:9092 aus:
bin/kafka-topics.sh --create --topic quickstart-events \
  --bootstrap-server localhost:9092
bin/kafka-topics.sh --describe --topic quickstart-events \
  --bootstrap-server localhost:9092
bin/kafka-console-producer.sh --topic quickstart-events \
  --bootstrap-server localhost:9092
Schreibe einige Zeilen in das Producer-Terminal. Lies sie in einem zweiten Terminal:
bin/kafka-console-consumer.sh --topic quickstart-events \
  --from-beginning --bootstrap-server localhost:9092
Laufen die CLI-Werkzeuge im Container, nutze dort die mitgelieferten Dateien und die passende lokale Adresse. Ein Broker ist eine Lernumgebung, keine hochverfügbare Produktion. Starte danach zwei Consumer derselben Gruppe und einen aus einer anderen Gruppe. Für echte Parallelität benötigst du mehrere Partitionen; eine Partition kann pro Gruppe nur einem aktiven Consumer zugeteilt werden.
Keys und Partitionszahl planen
orderId erhält die Reihenfolge je Bestellung. customerId erhält sie je Kunde, kann bei einem besonders aktiven Kunden aber eine heiße Partition verursachen. Ein konstanter Key konzentriert alles; zufällige Keys verteilen Last, verlieren jedoch die Reihenfolge zusammengehöriger Events. Frage zuerst: Für welche Entität ist Reihenfolge erforderlich?
Die Partitionszahl begrenzt die aktive Consumer-Parallelität einer Gruppe für dieses Topic. Viele Partitionen verursachen auch Metadaten-, Datei- und Replikationsaufwand. Wähle anhand gemessener Last und Wachstum, nicht anhand eines willkürlich hohen Werts.
Retention, Replay und Compaction
Kafka löscht Datensätze nicht nach dem Lesen. Zeit- oder größenbasierte Retention entfernt alte Events später. Ist eine Gruppe länger offline als die Aufbewahrungsfrist, kann ihr alter Offset nicht mehr erreichbar sein. Überwache diesen Abstand.
Log Compaction bewahrt über die Zeit einen aktuellen Wert je Key für Zustands-Changelogs auf; sie ist kein vollständiges unveränderliches Audit-Log. Ein Datensatz mit Key und Null-Wert ist ein Tombstone für Löschung. Trenne Themen für Event-Historie und aktuellen Zustand, wenn beide Anforderungen bestehen.
Replay kann eine Projektion neu aufbauen, aber auch E-Mails oder Zahlungen wiederholen. Verwende eventId und idempotente Seiteneffekte. Für eine einzelne Hintergrund-Mail reicht oft eine normale Job-Queue. Kafka lohnt sich, wenn unabhängige Leser und Wiederholung einen echten Wert liefern.
Dein erstes Projekt
Erstelle orders.placed.v1 in einer Testumgebung, veröffentliche Events mit orderId als Key und betreibe Lager- und Analyse-Gruppen. Stoppe und starte einen Consumer neu. Erkläre im README Key-Wahl, Wiederaufnahme per Offset, Retention-Grenze und Verhalten bei doppelten Events.
Offizielle Quellen
Empfohlene Artikel
Kafka im Produktivbetrieb: Partitionen, Consumer Lag und sichere Wiederherstellung
Von der Wahl des Partition Keys bis zum Incident Runbook: Dieser Leitfaden verbindet Kafka Kennzahlen mit den tatsächlichen Geschäftsergebnissen.
Laravel und Kafka ohne verlorene Events: Transactional Outbox und idempotente Consumer mit PostgreSQL
Ein Datenbank-Commit und eine Kafka-Veröffentlichung sind keine normale gemeinsame Transaktion. Outbox und Duplikatschutz schließen die wichtigsten Fehlerfenster.
APIs entwerfen, denen Clients vertrauen können: Ein praktischer Leitfaden vom Vertrag aus
Gute APIs machen den nächsten Schritt für Clients vorhersehbar. Ein Kursanmeldungs-Beispiel zeigt sichere Wiederholungen, verständliche Fehler und Änderungen am Vertrag.
Kommentare
0 KommentareNoch keine freigegebenen Kommentare sichtbar. Neue Antworten können moderiert werden.