قواعد بيانات المتجهات: المحرك وراء البحث الدلالي والذكاء الاصطناعي
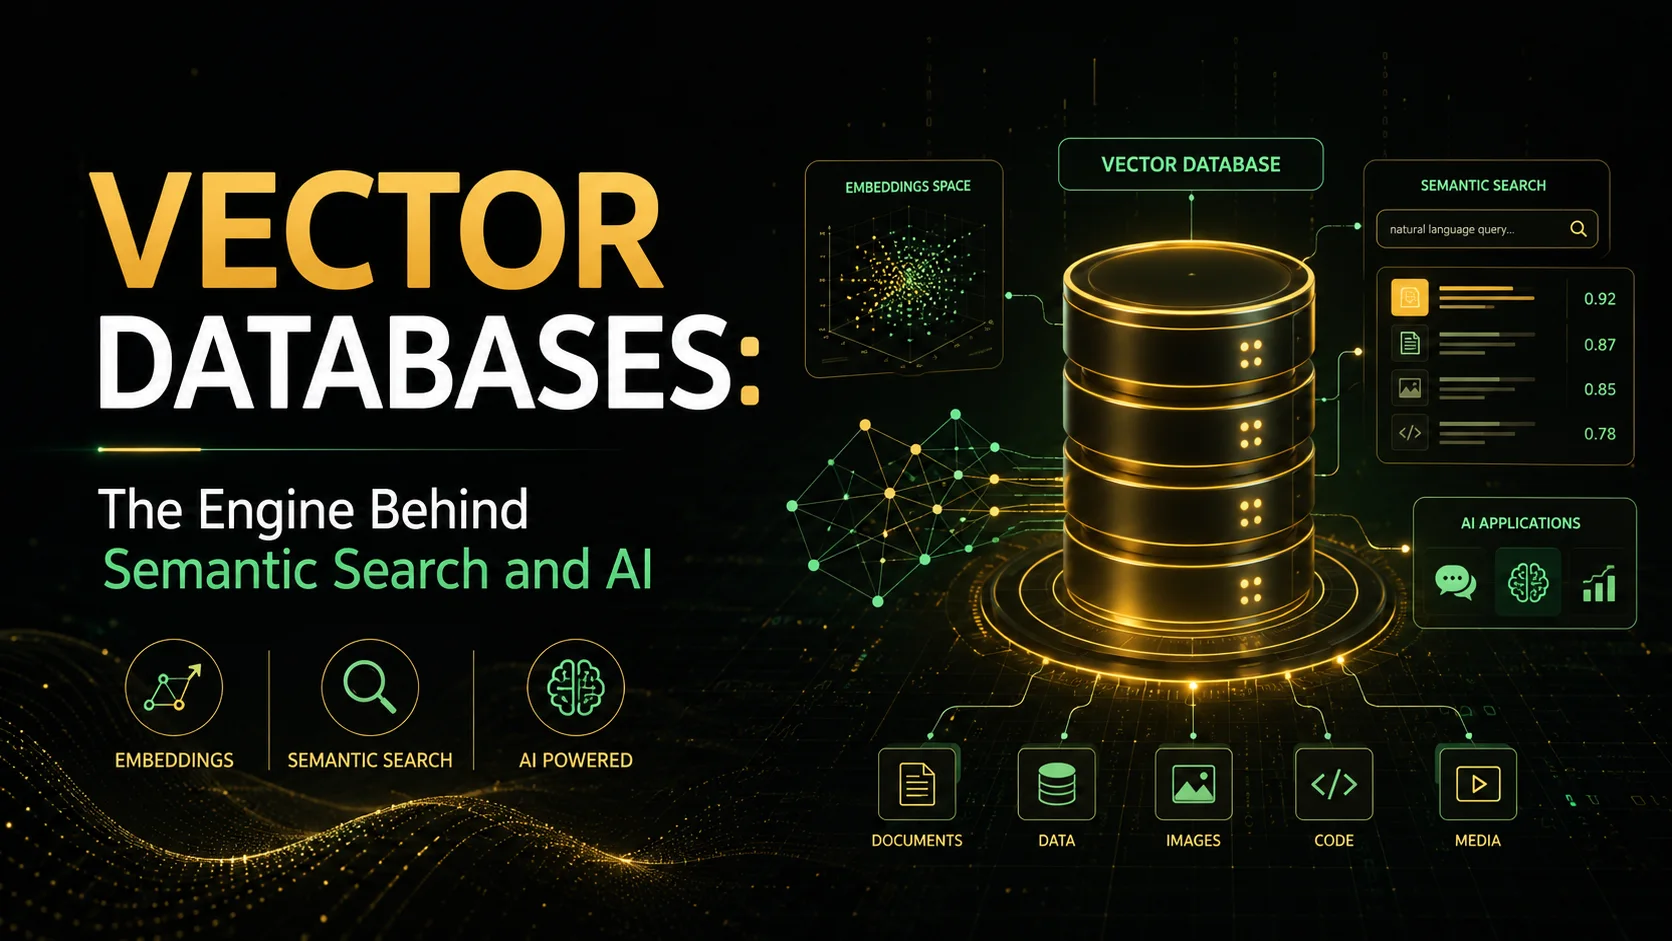
قاعدة البيانات المتجهة هي قاعدة بيانات متخصصة مصممة لتخزين وفهرسة والاستعلام عن تضمينات المتجهات عالية الأبعاد. على عكس قواعد البيانات التقليدية التي تبحث عن طريق التطابقات الدقيقة للكلمات الرئيسية أو الاستعلامات المنظمة، تبحث قواعد البيانات المتجهة عن طريق التشابه الدلالي — للعثور على البيانات ذات الصلة من الناحية المفاهيمية حتى لو كانت تستخدم كلمات مختلفة.
مقدمة
قاعدة البيانات المتجهة هي قاعدة بيانات متخصصة مصممة لتخزين وفهرسة والاستعلام عن تضمينات المتجهات عالية الأبعاد. على عكس قواعد البيانات التقليدية التي تبحث عن طريق التطابقات الدقيقة للكلمات الرئيسية أو الاستعلامات المنظمة، تبحث قواعد البيانات المتجهة عن طريق التشابه الدلالي — للعثور على البيانات ذات الصلة من الناحية المفاهيمية حتى لو كانت تستخدم كلمات مختلفة.
أصبحت قواعد بيانات المتجهات بنية تحتية أساسية لتطبيقات الذكاء الاصطناعي: تشغيل الجيل المعزز للاسترجاع (RAG)، والبحث الدلالي، وأنظمة التوصية، والكشف عن الحالات الشاذة، والذكاء الاصطناعي متعدد الوسائط (النص والصورة والصوت).
ما هي التضمينات المتجهات؟
من الكلمات إلى الأرقام
التضمينات عبارة عن تمثيلات رقمية للبيانات - النصوص أو الصور أو الصوت أو أي طريقة أخرى - تنتجها نماذج التعلم الآلي. السحر هو أن العناصر المتشابهة ينتهي بها الأمر بالقرب من بعضها البعض في الفضاء المتجه:
"king" ──► [0.23, -0.45, 0.78, ..., 0.12]  (768 dimensions)
"queen" ──► [0.25, -0.42, 0.76, ..., 0.15]  (close to king)
"apple" ──► [-0.12, 0.65, 0.33, ..., -0.28]  (far from king)
كيف تلتقط التضمينات المعنى
                   ┌───────┐
                   │  man  │
                   └───┬───┘
                       │
       ┌───────────────┼───────────────┐
       │               │               │
   ┌───▼───┐       ┌───▼───┐       ┌───▼───┐
   │  king  │───────│ woman │───────│ queen │
   └───┬───┘       └───┬───┘       └───┬───┘
       │               │               │
       └───────────────┼───────────────┘
                       │
                   ┌───▼───┐
                   │  girl  │
                   └───────┘

Vector arithmetic: king - man + woman = queen
نماذج التضمين الشعبية
| نموذج | الأبعاد | أفضل ل | مزود |
|---|---|---|---|
| تضمين النص-3-صغير | 512-1536 | للأغراض العامة، فعالة من حيث التكلفة | OpenAI |
| تضمين النص-3-كبير | 256-3072 | دقة عالية، والبحث الدلالي | OpenAI |
| كوهير تضمين v3 | 1024 | متعدد اللغات، التصنيف | تماسك |
| BAAI/bge-large-en-v1.5 | 1024 | مفتوحة المصدر، ذات جودة عالية | تعانق الوجه |
| محولات الجملة/all-MiniLM-L6-v2 | 384 | خفيفة الوزن وسريعة | تعانق الوجه |
| imagebind | 1024 | متعدد الوسائط (نص، صورة، صوت) | ميتا |
كيف تعمل قواعد بيانات المتجهات
العمليات الأساسية
- الفهرسة — إنشاء بنية بيانات فعالة (مؤشر ANN) على المتجهات.
- العرض — قم بإدراج المتجهات ذات البيانات الوصفية في الفهرس.
- الاستعلام — بالنظر إلى متجه الاستعلام، ابحث عن أقرب جيران K (KNN).
- التصفية — دمج تشابه المتجهات مع مرشحات البيانات الوصفية (بحث مختلط).
مشكلة البحث
القوة الغاشمة للبحث عن أقرب جار هي O(N) - بطيئة جدًا بالنسبة لملايين المتجهات:
# Brute force — O(N), not scalable
def brute_force_search(query_vector, all_vectors, k=10):
    distances = []
    for i, vec in enumerate(all_vectors):
        dist = cosine_distance(query_vector, vec)
        distances.append((dist, i))
    return sorted(distances)[:k]
فهارس أقرب جار (ANN) التقريبية
تستخدم قواعد بيانات المتجهات خوارزميات ANN لتحقيق وقت البحث الخطي الفرعي:
| خوارزمية | السرعة | أذكر | الذاكرة | وقت البناء |
|---|---|---|---|---|
| HNSW (عالم صغير هرمي قابل للملاحة) | ⚡ سريع | 95-99% | عالية | بطيء |
| IVF (فهرس الملفات المقلوب) | 🐢 بطيء | 90-95% | متوسط | سريع |
| ** IVF + PQ ** (تكميم المنتج) | ⚡ سريع | 85-95% | منخفض | متوسط |
| ** ديسك آن ** | ⚡ سريع | 90-95% | منخفض (القرص) | متوسط |
| LSH (التجزئة الحساسة للمنطقة المحلية) | 🐢 بطيء | 80-90% | عالية | سريع |
HNSW — الخوارزمية الأكثر شيوعًا
تقوم HNSW ببناء هيكل رسم بياني متعدد الطبقات:
Layer 3:  ────────●────────  (sparse, long-range connections)
                   │
Layer 2:  ────●────────●───  (medium density)
               │       │
Layer 1:  ──●──●──●──●──●──  (dense, short-range connections)

Search starts at top layer (coarse) and descends to bottom layer (fine).
مقارنة قاعدة بيانات المتجهات
| ميزة | كوز الصنوبر | ويفيات | قدررانت | ميلفوس | صفاء | com.pgvector |
|---|---|---|---|---|---|---|
| الهندسة المعمارية | إدارة العلاقات مع الإدارة | هجين | مستقل | وزعت | جزءا لا يتجزأ | ملحق PostgreSQL |
| ** الثبات ** | سحابة | السحابة/محليًا | السحابة/محليًا | السحابة/محليًا | الملف المحلي | PostgreSQL |
| الفهرس | HNSW | HNSW | HNSW | أطفال الأنابيب / HNSW | HNSW | IVFFlat/HNSW |
| ** بحث مختلط ** | نعم | نعم | نعم | نعم | محدودة | نعم (عبر SQL) |
| الإيجار المتعدد | نعم | نعم | نعم | نعم | دليل | عبر المخططات |
| التصفية | تصفية مسبقة | ما قبل / ما بعد التصفية | تصفية مسبقة | ما بعد التصفية | محدودة | الفلتر + الفهرس |
| ** البيانات الوصفية ** | JSON | JSON | JSON | JSON | JSON | JSONB |
| ** المصدر المفتوح ** | لا | نعم (BSL) | نعم (أباتشي 2.0) | نعم (أباتشي 2.0) | نعم (أباتشي 2.0) | نعم (بوستجرسكل) |
| ** المضيف الذاتي ** | لا | نعم | نعم | نعم | نعم | نعم |
حالات الاستخدام
1. الجيل المعزز للاسترجاع (RAG)
حالة استخدام قاعدة بيانات المتجهات الأكثر شيوعًا - تعزيز ماجستير إدارة الأعمال (LLM) بالبيانات الخاصة:
User Query: "What is our company policy on remote work?"

                ┌─────────────────────────┐
                │   Embedding Model       │
                │  text-embedding-3-small │
                └────────────┬────────────┘
                             │ (query vector)
                             ▼
                ┌─────────────────────────┐
                │   Vector Database       │
                │  (company policies)     │
                └────────────┬────────────┘
                             │ (relevant chunks)
                             ▼
                ┌─────────────────────────┐
                │   LLM (GPT-4 / Claude)  │
                │  "Based on our policy   │
                │   document X, remote    │
                │   work is allowed 3     │
                │   days per week..."    │
                └─────────────────────────┘
تنفيذ بايثون:
import openai
from qdrant_client import QdrantClient

client = QdrantClient("localhost", port=6333)

def rag_query(question: str) -> str:
    # 1. Embed the question
    query_vector = openai.embeddings.create(
        input=question, model="text-embedding-3-small"
    ).data[0].embedding

    # 2. Search vector database
    results = client.query_points(
        collection_name="company_policies",
        query=query_vector,
        limit=5
    )

    # 3. Build context from retrieved chunks
    context = "\n\n".join([r.payload["text"] for r in results.points])

    # 4. Generate answer with context
    response = openai.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": "Answer based on the provided context only."},
            {"role": "user", "content": f"Context:\n{context}\n\nQuestion: {question}"}
        ]
    )
    return response.choices[0].message.content
2. البحث الدلالي
البحث حسب المعنى وليس الكلمات الرئيسية:
# Traditional keyword search — misses synonyms
SELECT * FROM products WHERE description LIKE '%cheap laptop%'
# May miss: "affordable notebook" or "budget computer"

# Vector semantic search — finds conceptually related items
results = vector_db.search(
    query="budget-friendly portable computer",
    collection="products",
    limit=10
)
# Finds: "cheap laptop", "affordable notebook", "budget desktop", "entry-level PC"
مقارنة الأداء:
| نوع البحث | أذكر | رضا المستخدم | تعقيد التنفيذ |
|---|---|---|---|
| الكلمة الرئيسية (BM25) | 40-60% | منخفض | منخفض |
| الدلالي (المتجه) | 70-90% | عالية | متوسط |
| هجين (BM25 + ناقل) | 85-95% | عالية جدًا | عالية |
3. بحث متعدد الوسائط
البحث عبر أنواع البيانات المختلفة:
# Text-to-image search
text_vector = embed_text("sunset over mountains")
image_results = vector_db.search(text_vector, collection="images")

# Image-to-text search
image_vector = embed_image(uploaded_photo)
text_results = vector_db.search(image_vector, collection="descriptions")

# Image-to-image search (visual similarity)
product_image_vector = embed_image(product_photo)
similar_products = vector_db.search(product_image_vector, collection="products")
4. أنظمة التوصية
def recommend_items(user_id: str, n: int = 10):
    # Get user's embedding (from past behavior)
    user_vector = get_user_embedding(user_id)

    # Find similar items in vector space
    recs = vector_db.search(
        query=user_vector,
        collection="items",
        limit=n,
        with_payload=True
    )

    # Diversity re-ranking
    return diversify(recs, diversity_factor=0.3)
عمليات قاعدة بيانات المتجهات
إنشاء مجموعة وإدراج المتجهات
مثال Qdrant:
from qdrant_client import QdrantClient
from qdrant_client.models import VectorParams, Distance

client = QdrantClient("localhost", port=6333)

# Create collection with specific vector config
client.create_collection(
    collection_name="documents",
    vectors_config=VectorParams(
        size=1536,  # Matches text-embedding-3-small
        distance=Distance.COSINE  # or DOT, EUCLIDEAN
    ),
)

# Insert vectors with payload (metadata)
client.upsert(
    collection_name="documents",
    points=[
        {
            "id": "doc_001",
            "vector": [0.12, -0.45, ..., 0.78],  # 1536-dimensional
            "payload": {
                "title": "Remote Work Policy",
                "category": "HR",
                "author": "HR Team",
                "date": "2026-01-15",
                "chunk_index": 0,
                "text": "Employees may work remotely up to 3 days per week..."
            }
        },
        # ... more points
    ]
)
البحث المختلط مع المرشحات
# Semantic search with metadata filters
results = client.query_points(
    collection_name="documents",
    query=query_vector,
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="category",
                match=models.MatchValue(value="Engineering")
            ),
            models.FieldCondition(
                key="date",
                range=models.Range(gte="2025-01-01")
            ),
        ],
        should=[
            models.FieldCondition(
                key="author",
                match=models.MatchValue(value="Alice")
            ),
        ]
    ),
    limit=20,
    score_threshold=0.75  # Minimum similarity score
)
قاعدة بيانات المتجهات مقابل قاعدة البيانات التقليدية
| العملية | PostgreSQL | com.pgvector | قاعدة بيانات المتجهات المخصصة |
|---|---|---|---|
| بالضبط KNN | ❌ (مسح كامل) | ❌ (بطيء) | ✅ (عن طريق القوة الغاشمة) |
| بحث آن | ❌ | ✅ (IVFFlat، HNSW) | ✅ (الأمثل) |
| أكثر من 10 مليون ناقل | ✅ | ⚠️ يتدهور الأداء | ✅ |
| البث في الوقت الحقيقي | ✅ | ⚠️ | ✅ |
| البحث الهجين | ✅ (مرشحات SQL) | ✅ | ✅ |
| متعدد المستأجرين | ✅ (المخططات) | ✅ | ✅ (أصلي) |
| معاملات ACID | ✅ | ✅ | ⚠️ (محدودة) |
| استفسارات السفر عبر الزمن | ❌ | ❌ | ✅ (وال) |
التحديات والاعتبارات
لعنة الأبعاد
- الأبعاد الأعلى تجعل مقاييس المسافة أقل أهمية.
- تستخدم معظم نماذج التضمين الأبعاد 384-1536 — وهذا أمر يمكن التحكم فيه.
- بعد أبعاد عام 2000، فكر في تقليل الأبعاد (PCA، UMAP).
صيانة الفهرس
- يتطلب HNSW ذاكرة كبيرة (المتجهات + بنية الرسم البياني).
- يحتاج التلقيح الاصطناعي إلى إعادة تدريب دورية مع نمو البيانات.
- يقوم DiskANN باستبدال بعض السرعة بذاكرة أقل.
التكلفة
vector_database_pricing:
  pinecone:
    starter: "$70/month for 100K vectors"
    enterprise: "$2,000+/month for 10M+ vectors"
  self_hosted_qdrant:
    infrastructure: "$50-500/month (cloud VMs)"
    maintenance: "Operational overhead"
حداثة البيانات
- يتعارض الاستيعاب في الوقت الفعلي مع تحسين الفهرس.
- فهرسة الدُفعات للمتجهات الجديدة، وتزايدية للتحديثات.
- المفاضلة بين الحداثة وجودة البحث.
الاستنتاج
تعد قواعد بيانات المتجهات مكونًا مهمًا للبنية التحتية لتطبيقات الذكاء الاصطناعي:
- استخدمها عندما تحتاج إلى فهم دلالي، وليس مطابقة الكلمات الرئيسية.
- التطبيق القاتل هو RAG — حيث يعمل على تعزيز حاملي شهادات الماجستير ببيانات خاصة وحديثة.
- الاختيار على أساس الحجم — pgvector للمشروعات الصغيرة، Pinecone/Qdrant للإنتاج، Milvus للنطاق الضخم.
- ** البحث المختلط ** (المتجه + الكلمة الرئيسية + البيانات الوصفية) يوفر أفضل النتائج.
- اختيار نموذج التضمين مهم — اختبر نماذج مختلفة لحالة الاستخدام المحددة لديك.
يتطور مشهد قاعدة بيانات المتجهات بسرعة. ابدأ بشكل بسيط (pgvector أو Qdrant مفتوح المصدر)، وقم بقياس الأداء باستخدام بياناتك، ثم قم بالتوسيع حسب الحاجة.
مقالات مختارة
50 مهارة من Claude تستحق البناء في 2026
ابن مساعد ملاحظات خاص بالذكاء الاصطناعي
حوّل مجلد ملاحظات Markdown إلى مساعد بحث دون كشف المسودات الخاصة.
أتمتة استخراج بيانات الفواتير باستخدام OCR
ابن خط معالجة يقرأ الفواتير ويستخرج الحقول ويعلّم القيم غير المؤكدة للمراجعة.
التعليقات
0 تعليقاتلا توجد تعليقات معتمدة بعد. قد تنتظر الردود الجديدة المراجعة.