قواعد بيانات السلاسل الزمنية: إدارة البيانات التي تتغير بمرور الوقت
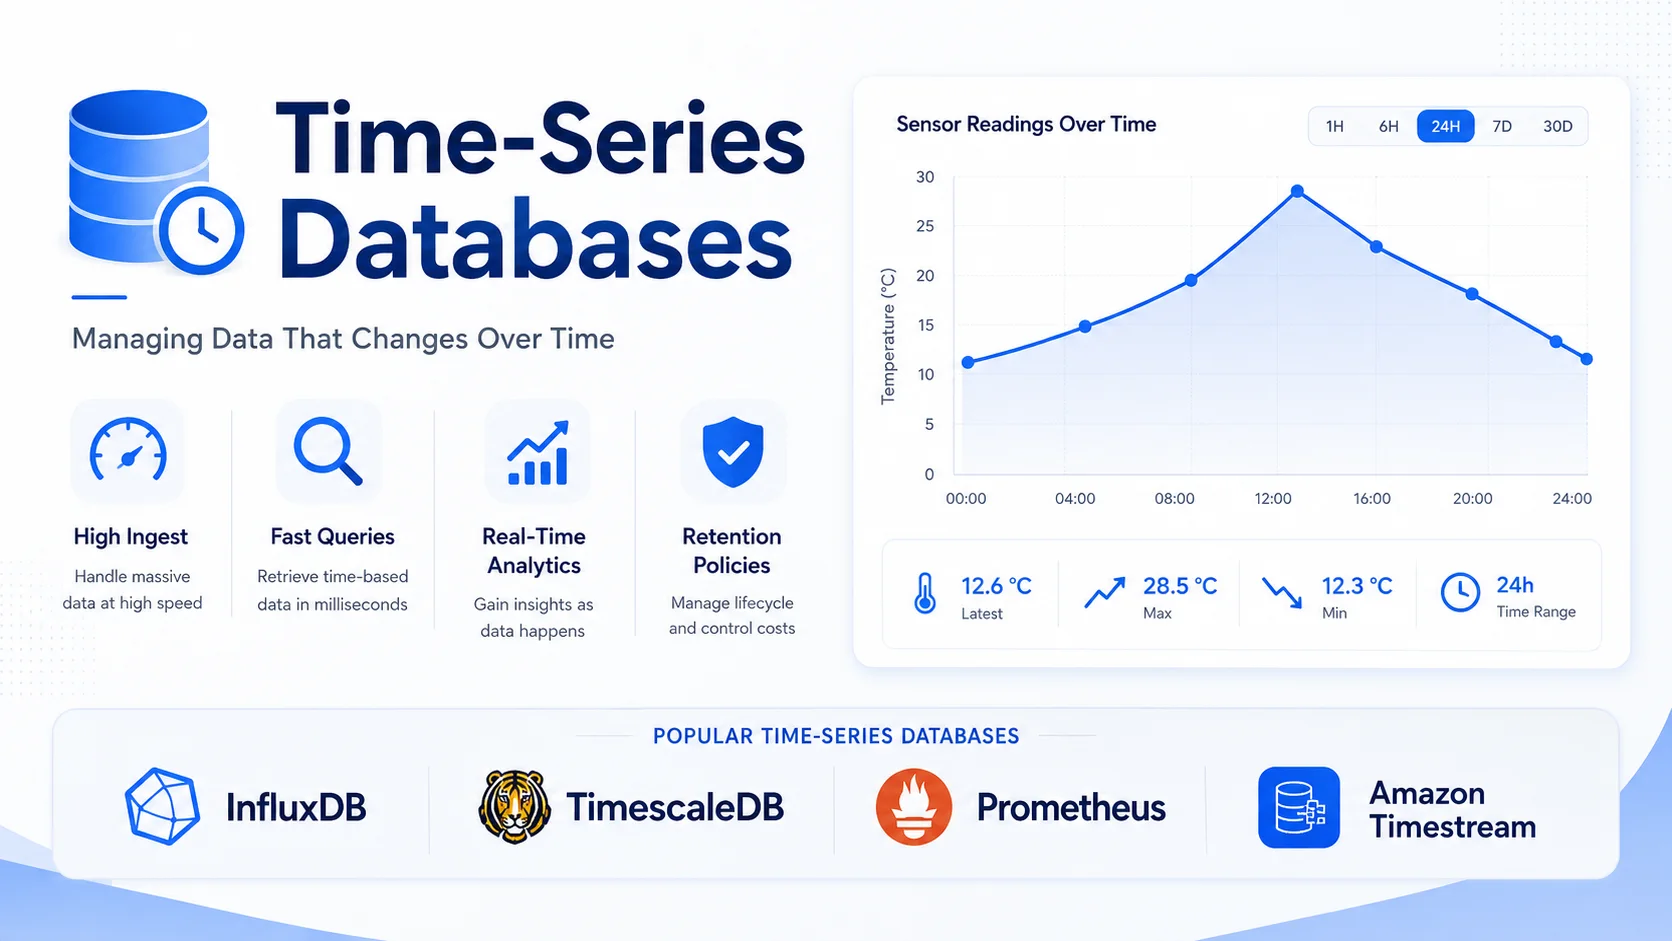
قاعدة بيانات السلاسل الزمنية (TSDB) متخصصة في تخزين نقاط البيانات المفهرسة حسب الوقت والاستعلام عنها - قراءات أجهزة الاستشعار، ومقاييس الخادم، وسجلات التطبيقات، وبيانات التجزئة المالية، وقياس إنترنت الأشياء عن بعد. تتميز بيانات السلاسل الزمنية بخصائص فريدة تجعل قواعد البيانات التقليدية دون المستوى الأمثل:
مقدمة
قاعدة بيانات السلاسل الزمنية (TSDB) متخصصة في تخزين نقاط البيانات المفهرسة حسب الوقت والاستعلام عنها - قراءات أجهزة الاستشعار، ومقاييس الخادم، وسجلات التطبيقات، وبيانات التجزئة المالية، وقياس إنترنت الأشياء عن بعد. تتميز بيانات السلاسل الزمنية بخصائص فريدة تجعل قواعد البيانات التقليدية دون المستوى الأمثل:
- الكتابة بكثافة — الملايين إلى المليارات من نقاط البيانات يوميًا.
- إلحاق فقط — نادرًا ما يتم تحديث البيانات، ويتم إلحاقها دائمًا تقريبًا.
- مرتبة بالوقت — تتضمن الاستعلامات دائمًا نطاقًا زمنيًا.
- المعتمد على الاحتفاظ — يتم في النهاية تلخيص البيانات القديمة أو حذفها.
- مُختزلة — يتم تخزين البيانات الأقدم بدقة أقل.
خصائص بيانات السلاسل الزمنية
نموذج البيانات
تحتوي كل نقطة بيانات للسلسلة الزمنية على:
| مكون | مثال | الوصف |
|---|---|---|
| ** الطابع الزمني ** | 2026-05-24T14:30:00Z | عندما تم أخذ القياس |
| القيمة | 42.5 | القيمة المقاسة |
| ** متري ** | cpu_usage | ما يتم قياسه |
| ** العلامات / التسميات ** | المضيف = web01، المنطقة = شرق الولايات المتحدة | البيانات الوصفية للتصفية |
Metric: cpu_usage{host="web01", region="us-east"}
┌─────────────────────┬───────┐
│ Timestamp           │ Value │
├─────────────────────┼───────┤
│ 2026-05-24T14:30:00 │ 42.5  │
│ 2026-05-24T14:30:01 │ 43.2  │
│ 2026-05-24T14:30:02 │ 41.8  │
│ ...                 │ ...   │
└─────────────────────┴───────┘
السلاسل الزمنية مقابل قواعد البيانات التقليدية
| العملية | PostgreSQL | TimescaleDB (PostgreSQL + TS) | إنفلوكس دي بي (TSDB) |
|---|---|---|---|
| ** كتابة الإنتاجية ** | 10 ألف صف/ثانية | 100K-1M صفوف/ثانية | 1M+ صفوف/ثانية |
| الاستعلام: متوسط ساعة واحدة × 5 دقائق | دقائق (مسح كامل) | الثواني (التجميع المستمر) | ثواني |
| التخزين | موجه نحو الصف | صف/عمود مختلط | موجه نحو العمود |
| ضغط | لا شيء افتراضيا | 90%+ (الضغط الأصلي) | 90%+ |
| سياسات الاحتفاظ | إدارة الأقسام يدوياً | تلقائي | تلقائي |
| ** تقليص البيانات ** | الاستعلامات اليدوية | المجاميع المستمرة | استعلامات الاختزال |
| ** دعم SQL ** | كامل | كامل (SQL) | محدود (تدفق/SQL) |
مقارنة قاعدة بيانات السلاسل الزمنية
| ميزة | TimescaleDB | InfluxDB | بروميثيوس | فيكتورياميتريكس | QuestDB |
|---|---|---|---|---|---|
| المحرك | ملحق PostgreSQL | محرك TS مخصص | مخصص على أساس السحب | محرك TS مخصص | عمودي |
| لغة الاستعلام | SQL | مزود/تدفق | PromQL | متوافق مع PromQL | SQL + التدفق |
| معدل الإقبال | 1 م +/ثانية | 1 م +/ثانية | 500 كيلو/ثانية | 1 م +/ثانية | 2 م+/ثانية |
| ضغط | 90-97% | 90+% | لا شيء | 90+% | 90+% |
| ** التجميع ** | عقدة متعددة (مقياس زمني) | المؤسسة | التقسيم الأصلي | أصلي | لا شيء |
| الاحتفاظ | تلقائي مع السياسات | تلقائي | شكلي | شكلي | دليل |
| ** المجاميع المستمرة ** | نعم (مواطن) | لا (مهمة منفصلة) | قواعد التسجيل | قواعد التسجيل | لا |
| الأفضل ل | مستخدمي SQL، البيانات التشغيلية | إنترنت الأشياء، DevOps | Kubernetes، السحابة الأصلية | مقاييس عالية المستوى | المالية، وعالية السرعة |
InfluxDB: TSDB المخصص
نموذج البيانات
# InfluxDB v3 — data model
from influxdb_client import InfluxDBClient, Point
from influxdb_client.client.write_api import SYNCHRONOUS

client = InfluxDBClient(url="http://localhost:8086", token="my-token")
write_api = client.write_api(write_options=SYNCHRONOUS)

# A point = measurement + tags + fields + timestamp
point = (
    Point("temperature")
    .tag("sensor", "sensor-001")
    .tag("location", "warehouse-a")
    .field("value", 23.5)
    .field("humidity", 65.2)
    .time(datetime.utcnow())
)

write_api.write(bucket="sensors", record=point)
الاستعلام
-- InfluxDB SQL (v3)
SELECT time, value
FROM temperature
WHERE sensor = 'sensor-001'
  AND time >= NOW() - INTERVAL '1 hour'
ORDER BY time DESC;

-- Aggregation with downsampling
SELECT time_bucket(INTERVAL '5 minutes', time) as bucket,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp
FROM temperature
WHERE location = 'warehouse-a'
  AND time >= NOW() - INTERVAL '24 hours'
GROUP BY bucket
ORDER BY bucket;
سياسات الاحتفاظ
-- InfluxDB: automatic data lifecycle
CREATE RETENTION POLICY "one_hour"
ON "sensors"
DURATION 1h
REPLICATION 1
DEFAULT;

CREATE RETENTION POLICY "one_week"
ON "sensors"
DURATION 168h
REPLICATION 1;

-- Create downsample task
CREATE TASK "downsample_1h" ON "sensors"
  EVERY 1 HOUR
  BEGIN
    -- Aggregate 1-minute data to 1-hour averages
    SELECT time_bucket(INTERVAL '1 hour', time) as time,
           AVG(value) as value
    INTO "one_week"."temperature_hourly"
    FROM "one_hour"."temperature"
    WHERE time >= NOW() - INTERVAL '2 hours'
    GROUP BY 1, sensor, location;
  END;
بروميثيوس: المراقبة السحابية الأصلية
الهندسة المعمارية (نموذج السحب)
┌─────────────────────────────────────────────────┐
│              Prometheus Server                   │
│  ┌──────────┐  ┌──────────┐  ┌───────────────┐  │
│  │ Retrieval│  │ TSDB     │  │ Alertmanager  │  │
│  │ (pull)   │──│ (storage)│──│ (alerts)      │  │
│  └─────┬────┘  └──────────┘  └───────────────┘  │
│        │                                          │
└────────┼──────────────────────────────────────────┘
         │
    ┌────┼────────────┬──────────────┐
    ▼    ▼            ▼              ▼
  App  App   Node Exporter   Custom Exporter
PromQL (لغة استعلام بروميثيوس)
# Basic queries
cpu_usage{host="web01"}
http_requests_total[5m]

# Rate (per-second average)
rate(http_requests_total[5m])

# Aggregation
avg by (host) (cpu_usage)

# Histogram quantile
histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))

# Predict linear regression
predict_linear(node_disk_free_bytes[1h], 3600) < 0

# Recording rule (pre-computed)
- record: job:http_requests:rate5m
  expr: rate(http_requests_total[5m])
اكتشاف الخدمة والأهداف
# prometheus.yml
scrape_configs:
  - job_name: 'kubernetes-nodes'
    kubernetes_sd_configs:
      - role: node
    relabel_configs:
      - source_labels: [__meta_kubernetes_node_label_kubernetes_io_role]
        regex: control-plane
        action: drop

  - job_name: 'custom-app'
    static_configs:
      - targets: ['app01:8080', 'app02:8080', 'app03:8080']
TimescaleDB: PostgreSQL للسلاسل الزمنية
يعد TimescaleDB امتدادًا لـ PostgreSQL الذي يضيف إمكانات السلاسل الزمنية مع الحفاظ على التوافق الكامل مع SQL.
جداول مفرطة
-- Create a hypertable (automatically partitions by time)
CREATE TABLE temperature (
    time TIMESTAMPTZ NOT NULL,
    sensor_id INTEGER,
    location TEXT,
    value DOUBLE PRECISION,
    humidity DOUBLE PRECISION
);

-- Convert to hypertable (partitions by 1 day chunks)
SELECT create_hypertable('temperature', 'time',
    chunk_time_interval => INTERVAL '1 day');

-- Add partitioning by location (optional, for multi-node)
SELECT add_dimension('temperature', 'location', number_partitions => 4);
ضغط
-- Enable compression on hypertable
ALTER TABLE temperature SET (
    timescaledb.compress,
    timescaledb.compress_segmentby = 'sensor_id',
    timescaledb.compress_orderby = 'time DESC'
);

-- Compression policy: compress data older than 7 days
SELECT add_compression_policy('temperature', INTERVAL '7 days');

-- Compression ratio: 90-97%
-- 100GB of raw data → 3-10GB compressed
المجاميع المستمرة (المشاهدات المادية)
-- Create 5-minute aggregates (refreshed every minute)
CREATE MATERIALIZED VIEW temperature_hourly
WITH (timescaledb.continuous) AS
SELECT time_bucket('5 minutes', time) as bucket,
       sensor_id,
       AVG(value) as avg_temp,
       MAX(value) as max_temp,
       MIN(value) as min_temp,
       stddev(value) as temp_stddev
FROM temperature
GROUP BY bucket, sensor_id;

-- Refresh policy
SELECT add_continuous_aggregate_policy('temperature_hourly',
    start_offset => INTERVAL '3 days',
    end_offset => INTERVAL '1 hour',
    schedule_interval => INTERVAL '1 minute');
الاحتفاظ بالبيانات
-- Automatic data removal
SELECT add_retention_policy('temperature_raw', INTERVAL '30 days');
SELECT add_retention_policy('temperature_hourly', INTERVAL '1 year');
SELECT add_retention_policy('temperature_daily', INTERVAL '5 years');
أنماط الاستعلام
الاختزال
-- Raw data: 1m intervals, kept 30 days
-- 5m average: kept 1 year
-- 1h average: kept 5 years

SELECT time_bucket('1 hour', time) as hour,
       AVG(value) as avg_temperature,
       PERCENTILE_CONT(0.95) WITHIN GROUP (ORDER BY value) as p95
FROM temperature
WHERE time >= NOW() - INTERVAL '7 days'
GROUP BY hour
ORDER BY hour;
الاستيفاء (سد الثغرات)
-- Fill missing data with linear interpolation
SELECT time_bucket('5 minutes', time) as bucket,
       INTERPOLATE(AVG(value)) as temperature
FROM temperature
WHERE sensor_id = 1
  AND time >= NOW() - INTERVAL '1 hour'
GROUP BY bucket
ORDER BY bucket;

-- Or use LAST observation carried forward (LOCF)
SELECT time_bucket('5 minutes', time) as bucket,
       LOCF(AVG(value)) as temperature
FROM temperature
GROUP BY bucket
ORDER BY bucket;
كشف الشذوذ
-- Detect values outside 3 standard deviations
WITH stats AS (
    SELECT AVG(value) as mean,
           stddev(value) as sigma
    FROM temperature
    WHERE time >= NOW() - INTERVAL '24 hours'
)
SELECT time, value,
       (value - mean) / sigma as z_score
FROM temperature, stats
WHERE time >= NOW() - INTERVAL '1 hour'
  AND ABS((value - mean) / sigma) > 3
ORDER BY time;
التخزين والضغط
كيف تحقق TSDBs ضغطًا عاليًا
Raw data layout (row-oriented):
time, sensor_id, location, value
14:30:00, 1, "room_a", 23.5
14:30:01, 1, "room_a", 23.6
14:30:02, 1, "room_a", 23.4
14:30:03, 1, "room_a", 23.7

Column-oriented + Delta encoding:
time:    14:30:00, +1s, +1s, +1s  → 1 value + 3 deltas
sensor_id: 1, 1, 1, 1 → run-length encoding: "1 × 4"
location: "room_a" × 4 → run-length encoding: "room_a × 4"
value: 23.5, +0.1, -0.2, +0.3 → delta encoding

Result: ~95% compression vs. raw text
نسب الضغط
| قاعدة البيانات | الخام | مضغوط | نسبة |
|---|---|---|---|
| TimescaleDB | 100 جيجابايت | 3-10 جيجابايت | 90-97% |
| InfluxDB | 100 جيجابايت | 5-15 جيجابايت | 85-95% |
| بروميثيوس | 100 جيجابايت | 20-25 جيجابايت | 75-80% |
| فيكتورياميتريكس | 100 جيجابايت | 3-8 جيجابايت | 92-97% |
حالات الاستخدام
1. مراقبة البنية التحتية
# Node exporter metrics collected every 15 seconds
metrics:
  - cpu_usage{host="web01", cpu="0"}
  - memory_used{host="web01", type="RAM"}
  - disk_io{host="web01", device="sda", type="read_bytes"}
  - network_bytes{host="web01", interface="eth0", direction="in"}
  - load_average{host="web01", duration="1m"}

storage:
  raw: 15s intervals, 7 days
  aggregated: 5m intervals, 30 days
  daily: 1h intervals, 1 year
2. بيانات مستشعر إنترنت الأشياء
# Millions of devices sending data every minute
from timescaledb import hypertable

sensors = hypertable('sensor_data', 'time',
    chunk_time='1 day',
    compression='7 days',
    retention='90 days'
)

# Query: average temperature per device per hour
query = """
    SELECT time_bucket('1 hour', time) as hour,
           device_id,
           AVG(temperature) as avg_temp,
           COUNT(*) as samples
    FROM sensor_data
    WHERE time >= NOW() - INTERVAL '24 hours'
    GROUP BY hour, device_id
"""
3. بيانات التجزئة المالية
-- Stock price ticks: 10M+ per day per instrument
CREATE TABLE ticks (
    time TIMESTAMPTZ NOT NULL,
    symbol TEXT NOT NULL,
    price DOUBLE PRECISION,
    volume BIGINT,
    bid DOUBLE PRECISION,
    ask DOUBLE PRECISION
);

SELECT create_hypertable('ticks', 'time',
    chunk_time_interval => INTERVAL '1 hour');

-- OHLC (Open-High-Low-Close) candlestick query
SELECT time_bucket('5 minutes', time) as bucket,
       symbol,
       FIRST(price, time) as open,
       MAX(price) as high,
       MIN(price) as low,
       LAST(price, time) as close,
       SUM(volume) as volume
FROM ticks
WHERE symbol = 'AAPL'
  AND time >= NOW() - INTERVAL '1 day'
GROUP BY bucket, symbol;
أفضل الممارسات
تصميم المخطط
-- Good schema: separate metrics by table
CREATE TABLE cpu_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);
CREATE TABLE memory_usage (time TIMESTAMPTZ, host TEXT, value DOUBLE PRECISION);

-- Avoid: single wide table with all metrics as columns
-- (leads to sparse data, poor compression)
ضبط حجم القطعة
-- Too small: too many partitions, slow queries
-- Too large: poor memory management, slow ingestion
-- Rule of thumb: each chunk should be 1-10GB compressed

-- For 1000 writes/sec, 1KB each = 86GB/day
-- 1 day chunks = 86GB (too large)
-- 6 hour chunks = 21GB (good)
SELECT set_chunk_time_interval('temperature', INTERVAL '6 hours');
الاستنتاج
تم تصميم قواعد بيانات السلاسل الزمنية خصيصًا للبيانات التي تنتجها الأنظمة الحديثة بمعظمها: القياسات ذات الطابع الزمني من التطبيقات والبنية التحتية وأجهزة إنترنت الأشياء والأسواق المالية.
| حالة الاستخدام | قاعدة البيانات الموصى بها |
|---|---|
| مراقبة البنية التحتية (Kubernetes) | بروميثيوس + فيكتورياميتريكس |
| بيانات مستشعر إنترنت الأشياء مع استعلامات SQL | TimescaleDB |
| التحليلات في الوقت الحقيقي، DevOps | InfluxDB |
| البيانات المالية عالية التردد | QuestDB |
| المقاييس السحابية الأصلية والمعتمدة على السحب | بروميثيوس |
الوجبات الرئيسية:
- تم تحسين وحدات TSDB للكتابة — تتعامل مع أكثر من مليون نقطة بيانات في الثانية على عقدة واحدة.
- ضغط عالي (90%+) — تخزين المزيد من البيانات بتكلفة أقل.
- دورة حياة البيانات التلقائية — تعمل سياسات الاحتفاظ + الاختزال على تقليل تكاليف التخزين.
- دعم SQL حيثما أمكن — يوفر TimescaleDB توافقًا كاملاً مع SQL.
- أدوات مختلفة لتلبية الاحتياجات المختلفة — Prometheus للسحابة الأصلية، وInfluxDB لـ DevOps، وTimescaleDB لمستخدمي SQL المتميزين.
تستوعب بنية السلاسل الزمنية الصحيحة البيانات بكفاءة، وتؤخرها بسلاسة، وتقوم بالاستعلام عنها على الفور - وتحول الأرقام ذات الطوابع الزمنية الأولية إلى رؤى قابلة للتنفيذ.
مقالات مختارة
50 مهارة من Claude تستحق البناء في 2026
ابن مساعد ملاحظات خاص بالذكاء الاصطناعي
حوّل مجلد ملاحظات Markdown إلى مساعد بحث دون كشف المسودات الخاصة.
أتمتة استخراج بيانات الفواتير باستخدام OCR
ابن خط معالجة يقرأ الفواتير ويستخرج الحقول ويعلّم القيم غير المؤكدة للمراجعة.
التعليقات
0 تعليقاتلا توجد تعليقات معتمدة بعد. قد تنتظر الردود الجديدة المراجعة.