جيل الاسترجاع المعزز (RAG): الهندسة المعمارية والأنماط والإنتاج
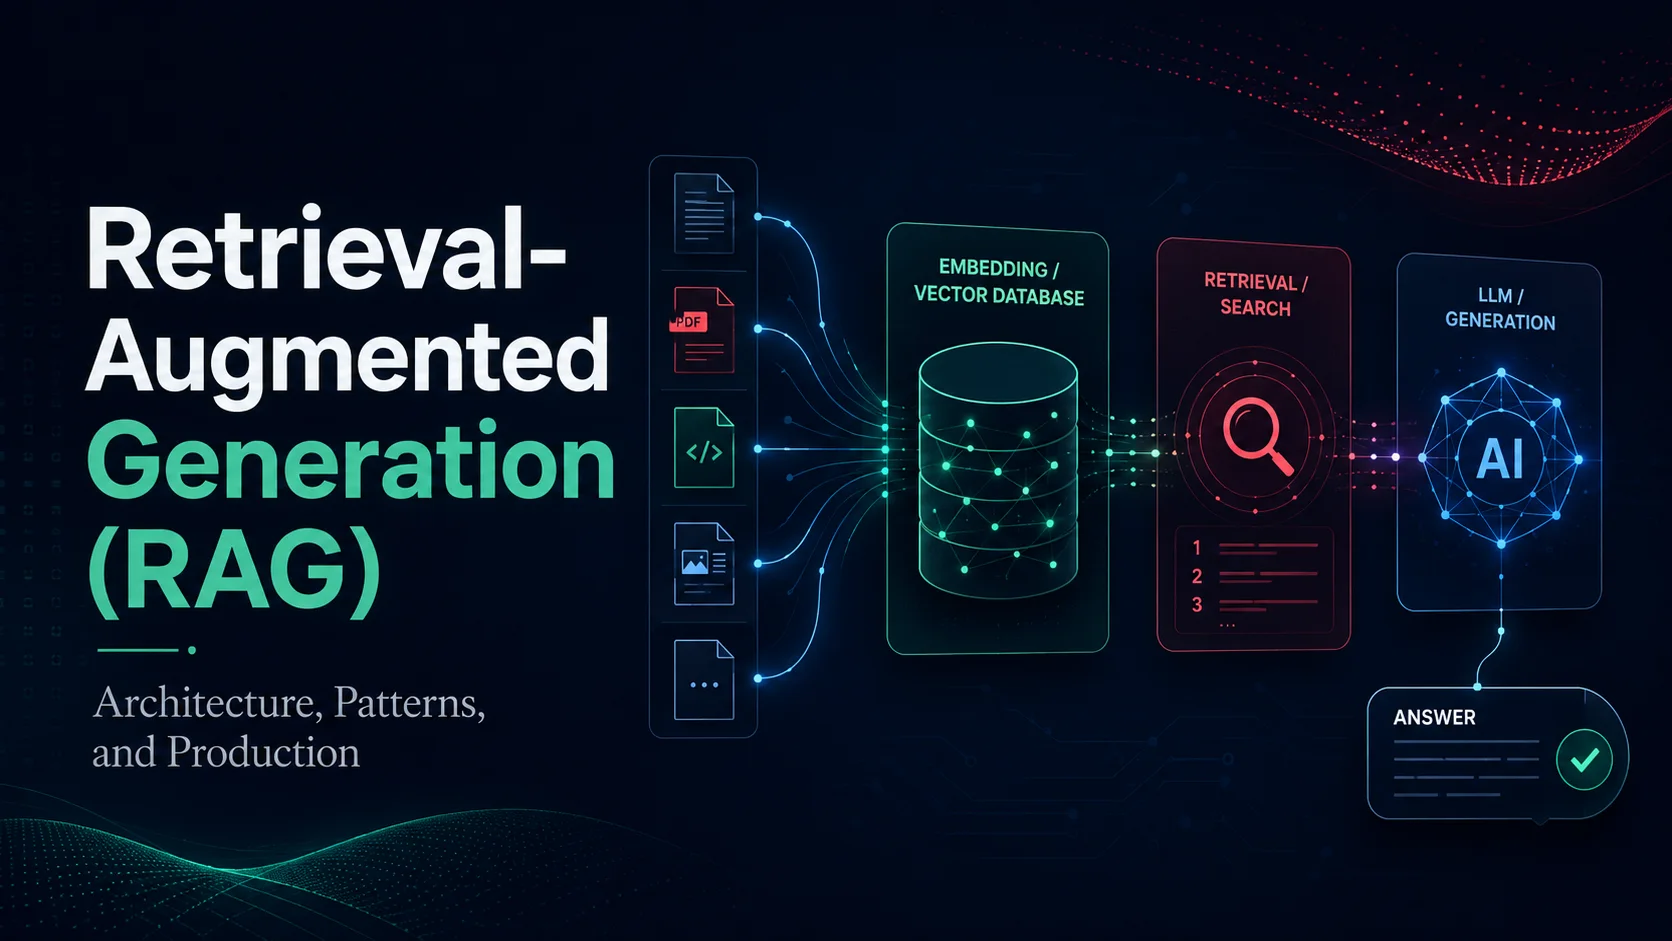
الجيل المعزز للاسترجاع (RAG) هو عبارة عن بنية ذكاء اصطناعي تجمع بين استرجاع المعلومات ونماذج اللغات الكبيرة (LLMs). بدلاً من الاعتماد فقط على بيانات تدريب LLM للحصول على الإجابات، يقوم RAG باسترداد المعلومات ذات الصلة من قاعدة المعرفة ويوفرها كسياق لـ LLM.
مقدمة
الجيل المعزز للاسترجاع (RAG) هو عبارة عن بنية ذكاء اصطناعي تجمع بين استرجاع المعلومات ونماذج اللغات الكبيرة (LLMs). بدلاً من الاعتماد فقط على بيانات تدريب LLM للحصول على الإجابات، يقوم RAG باسترداد المعلومات ذات الصلة من قاعدة المعرفة ويوفرها كسياق لـ LLM.
يحل هذا النهج ثلاثة قيود حرجة في LLM: المعرفة القديمة (قطع بيانات التدريب)، الهلوسة (اختلاق الحقائق)، والافتقار إلى الوصول إلى البيانات الخاصة (عدم معرفة مستنداتك الداخلية).
لماذا خرقة؟
قيود LLM وحلول RAG
| مشكلة | LLM بدون RAG | LLM مع RAG |
|---|---|---|
| قطع المعرفة | يعرف فقط البيانات حتى تاريخ التدريب | يسترد معلومات جديدة من قاعدة المعرفة |
| الهلوسة | قد يخترع الحقائق عندما يكون غير مؤكد | إجابات الأسباب في السياق المسترد |
| بيانات خاصة | لم ير المستندات الداخلية الخاصة بك | يبحث في قاعدة معارف المؤسسة |
| ** إسناد المصدر ** | لا يمكن ذكر المصادر | إرجاع الأجزاء الدقيقة مع الاستشهادات |
| التكلفة | الضبط الدقيق مكلف | لا حاجة لأي تدريب — فقط قم بفهرسة المستندات |
RAG مقابل الضبط الدقيق
| الجانب | خرقة | ضبط دقيق |
|---|---|---|
| تحديثات المعرفة | لحظة (تحديث ناقل DB) | أسابيع (نموذج إعادة التدريب) |
| ** تكلفة التدريب ** | لا شيء | 100 دولار - 10,000 دولار+ |
| مفاهيم جديدة | نعم - أضف إلى قاعدة المعرفة | لا - يتطلب إعادة التدريب |
| الوقاية من الهلوسة | جيد (تأريض السياق) | محدود (الحفظ) |
| ** إسناد المصدر ** | نعم | لا (الصندوق الأسود) |
| ** الكمون ** | العالي (استرجاع + توليد) | أقل (جيل فقط) |
| متى يستخدم | تحتاج إلى معلومات محدثة، والاستشهادات، والبيانات الخاصة | تحتاج إلى تغيير سلوك النموذج، والنغمة، وتنسيق الإخراج |
راج العمارة
تدفق عالي المستوى
                      ┌───────────────────────┐
                      │   Document Processing  │ (Ingestion Pipeline)
                      │   (Chunking → Embed)   │
                      └──────────┬────────────┘
                                 │
                                 ▼
                      ┌───────────────────────┐
                      │   Vector Database     │
                      │   (Knowledge Base)    │
                      └──────────┬────────────┘
                                 │
                      ┌──────────▼────────────┐
User Query ──────────►│   Retrieval Pipeline   │
                      │  (embed → search →     │
                      │   fetch chunks)        │
                      └──────────┬────────────┘
                                 │ (relevant chunks)
                                 ▼
                      ┌───────────────────────┐
                      │   Generation          │
                      │  (LLM + Context)      │
                      └──────────┬────────────┘
                                 │ (answer with citations)
                                 ▼
                           Final Answer
خط أنابيب الابتلاع
1. تحميل المستند
from langchain_community.document_loaders import (
    PDFLoader, TextLoader, CSVLoader,
    UnstructuredHTMLLoader, ConfluenceLoader
)

# Load various document types
loaders = {
    '.pdf': PDFLoader("policy.pdf"),
    '.txt': TextLoader("readme.txt"),
    '.html': UnstructuredHTMLLoader("page.html"),
    '.csv': CSVLoader("data.csv"),
}

documents = []
for ext, loader in loaders.items():
    documents.extend(loader.load())
2. استراتيجية التقطيع
يعد التقطيع أمرًا بالغ الأهمية - فالحجم الصغير جدًا يفقد السياق، والكبير جدًا يؤدي إلى تشويش:
from langchain.text_splitter import (
    RecursiveCharacterTextSplitter,
    TokenTextSplitter,
    SemanticChunker
)

# Recursive character splitting (most common)
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=200,
    separators=["\n\n", "\n", " ", ""],
    length_function=len,
)

# Semantic chunking (AI-aware — splits at topic boundaries)
semantic_splitter = SemanticChunker(
    embeddings=openai_embeddings,
    breakpoint_threshold_type="percentile",
)

chunks = text_splitter.split_documents(documents)
تقطيع الصفقات
| استراتيجية | حجم القطعة | أذكر | الدقة | أفضل ل |
|---|---|---|---|---|
| قطع صغيرة | 200-500 رمز | عالية | منخفض (مجزأ) | الأسئلة الشائعة، التعاريف |
| قطع متوسطة | 500-1500 رمز | متوسط | متوسط | الجنرال راج |
| قطع كبيرة | 1500-3000 رمز | منخفض | عالية | التلخيص |
| قطع دلالية | متغير | عالية | عالية | وثائق معقدة |
3. التضمين
from langchain_openai import OpenAIEmbeddings
from langchain_qdrant import QdrantVectorStore

embeddings = OpenAIEmbeddings(
    model="text-embedding-3-small",
    dimensions=1536,
)

vector_store = QdrantVectorStore.from_documents(
    documents=chunks,
    embedding=embeddings,
    url="http://localhost:6333",
    collection_name="knowledge_base",
)
خط أنابيب الاسترجاع
1. فهم الاستعلام
from langchain.llms import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

def rewrite_query(original_query: str) -> str:
    """Rewrite user query for better retrieval"""
    prompt = ChatPromptTemplate.from_messages([
        ("system", "You are a query rewriting assistant. "
         "Rewrite the user's question to be more specific "
         "and searchable in a knowledge base."),
        ("user", original_query),
    ])
    llm = ChatOpenAI(model="gpt-4o-mini")
    return llm.invoke(prompt).content

# Example:
# Original: "What about vacation?"
# Rewritten: "What is the company policy on paid vacation days,
#             including accrual rate and carry-over limits?"
2. استراتيجيات الاسترجاع
بحث تشابه بسيط:
results = vector_store.similarity_search_with_score(
    query=rewritten_query,
    k=5,
    score_threshold=0.75,
)
بحث مختلط (ناقل + كلمة رئيسية):
# BM25 keyword scores combined with vector similarity
from langchain.retrievers import BM25Retriever, EnsembleRetriever

bm25_retriever = BM25Retriever.from_documents(chunks, k=5)
vector_retriever = vector_store.as_retriever(search_kwargs={"k": 5})

# Weighted ensemble
ensemble_retriever = EnsembleRetriever(
    retrievers=[vector_retriever, bm25_retriever],
    weights=[0.7, 0.3],
)
استرجاع الاستعلام المتعدد:
def generate_sub_queries(query: str, n: int = 3) -> list[str]:
    """Generate multiple perspectives on the same query"""
    prompt = f"Generate {n} different versions of this query for search: {query}"
    response = llm.invoke(prompt)
    return response.content.split('\n')

sub_queries = generate_sub_queries("remote work policy")
# Returns:
# - "How many days per week can employees work from home?"
# - "Remote work eligibility and approval process"
# - "Company work-from-home policy and guidelines"

all_results = []
for q in sub_queries:
    all_results.extend(vector_store.similarity_search(q, k=3))
3. إعادة الترتيب
تحسين جودة الاسترجاع من خلال إعادة ترتيب النتائج باستخدام برنامج التشفير المتقاطع:
from sentence_transformers import CrossEncoder

reranker = CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')

pairs = [(query, result.page_content) for result in initial_results]
scores = reranker.predict(pairs)

reranked_results = [
    result for _, result in
    sorted(zip(scores, initial_results), key=lambda x: x[0], reverse=True)
]

# Take top 3 after reranking
final_context = reranked_results[:3]
خط أنابيب الجيل
هندسة النظام الفوري
rag_prompt = """You are a helpful assistant that answers questions based
on the provided context. Follow these rules:

1. Answer ONLY using information from the provided context.
2. If the context does not contain the answer, say
   "I don't have enough information to answer this question."
3. Do NOT make up or infer information not in the context.
4. Include citations in [Source: filename.pdf] format.
5. Be concise but thorough.
6. Format lists and tables using markdown when appropriate.

Context:
{context}

Question: {question}
Answer (with citations):"""
الجيل مع الاقتباسات
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

qa_chain = RetrievalQA.from_chain_type(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    chain_type="stuff",  # "stuff" = put all context in one prompt
    retriever=vector_store.as_retriever(search_kwargs={"k": 5}),
    chain_type_kwargs={
        "prompt": PromptTemplate.from_template(rag_prompt),
        "verbose": True,
    },
    return_source_documents=True,
)

result = qa_chain.invoke({"query": "What is the vacation policy?"})

print(result['result'])
# "Employees accrue 15 days of paid vacation per year (accrued monthly
# at 1.25 days/month). Unused days may carry over up to 5 days to the
# next calendar year. [Source: HR_Handbook_2026.pdf]"

print(result['source_documents'])
# [Document(page_content="...", metadata={"source": "HR_Handbook_2026.pdf", ...})]
أنماط RAG المتقدمة
1. خرقة متعددة القفزات
بالنسبة للأسئلة التي تتطلب معلومات من مستندات متعددة:
Q: "Which products are affected by the new regulation and who needs training?"

Step 1: Retrieve regulation document → identifies affected product categories
Step 2: Use product list to query training documents
Step 3: Compose answer from both sources
2. وكيل RAG
استخدم وكيل LLM للتخطيط للاسترجاع وتحديد الأدوات التي سيتم استخدامها وتكرارها:
from langchain.agents import AgentExecutor, create_openai_functions_agent
from langchain.tools import Tool

retrieval_tool = Tool(
    name="search_knowledge_base",
    func=lambda q: vector_store.similarity_search(q, k=3),
    description="Search company knowledge base for policies and procedures"
)

calculator_tool = Tool(
    name="calculator",
    func=lambda expr: eval(expr),
    description="Perform mathematical calculations"
)

agent = create_openai_functions_agent(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    tools=[retrieval_tool, calculator_tool],
    prompt=agent_prompt,
)
agent_executor = AgentExecutor(agent=agent, tools=[retrieval_tool, calculator_tool])
3. خرقة ذاتية الانعكاس (Self-RAG)
يتحقق النموذج من جودة الاسترجاع والتوليد الخاصة به:
def self_rag(query: str) -> str:
    # 1. Retrieve
    docs = retrieve(query, k=5)

    # 2. Check: is retrieved info relevant?
    relevance_score = check_relevance(query, docs)

    if relevance_score < 0.7:
        return "I cannot find relevant information to answer this question."

    # 3. Generate answer
    answer = generate(query, docs)

    # 4. Check: does answer match retrieved info?
    faithfulness_score = check_faithfulness(answer, docs)

    if faithfulness_score < 0.8:
        return generate_with_constraints(query, docs)  # Regenerate

    # 5. Check: is answer useful?
    usefulness_score = check_usefulness(query, answer)

    return answer
4. RAG التصحيحية (CRAG)
يسترد ويقيم ويصحح قبل الإنشاء:
def corrective_rag(query):
    # Initial retrieval
    docs = retrieve(query)

    # Evaluate retrieval quality
    quality = evaluate_retrieval(query, docs)

    if quality == "excellent":
        # Direct generation
        return generate(query, docs)

    elif quality == "partial":
        # Re-rank and try again
        docs = rerank_and_retry(query, docs)
        return generate(query, docs)

    else:  # poor
        # Try web search or generate without context
        if web_search_available:
            docs = web_search(query)
            return generate(query, docs)
        else:
            return generate_without_context(query)
اعتبارات RAG للإنتاج
مقاييس التقييم
| متري | ما يقيسه | الهدف |
|---|---|---|
| التذكير بالاسترجاع | هل وجدنا جميع القطع ذات الصلة؟ | > 0.90 |
| دقة السياق | هل القطع المستردة ذات صلة بالفعل؟ | > 0.85 |
| ** الإخلاص ** | هل تبقى الإجابة مطابقة للسياق؟ | > 0.95 |
| ** أهمية الإجابة ** | هل الإجابة تعالج الاستعلام؟ | > 0.90 |
| ** معدل الهلوسة ** | نسبة الحقائق الملفقة | < 1% |
المراقبة
class RAGMonitor:
    def __init__(self):
        self.metrics = {
            'retrieval_latency': [],
            'generation_latency': [],
            'context_token_count': [],
            'completion_token_count': [],
        }

    def log_query(self, query: str, retrieval_time: float,
                  gen_time: float, context: str, response: str):
        self.metrics['retrieval_latency'].append(retrieval_time)
        self.metrics['generation_latency'].append(gen_time)
        # Track context size — too large = expensive, too small = poor quality
        self.metrics['context_token_count'].append(count_tokens(context))
        # Log for later analysis
        log_to_db(query, response, context)

    def alert_if_degraded(self):
        avg_latency = mean(self.metrics['generation_latency'][-100:])
        if avg_latency > 5.0:  # seconds
            alert_pagerduty("RAG generation latency degraded")
ميزانية الكمون
Total RAG latency: 1.5-4 seconds
├── Query embedding:      100-300ms
├── Vector search:         50-200ms
├── Reranking:            100-300ms
├── Context formatting:    10-50ms
└── LLM generation:      1000-3000ms (depends on output length)
أفضل ممارسات التقطيع والفهرسة
| ممارسة | لماذا | التنفيذ |
|---|---|---|
| ** تخزين البيانات الوصفية ** | التصفية، المصدر، الاستشهادات | اسم ملف المتجر، رقم الصفحة، عنوان القسم، التاريخ |
| ** تقطيع الوالدين والطفل ** | استرجاع الأجزاء الصغيرة، وإرجاع السياق الكبير | تخزين قطع صغيرة للبحث، وربطها بالأصل للجيل |
| ملخص الوثيقة | السياق العالمي للأسئلة واسعة النطاق | قم بتخزين ملخص واحد لكل مستند، واستخدمه للتصفية الأولية |
| إلغاء المحتوى | تجنب السياق الزائد | قطع التجزئة، وإزالة التكرارات القريبة |
| الإصدار | تتبع تحديثات المستند | إضافة حقل الإصدار إلى البيانات التعريفية، ودعم التراجع |
الاستنتاج
RAG هي الطريقة الأكثر عملية لنشر LLMs بمعرفة دقيقة وحديثة ومنسوبة. الوجبات الرئيسية:
- RAG > الضبط الدقيق لمعظم حالات الاستخدام - أرخص وأكثر مرونة وقابلية للتحديث.
- جودة التقطيع تحدد جودة RAG — استثمر الوقت في العثور على الإستراتيجية الصحيحة.
- البحث المختلط يتفوق على المتجه النقي — ادمجه مع الكلمة الرئيسية لتحسين التذكر.
- إعادة الترتيب تستحق الخطوة الإضافية — تعمل على تحسين جودة النتائج بشكل ملحوظ.
- مراقبة التدهور — تتغير جودة الاسترجاع مع إضافة المستندات.
- ابدأ بسيطًا، وأضف التعقيد حسب الحاجة — يعمل RAG الأساسي بشكل جيد؛ الأنماط المتقدمة تحل مشاكل محددة.
يتطور RAG بسرعة - مع المتغيرات الفاعلية والانعكاسية والتصحيحية التي تدفع حدود ما يمكن أن تحققه أنظمة الاسترجاع المعززة.
مقالات مختارة
50 مهارة من Claude تستحق البناء في 2026
ابن مساعد ملاحظات خاص بالذكاء الاصطناعي
حوّل مجلد ملاحظات Markdown إلى مساعد بحث دون كشف المسودات الخاصة.
أتمتة استخراج بيانات الفواتير باستخدام OCR
ابن خط معالجة يقرأ الفواتير ويستخرج الحقول ويعلّم القيم غير المؤكدة للمراجعة.
التعليقات
0 تعليقاتلا توجد تعليقات معتمدة بعد. قد تنتظر الردود الجديدة المراجعة.