هندسة البيانات والبيانات الضخمة
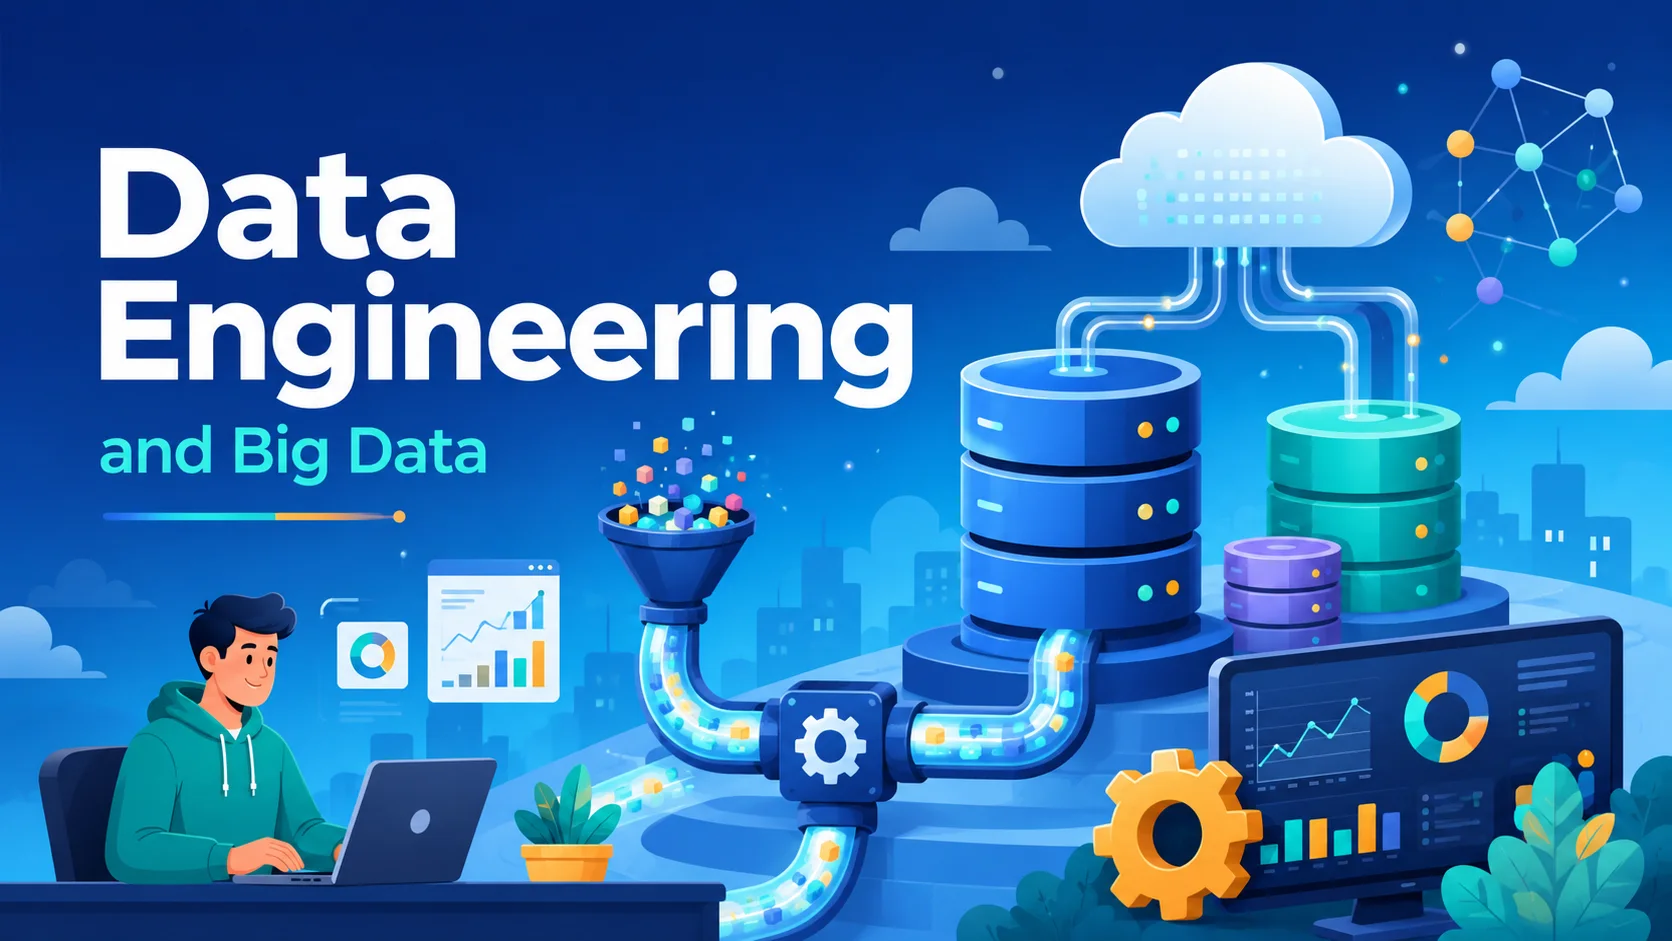
هندسة البيانات هي ممارسة تصميم وبناء وصيانة الأنظمة التي تقوم بجمع البيانات وتخزينها ومعالجتها وتحليلها على نطاق واسع. بينما يركز علماء البيانات على استخلاص الرؤى، يقوم مهندسو البيانات ببناء بنية تحتية موثوقة وقابلة للتطوير تجعل هذه الرؤى ممكنة.
مقدمة
هندسة البيانات هي ممارسة تصميم وبناء وصيانة الأنظمة التي تقوم بجمع البيانات وتخزينها ومعالجتها وتحليلها على نطاق واسع. بينما يركز علماء البيانات على استخلاص الرؤى، يقوم مهندسو البيانات ببناء بنية تحتية موثوقة وقابلة للتطوير تجعل هذه الرؤى ممكنة.
في عام 2026، سيكون مهندسو البيانات بمثابة العمود الفقري للمؤسسات التي تعتمد على البيانات. إنهم يبنون خطوط الأنابيب التي تدعم نماذج التعلم الآلي، ولوحات معلومات ذكاء الأعمال، والتحليلات في الوقت الفعلي، وإعداد التقارير التشغيلية.
خط أنابيب هندسة البيانات
الهندسة المعمارية من النهاية إلى النهاية
┌─────────┐   ┌──────────┐   ┌──────────┐   ┌─────────────┐   ┌─────────┐
│  Data   │   │  Data    │   │  Data    │   │  Data       │   │  Data   │
│ Sources │──▶│ Ingest   │──▶│ Storage  │──▶│ Transform   │──▶│ Serving │
├─────────┤   ├──────────┤   ├──────────┤   ├─────────────┤   ├─────────┤
│ Apps    │   │ Kafka    │   │ Data Lake│   │ dbt, Spark  │   │ BI      │
│ DBs     │   │ Kinesis  │   │ Warehouse│   │ Airflow     │   │ ML      │
│ APIs    │   │ Airbyte  │   │ Lakehouse│   │ Flink       │   │ Reverse │
│ Logs    │   │ Fivetran │   │          │   │             │   │ ETL     │
│ IoT     │   │ Pub/Sub  │   │          │   │             │   │ API     │
└─────────┘   └──────────┘   └──────────┘   └─────────────┘   └─────────┘
1. استيعاب البيانات
استيعاب الدفعة
تحميل البيانات وفقا لجدول زمني (كل ساعة، يوميا):
# Airflow DAG — Daily ETL
dag_id: daily_orders_import
schedule: "0 2 * * *"  # Daily at 2 AM
tasks:
  - extract_from_postgres:
      sql: >
        COPY orders TO '/tmp/orders_export.csv'
        WITH (FORMAT CSV, HEADER true)
        WHERE created_at >= CURRENT_DATE - 1

  - load_to_s3:
      source: /tmp/orders_export.csv
      destination: s3://data-lake/raw/orders/{{ ds }}/

  - load_to_snowflake:
      table: staging.orders
      file: s3://data-lake/raw/orders/{{ ds }}/*
      warehouse: etl_wh
استيعاب الدفق
معالجة البيانات في الوقت الحقيقي:
# Kafka producer — Sending order events
from kafka import KafkaProducer
import json

producer = KafkaProducer(
    bootstrap_servers=['kafka:9092'],
    value_serializer=lambda v: json.dumps(v).encode('utf-8'),
    acks='all'
)

def on_order_placed(order):
    future = producer.send('orders', order)
    future.get(timeout=10)  # Wait for acknowledgment
    print(f"Order {order['id']} sent")
# Kafka consumer — Processing stream
from kafka import KafkaConsumer

consumer = KafkaConsumer(
    'orders',
    bootstrap_servers=['kafka:9092'],
    group_id='order-processors',
    auto_offset_reset='earliest',
    enable_auto_commit=False
)

for message in consumer:
    order = json.loads(message.value)
    process_order(order)
    consumer.commit()  # Manual commit for reliability
أدوات الاستيعاب
| أداة | اكتب | أفضل ل |
|---|---|---|
| أباتشي كافكا | تيار | إنتاجية عالية، وتدفق الأحداث |
| ** أباتشي إيربايت ** | إلت | مفتوح المصدر، أكثر من 200 موصل |
| فيفيتران | ادارة العلاقات مع اي ال تي | موصلات مُدارة ولا تحتاج إلى صيانة |
| حركية AWS | تيار | النظام البيئي AWS |
| جوجل بوب/سوب | تيار | النظام البيئي لبرنامج Google Cloud Platform |
| مراكز أحداث Azure | تيار | النظام البيئي اللازوردي |
| ** غرزة ** | ادارة العلاقات مع اي ال تي | أحجام بيانات بسيطة وصغيرة إلى متوسطة |
| ديبيزيوم | مركز السيطرة على الأمراض | تغيير قاعدة البيانات التقاط البيانات |
2. تخزين البيانات
مقارنة أنظمة التخزين
| النظام | أفضل ل | نوع الاستعلام | المخطط | التحجيم |
|---|---|---|---|---|
| بحيرة البيانات (S3، ADLS، GCS) | البيانات الأولية، بأي شكل من الأشكال | على مستوى الملف | مخطط على القراءة | لانهائي |
| مستودع البيانات (Snowflake، BigQuery، Redshift) | التحليلات المنظمة | SQL | مخطط عند الكتابة | مرن |
| Lakehouse (Databricks، Iceberg) | مل + بي | SQL + شرارة | تطور المخطط | مرن |
| NoSQL (DynamoDB، MongoDB، كاساندرا) | الكمون المنخفض، وشبه منظم | القيمة الرئيسية، الوثيقة | مرنة | أفقي |
اختيار التخزين المناسب
data_storage_strategy:
  # Raw data — never transformed
  raw_layer: s3://data-lake/raw/  (Parquet format)

  # Cleaned and validated data
  staging_layer: s3://data-lake/staging/  (Delta Lake)

  # Business-ready, modeled data
  curated_layer: snowflake.prod.*

  # Real-time operational data
  operational: dynamodb-transactions

  # ML features
  feature_store: feast-feature-store

  # Data sharing
  analytics: looker-explores
مكدس البيانات الحديثة
┌─────────────────────────────────────────────┐
│              Data Sources                    │
│  Postgres  │  Shopify  │  Stripe  │  GA4    │
└──────┬──────────┬──────────┬────────┬───────┘
       │          │          │        │
       ▼          ▼          ▼        ▼
┌─────────────────────────────────────────────┐
│           Ingestion (Fivetran / Airbyte)     │
├─────────────────────────────────────────────┤
│         Storage (Snowflake / BigQuery)       │
├─────────────────────────────────────────────┤
│         Transformation (dbt)                 │
├─────────────────────────────────────────────┤
│         BI (Looker / Metabase)               │
├─────────────────────────────────────────────┤
│         Reverse ETL (Hightouch / Census)    │
└─────────────────────────────────────────────┘
3. تحويل البيانات
ETL مقابل ELT
| الجانب | ETL (تقليدي) | تدريس اللغة الإنجليزية (حديث) |
|---|---|---|
| النظام | استخراج → تحويل → تحميل | استخراج → تحميل → تحويل |
| حساب الموقع | خادم ETL منفصل | مستودع البيانات/البحيرة |
| المخطط | تحويل قبل التحميل | تحويل بعد التحميل |
| المرونة | من الصعب تغيير التحولات | من السهل التكرار |
| التخزين | منظم فقط | البيانات الأولية المتاحة |
| أدوات | المعلوماتية، تالند | دي بي تي، سبارك، SQL |
dbt (أداة بناء البيانات)
dbt هو المعيار الصناعي للتحويلات المستندة إلى SQL في مكدس البيانات الحديثة:
-- models/staging/stg_orders.sql
-- Stage raw orders data
with source as (
    select * from {{ source('shopify', 'orders') }}
),

renamed as (
    select
        id as order_id,
        created_at,
        customer_id,
        total_price::decimal(10,2) as total_amount,
        financial_status,
        fulfillment_status,
        currency
    from source
    where _fivetran_deleted = false  -- Handle soft deletes
)

select * from renamed
-- models/marts/order_summary.sql
-- Business-ready order metrics
with orders as (
    select * from {{ ref('stg_orders') }}
),

customer_totals as (
    select
        customer_id,
        count(*) as total_orders,
        sum(total_amount) as lifetime_value,
        min(created_at) as first_order_date,
        max(created_at) as most_recent_order_date,
        datediff('month', min(created_at), current_date) as customer_tenure_months
    from orders
    group by 1
)

select
    *,
    lifetime_value / nullif(customer_tenure_months, 0) as avg_monthly_value,
    case
        when total_orders = 1 then 'new'
        when total_orders between 2 and 5 then 'regular'
        when total_orders > 5 then 'loyal'
    end as customer_segment
from customer_totals
# dbt_project.yml
name: ecommerce_analytics
version: 1.0
profile: snowflake

models:
  ecommerce_analytics:
    staging:
      +materialized: view
      +schema: staging
    marts:
      +materialized: table
      +schema: analytics
      +incremental_strategy: merge
      +unique_key: order_id
اختبارات جودة البيانات (ديسيبل)
# schema.yml — Data quality tests
version: 2
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - unique
          - not_null
      - name: total_amount
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0
              max_value: 1000000
      - name: financial_status
        tests:
          - accepted_values:
              values:
                - pending
                - authorized
                - paid
                - refunded
                - cancelled

  - name: order_summary
    tests:
      - dbt_utils.expression_is_true:
          expression: "total_orders >= 1"

    columns:
      - name: customer_id
        tests:
          - relationships:
              to: ref('stg_customers')
              field: customer_id
4. تنسيق سير العمل
أدوات التنسيق تدير التبعيات والجدولة:
أباتشي تدفق الهواء
# dags/data_pipeline.py
from airflow import DAG
from airflow.operators.python import PythonOperator
from airflow.providers.snowflake.operators.snowflake import SnowflakeOperator
from datetime import datetime, timedelta

default_args = {
    'owner': 'data_engineering',
    'depends_on_past': False,
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}

with DAG(
    'daily_data_pipeline',
    default_args=default_args,
    description='Main ETL pipeline for analytics',
    schedule_interval='0 6 * * *',  # 6 AM daily
    start_date=datetime(2024, 1, 1),
    catchup=False,
    tags=['production']
) as dag:

    # Task 1: Extract from source databases
    extract_orders = PythonOperator(
        task_id='extract_orders',
        python_callable=extract_from_postgres,
    )

    # Task 2: Load to staging
    load_raw_orders = SnowflakeOperator(
        task_id='load_raw_orders',
        sql='COPY INTO raw.orders FROM @s3_stage',
    )

    # Task 3: Transform with dbt
    run_dbt_transform = BashOperator(
        task_id='run_dbt',
        bash_command='cd /app/dbt && dbt run --models marts',
    )

    # Task 4: Data quality checks
    run_tests = BashOperator(
        task_id='run_tests',
        bash_command='cd /app/dbt && dbt test',
    )

    # Dependencies
    extract_orders >> load_raw_orders >> run_dbt_transform >> run_tests
مراقبة خطوط البيانات
# Data freshness monitoring
def check_freshness(table: str, max_hours: int):
    query = f"""
        SELECT MAX(loaded_at) as last_updated
        FROM monitoring.table_metadata
        WHERE table_name = '{table}'
    """
    result = run_query(query)
    hours_since_update = (datetime.now() - result['last_updated']).total_seconds() / 3600

    if hours_since_update > max_hours:
        alert_pagerduty(f"DATA FRESHNESS: {table} is {hours_since_update:.1f}h stale")
5. خدمة البيانات
أدوات ذكاء الأعمال
| أداة | اكتب | أفضل ل |
|---|---|---|
| الناظر | ادارة العلاقات مع | المؤسسات الكبيرة، طبقة نمذجة LookML |
| لوحة | سطح المكتب/ادارة العلاقات مع | التحليلات البصرية، الخدمة الذاتية |
| ** الطاقة بي ** | مايكروسوفت النظام البيئي | التكامل مع مكتب 365 |
| قاعدة التعريف | مفتوح المصدر | تحليلات بسيطة ومستضافة ذاتيًا |
| ** المجموعة الشاملة ** | مفتوح المصدر | السحابة الأصلية، بايثون |
عكس إي تي إل
إرسال البيانات المحولة مرة أخرى إلى أنظمة التشغيل:
# Census reverse ETL configuration
syncs:
  - name: customer_segments_to_hubspot
    source: snowflake.analytics.customer_segments
    destination: hubspot
    mapping:
      - source_column: email
        destination_field: email
      - source_column: customer_segment
        destination_field: lifecycle_stage
      - source_column: lifetime_value
        destination_field: hsf_calculated_amount
    schedule: every 6 hours
متجر الميزات لـ ML
# Feast feature store — Define features
from datetime import timedelta
from feast import FeatureView, Entity, Field
from feast.types import Float32, Int32

customer = Entity(
    name='customer_id',
    value_type=Int32,
    description='Customer identifier'
)

customer_features = FeatureView(
    name='customer_features',
    entities=['customer_id'],
    ttl=timedelta(days=90),
    schema=[
        Field(name='total_orders', dtype=Int32),
        Field(name='lifetime_value', dtype=Float32),
        Field(name='avg_order_value', dtype=Float32),
        Field(name='days_since_last_order', dtype=Int32),
        Field(name='churn_risk_score', dtype=Float32),
    ],
    source=BigQuerySource(
        query="SELECT * FROM analytics.customer_features",
    ),
)
معالجة البيانات الكبيرة
أباتشي سبارك
from pyspark.sql import SparkSession
from pyspark.sql.functions import *

spark = SparkSession.builder \
    .appName("CustomerAnalytics") \
    .config("spark.sql.adaptive.enabled", "true") \
    .getOrCreate()

# Read from data lake
df = spark.read.parquet("s3://data-lake/raw/orders/*/*.parquet")

# Transform
aggregated = df \
    .filter(col("created_at") >= "2024-01-01") \
    .groupBy("customer_id") \
    .agg(
        count("order_id").alias("total_orders"),
        sum("total_amount").alias("lifetime_value"),
        avg("total_amount").alias("avg_order_value"),
        max("created_at").alias("last_order_date")
    ) \
    .withColumn("segment",
        when(col("total_orders") >= 10, "VIP")
        .when(col("total_orders") >= 3, "Regular")
        .otherwise("New")
    )

# Write to warehouse
aggregated.write \
    .mode("overwrite") \
    .format("delta") \
    .save("s3://data-lake/curated/customer_segments/")
المعالجة الدفعية مقابل المعالجة الدفقية
| الجانب | دفعة | الجري |
|---|---|---|
| ** الكمون ** | دقائق إلى ساعات | من الثانية إلى الدقائق |
| حجم البيانات | تيرابايت + لكل تشغيل | مستمر، بلا حدود |
| المعالجة | مجموعات البيانات المحدودة | تيارات لا نهاية لها |
| الدولة | عديم الجنسية لكل دفعة | الحالة (النافذة، الانضمامات) |
| ** التعقيد ** | أقل | أعلى (مرة واحدة بالضبط، العلامات المائية) |
| التكلفة | أقل (يمكن أن تنفجر) | أعلى (يعمل دائمًا) |
| التسامح مع الخطأ | إعادة تشغيل الدفعة الفاشلة | نقاط التفتيش، لقطات الدولة |
| حالات الاستخدام | التقارير اليومية | لوحات المعلومات والتنبيهات في الوقت الحقيقي |
حوكمة البيانات
كتالوج البيانات
# DataHub metadata
entities:
  - name: orders
    description: Customer order transactions
    ownership:
      - owner: data-engineering@company.com
        type: TECHNICAL_OWNER
      - owner: analytics@company.com
        type: BUSINESS_OWNER
    tags:
      - pii: false
      - classification: internal
      - sla: 99.9% uptime
    schema:
      - column: email
        type: string
        description: Customer email
        tags: [pii, sensitive]
نسب البيانات
تتبع كيفية تدفق البيانات من المصدر إلى لوحة المعلومات:
orders (Postgres)
  └─► stg_orders (dbt view)
       └─► order_summary (dbt table)
            └─► customer_360 (dbt table)
                 ├─► customer_segments (feature store)
                 └─► revenue_dashboard (Looker)
مهارات هندسة البيانات
| منطقة المهارة | التقنيات |
|---|---|
| ** البرمجة ** | بايثون، SQL، جافا/سكالا |
| التنسيق | تدفق الهواء، داغستر، المحافظ |
| ** معالجة الدفق ** | كافكا، فلينك، سبارك ستريمنج |
| تخزين البيانات | ندفة الثلج، BigQuery، التحول نحو الأحمر |
| بحيرات البيانات | S3، بحيرة دلتا، جبل الجليد |
| ** التحول ** | دي بي تي، سبارك |
| ** البنية التحتية ** | دوكر، كوبيرنيتيس، تيرافورم |
| الرصد | بروميثيوس، جرافانا، داتا دوج |
| جودة البيانات | توقعات عظيمة، اختبارات dbt |
| CI/CD | إجراءات جيثب، GitLab CI |
الاستنتاج
هندسة البيانات هي أساس المنظمة القائمة على البيانات. المبادئ الأساسية:
- الموثوقية أولاً — يجب أن تتعافى خطوط الأنابيب من حالات الفشل تلقائيًا.
- جودة البيانات هي مسؤولية الجميع — قم بإجراء الاختبار مبكرًا، وقم بإجراء الاختبار بشكل متكرر.
- اختر الأداة المناسبة — دفعة للتحليل التاريخي، والبث في الوقت الفعلي.
- التحديث تدريجيًا — اعتماد مكدس البيانات الحديث مكونًا واحدًا في كل مرة.
- توثيق كل شيء — تعتبر كتالوجات البيانات والنسب والملكية ضرورية على نطاق واسع.
يبني أفضل مهندسي البيانات أنظمة مملة وموثوقة ويمكن التنبؤ بها وسهلة الصيانة. استثمر في المراقبة والاختبار والتوثيق، وسوف يتناسب نظام البيانات الخاص بك مع مؤسستك.
مقالات مختارة
50 مهارة من Claude تستحق البناء في 2026
ابن مساعد ملاحظات خاص بالذكاء الاصطناعي
حوّل مجلد ملاحظات Markdown إلى مساعد بحث دون كشف المسودات الخاصة.
أتمتة استخراج بيانات الفواتير باستخدام OCR
ابن خط معالجة يقرأ الفواتير ويستخرج الحقول ويعلّم القيم غير المؤكدة للمراجعة.
التعليقات
0 تعليقاتلا توجد تعليقات معتمدة بعد. قد تنتظر الردود الجديدة المراجعة.